@swyx:很自豪@vibhuuuus和我与@eisokant一起做了最新一期播客,讨论NVIDIA为何刚支付给他60亿美元收购了难以置信的…
摘要
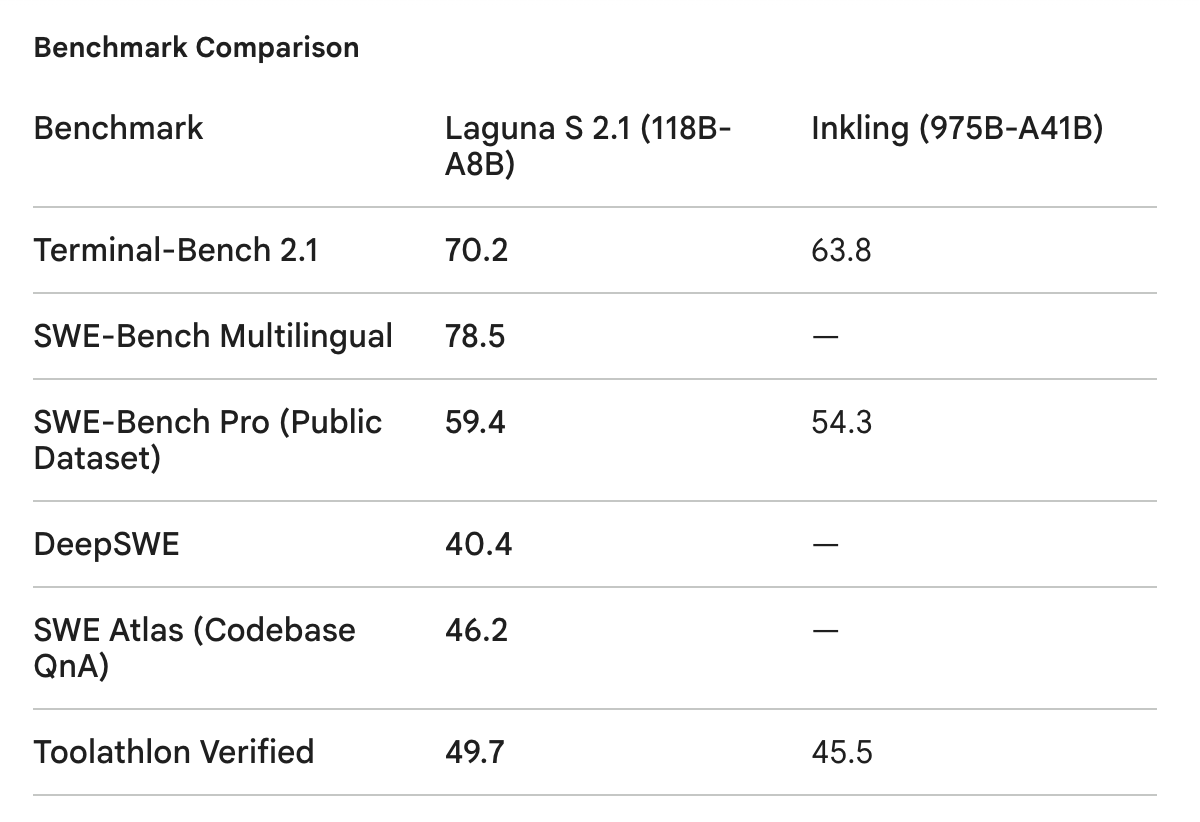
这期播客讨论了NVIDIA以60亿美元收购Poolside AI及其创新的‘模型工厂’方法,包括发布Laguna S 2.1模型,该模型与更大模型竞争。
查看缓存全文
缓存时间: 2026/08/21 01:01
很高兴 @vibhuuuus 和我与 @eisokant 最新录制了播客,探讨 NVIDIA 为何斥资 60 亿美元收购这家不可思议的模型工厂——它持续产出超越 Thinky 的模型(实际上并非夸张,可以查看数据)
欢迎收听/订阅/分享 https://latent.space/p/poolside
仅在 @latentspacepod 播出
探秘模型工厂 — Eiso Kant,Poolside AI
来源:https://www.latent.space/p/poolside 近几个月,关于模型所有权以及美国与中国(https://www.latent.space/p/ainews-kimi-k3-28t-a50b-the-largest)的开源与闭源之争,以及主权AI/本地化AI的讨论已趋白热化。因此,Poolside AI(https://x.com/poolsideai/status/2079613777343848465)终于携新模型登场,例如Laguna S 2.1(https://x.com/poolsideai/status/2079613777343848465),这实在是非常好的消息。该模型的表现超越了Thinking Machines近期发布的、规模几乎大其10倍的模型(https://www.latent.space/p/ainews-thinkys-inkling-975b-a41b)。
Poolside最近的技术报告(https://x.com/robert_mchardy/status/2059297942301782062)因其详尽程度而备受赞誉,Vibhu首先在我们的论文研讨会上报道了Laguna的最新技术报告:
X avatar for @eisokant Eiso Kant@eisokant (https://x.com/eisokant/status/2060097309396832432?s=20) 8:34 PM · May 28, 2026 · 11.3K Views
1 Reply · 8 Reposts · 47 Likes
从投入1200万美元构建代码语言模型,在世界尚未关注之时,到打造一座模型工厂,能将模型从预训练推进至发布仅需八周,Eiso Kant投入了十多年时间,押注代码是通往AGI的路径。在本期节目中,这位Poolside联合创始人将与swyx和Vibhu深入探讨:为何ChatGPT感觉像是迟来的正名,Poolside为何拥抱开源权重与开放研究,以及为何即使Poolside本身是五家公司之一,他也宁愿生活在一个拥有100家基础模型公司的世界,而非仅仅五家。
我们将深入探讨Poolside的模型工厂:支撑每月1万至2万次实验的工程系统、直接将数据流式传输至训练过程、可复现实验、低精度计算,以及越来越能编写代码、发起任务、评估结果并修改未来模型训练流程的智能体。Eiso还详细解读了他们最近发布的**Laguna S(https://poolside.ai/blog/introducing-laguna-s-2-1)**模型,探讨为何坚持性、验证和回溯可能比原始智能更重要,小模型中蕴含的能力潜力,为何强化学习将更早地融入预训练,以及为何逐词预测仍未能充分利用网络信息。
X avatar for @poolsideai Poolside@poolsideai 今天,我们发布了Laguna S 2.1,这是我们迄今为止最强大的模型。它是一个总参数为1180亿的专家混合模型,每个token激活80亿参数,上下文窗口高达100万token,并具备思考与非思考两种模式。其能力足以与规模大得多的模型抗衡 5:05 PM · Jul 21, 2026 · 656K Views 160 Replies · 320 Reposts · 2.18K Likes (https://x.com/poolsideai/status/2079613777343848465) 我们还探讨了模型与运行框架的协同设计,Poolside从编程智能体到AGI的路径,为何Eiso认为MCP和传统工具调用是“愚蠢的”,前沿模型训练背后的真实经济学,Poolside的5亿美元融资,开源人工智能,监管,NVIDIA与TSMC的影响力,智能体时代的工程生产力,高自主性团队,以及Poolside的招聘策略。
- Andrej Karpathy的RNN研究如何在2015年启发Eiso开始构建代码语言模型
- 为何Eiso在市场尚未关注时,投入四年时间和1200万美元追求一个想法
- 为何ChatGPT感觉像是正名,并让Poolside回归开源
- 为何Eiso更倾向于100家基础模型公司而非五家寡头垄断
- 发布开源权重与发表真正开放研究之间的区别
- 为何Poolside有意在湾区人才争夺战之外建立全球化研究组织
- 为何模型构建最终90%在于工程
- 模型工厂:Poolside用于快速训练和改进模型的端到端系统
- 如何由不到70名研究人员每月执行约1万至2万次实验
- Poolside如何从六个月模型周期转变为五周或八周的发布节奏
- 为何将数据直接流式传输至训练加速了实验进程
- 不可变数据、版本化代码与可复现性如何支撑严谨的模型研究
- 为何Eiso希望有能力的研究人员离开他们的实验室,成为Poolside的竞争对手
- 为何95%的模型构建可归结为更好的数据或计算效率
- Laguna S以及为何坚持、验证与回溯能胜过原始智能
- 为何小模型可能处理的知识工作远超预期
- 为何强化学习将更早地进入预训练
- 为何逐词预测仍未能充分从网络中提取足够知识
- 为何蒸馏和环境模拟已成为人工智能行业最热门的**“兴奋剂”**
- 为何中期训练实质上是课程设计的早期形式
- 低精度训练、网络瓶颈与计算效率的下一步提升
- Laguna S:1180亿总参数,80亿激活参数,从训练到发布仅需八周
- 为何模型构建者通常能在新检查点运行的前30分钟内完成评估
- 模型与运行框架:智能体能力的真正来源
- 为何Poolside将编程和长期软件任务视为通往AGI的路径
- 为何Eiso认为MCP和传统工具调用是“愚蠢的”
- 为何未来的智能体将编写脚本,而非从数十种预定义工具中选择
- 支持极简运行框架、容器化与模型自主性的论据
- 为何Poolside优先发展视觉能力,但不期望短期内涉足音频
- 为何语言可能是编码知识与推理最具计算效率的模态
- 模型开发的真正成本,以及为何最终的训练运行往往平淡无奇
- Poolside名称背后的故事,以及它如何代表拒绝降低抱负
- Poolside如何在投资者仍质疑AGI是否真实时筹集了5亿美元
- 为何智能可能成为世界上最受需求且高度商品化的资源
- 开源模型何时可能强大到无法不加限制地发布
- 为何单边AI安全在全球竞争环境中行不通
- 监管如何可能意外地固化两三家人工智能公司的寡头垄断
- NVIDIA、TSMC以及支撑基础模型进步的硬件系统
- 为何强化学习的墙钟时间是Poolside最大的瓶颈之一
- 为何Poolside选择从头训练模型,而非简单地蒸馏更大模型
- 人工智能如何改变公司衡量工程生产力的方式
- 为何自主性可能成为AI时代员工最重要的素质
- 领导者如何通过共同目标与明确约束来凝聚高自主性人才
- Poolside在研究、后训练、预训练、架构、评估和工程方面的招聘策略
**LinkedIn:**https://www.linkedin.com/in/eisokant
**X:**https://x.com/eisokant
**Poolside:**https://poolside.ai/
00:00:00 开场介绍
00:00:54 Karpathy、RNN与Transformer之前的代码模型构建
00:02:26 1200万美元的失败与ChatGPT的正名
00:03:39 开源与支持100家基础模型公司的理由
00:09:22 开放权重、开放研究与Poolside的全球团队
00:16:04 模型工厂:为何模型构建90%是工程
00:20:19 智能体、自动化实验与RSI的早期迹象
00:24:04 流式数据、可复现性与科学严谨性
00:30:35 创造更多基础模型公司
00:36:07 Laguna S:坚持性与原始智能
00:43:01 重塑预训练、强化学习与课程设计
00:52:33 低精度训练与从小模型中挖掘更多潜力
00:58:37 模型运行框架、编程智能体与AGI之路
01:09:26 为何MCP和传统工具调用是“愚蠢的”
01:13:04 视觉、多模态与语言的重要性
01:18:15 模型扩展与训练的真实经济学
01:20:40 Poolside为何如此命名及筹集5亿美元
01:27:37 开源模型、AI安全与寡头垄断风险
01:33:53 NVIDIA、TSMC与强化学习瓶颈
01:41:52 小模型、蒸馏、工程生产力与招聘
Swyx [00:00:00]: 好的,我们现在在工作室与Poolside的Eiso Kant以及Vibhu在一起。欢迎。
Eiso Kant [00:00:08]: 谢谢。谢谢邀请,很高兴来到这里。
Swyx [00:00:10]: 是的,刚下飞机。你发短信告诉我,“嘿,我在来旧金山的路上了。”我当时想,“你现在正在飞机上,对吧?” 嘿。
Eiso Kant [00:00:16]: 我知道。发完短信后我意识到,带着严重的时差过来,今天可能会有些有趣的体验,但我们还是开始吧。
Swyx [00:00:23]: 我想对嘉宾说的是,他们不必准备太多,因为如果你确实每天都在做这件事,那么即使是你模糊记得的内容,对于许多每天并不生活在你那个世界里的听众来说,也都是新鲜的,对吧?所以,十年前你在Google Slush做了一次关于AI民主化的演讲。而今天,你在这里,开源了一个令人惊叹的新模型,我们稍后会谈到。但我猜,是什么让你进入AI民主化领域的?从你的LinkedIn上看并不明显。
Eiso Kant [00:00:57]: 不,一点也不明显。我不认为人们很容易看出来我是如何进入这个领域的。我进入这个领域要感谢安德烈·卡帕西。
Eiso Kant [00:01:05]: 2015年,他写了一篇文章,叫做《循环神经网络的不凡效力》。
Swyx [00:01:10]: 神经网络,没错。
Eiso Kant [00:01:11]: 读了那篇文章后,我立即将当时的创业公司转向研究RNN,后来是LSTM和Transformer模型,目标是让机器能写代码。如果你点开这篇文章向下滚动,你就能看到,这是后来演变为语言模型的雏形。至少在他当时是字符级语言模型、开始预测字母的时候,他这里有一个例子。这里有一个小型的Paul Graham生成器,你可以读它,文本读起来通顺但又不完全通顺。还有一个稍往下一点的代码示例。是的,莎士比亚风格的。
Swyx [00:01:47]: 莎士比亚。
Swyx [00:01:49]: 酷。
Eiso Kant [00:01:49]: 不知为何,我读了这篇文章,就一头扎进了学习关于RNN和LSTM所有知识的兔子洞,对吧?这是Transformer论文。当时我建立了一个完全不合理的信念:神经网络应该能够泛化到任何事物,语言应该能够泛化到许多智能行为以及编写代码的能力。于是我开始构建Sourced,这是一家完全开源的公司,试图构建我们当时称为“代码上的机器学习”、“代码上的语言模型”的东西。我们花了大约四五年时间,一直到2019年底。今天听起来很酷,但当时,没人在乎。
Eiso Kant [00:02:29]: 对吧?没人在乎。我们处于黑暗中。我们一路尝试了各种方法,比如将卷积神经网络应用于代码结构。当注意力机制出现时,我们将其应用于LSTM,然后Transformer论文出来了。这——这并不明显,在我们整个历程中,我们一直走在正确的道路上,但我们本应该坚持扩大规模。如今,对我们所有人来说,规模定律和扩大规模似乎是最显而易见的事情。但在我花费四五年时间研究代码语言模型之后,这并非显而易见。所以我非常尊重谷歌、OpenAI以及其他公司的同行们,他们怀揣着那份信心坚持了下来。我们最终在当时失败了,这可以说是职业生涯中最大的失败,对吧?你烧掉了投资人1200万美元,当时那是一大笔钱。
Swyx [00:03:18]: 是的。
Eiso Kant [00:03:19]: 你花费了,现在看仍然很多,但,你和大约40人的团队花了数年时间痴迷于这个问题。生活转向了不同的方向,家庭成为了重心,我埋头苦干,在接下来的两年里确实没有再关注语言模型。考虑到接下来的几年会非常有趣,这是个大错误。然后ChatGPT发布了,那感觉就像是一种正名。人们开始给我发短信。我发现,我找到了一些旧的演示文稿和演讲。在整个历程中,我们
Eiso Kant [00:03:56]: 当时我们有一个强烈的观点,那就是,当你构建更强大的智能时,它应该是开放的、开源的。
Eiso Kant [00:04:04]: 当我们创立Poolside时,情况完全不同,我想坦诚地说。当我们创立Poolside时,我们基于两个前提。第一,这项技术的能力复合增长不会停止。我认为对大多数人来说今天这很明显,但在我们创立之初的三年多前,大多数人还在争论它们是否只是随机鹦鹉。
Eiso Kant [00:04:23]: 第二是强化学习将成为大语言模型能力的最大驱动力。今天,这非常明显。三年前,OpenAI、谷歌、Anthropic或其他公司并未普遍持有这一观点或方向。所以当时有些人看不起我们。他们在想,“这真的能行吗?”于是我们开始埋头解决问题,再也没有过多考虑开源。我们只是埋头构建我们从零开始的知识和理解,对吧?我们不是从现有实验室出来的。所以我们研读论文,开始写代码,摸索前行。
Eiso Kant [00:04:59]: 直到今年年初,我和我的联合创始人Jason才重新拾起关于开源的讨论。
Eiso Kant [00:05:07]: 如果你回顾我们网站上早期的内容,非常直接:我们希望实现AGI,我们希望支持一个富足的世界,我们希望成为第一个实现这一目标的公司。
Eiso Kant [00:05:20]: 但我们在今年年初开始讨论,因为世界正朝着一个开始让我们有点担忧的方向发展,这变得显而易见。这并非一夜之间发生。我们看到一点苗头,然后想,“好吧,世界正在走向一条特定的道路。” 在整个历程中,我常用一个类比或事物。我说,如果我回到那些年份,2015或2016年,我们正在做这件事,我从书架上拿起一本关于2035年的小说阅读,书中描述在未来的几十年里实现了AGI。它会有第一章,每个人都在努力摸索。你会看到ChatGPT发布那一章,然后你会来到世界处于十字路口的章节,而它选择的道路是未来只有三、四家或少数几家公司将创造所有的智能。
相似文章
Poolside AI与Nvidia达成价值60亿美元的非独家许可协议(阅读时长1分钟)
Poolside AI与Nvidia达成了价值60亿美元的非独家许可协议,并以120亿美元的投前估值获得了10亿美元投资,其中109名员工可能加入Nvidia,而创始人将继续留任。
@rohanpaul_ai: 为什么Nvidia不直接销售令牌 "Jensen真的很擅长让他的朋友们成为亿万富翁。" - Neil Movva, 联合创始人…
文章讨论了Nvidia决定不直接销售令牌,引用了Neil Movva关于Jensen Huang在人工智能行业商业敏锐度的引言。
@TechCrunch:像@nvidia这样的科技巨头并不总是具备打造下一波创新技术的具体能力,但它们拥有…
TechCrunch的Build Mode播客邀请了Nvidia全球VC合作负责人Sydney Sykes,讨论初创公司如何进入Nvidia生态系统以及企业风险投资的动态。
@FoundersPodcast: 这是一集非常特别的节目。这是Jonathan首次公开讨论他与Nvidia价值200亿美元的交易。我……
宣布一期播客节目,嘉宾是Groq创始人Jonathan Ross,他讨论了与NVIDIA的200亿美元合作以及他打造Groq的十年历程。
Nvidia与Poolside交易,以竞争中国的开放权重模型
Nvidia已对Poolside进行了重大投资并达成许可协议,涉及10亿美元投资和60亿美元支付,超过100名工程师将加入Nvidia从事Nemotron项目。