加速离核洗牌
摘要
这篇博客文章介绍了RapidsMPF,这是一个可复用的离核洗牌器,能够实现1.8 TiB/s的高速数据洗牌,解决了分布式数据分析中的内存和性能挑战。
暂无内容
查看缓存全文
缓存时间: 2026/09/27 13:38
# 使用 RapidsMPF 的核外数据混洗 - Benjamin Zaitlen
来源:https://quasiben.github.io/blog/ooc-shuffling-rapidsmpf/
**数据混洗速度达 1.8 TiB/s!RapidsMPF 是一个可复用的核外混洗器,它将令人头疼的 OOM 数据混洗转变为可预估的溢出。**
数据混洗是结构化数据分析(无论是分布式还是单机)的关键所在。它是连接(join)、分组(groupby)、合并(merge)、排序(sort)等核心数据操作的关键组成部分。一次完全的分布式混洗会将所有数据从每个进程移动到所有其他进程,即“全对全”通信。这代价高昂,因此已开发出多种复杂技术以尽可能*避免*此操作。
混洗本身在计算上并不具有挑战性:计算哈希值来路由数据相当廉价。然而,它们在工作流中依然昂贵,原因多种多样:
1. **内存密集**:混洗可能需要持有所有数据的完整副本,或者在流式场景中,内存压力会不断累积并导致 OOM。
2. **传输**:数据必须从进程 A 物理移动到进程 B(或节点 A 到节点 B),因此其速度受限于传输层。
3. **同步**:在所有生产者完成数据贡献之前,输出数据无法被消费。在批量同步引擎中,这个屏障会阻塞整个执行计划。
因为数据混洗困难、缓慢、内存消耗大且至关重要,它历来是 RapidsMPF 的起点。
## 为什么连接(Join)需要混洗?
(https://quasiben.github.io/blog/ooc-shuffling-rapidsmpf/#why-do-joins-need-shuffles)
一个关于连接表的快速入门。假设我们有两个表 `partsupp` 和 `lineitem`,并希望将它们连接起来,会发生什么?
```python
partsupp.join(
lineitem,
left_on=["ps_partkey", "ps_suppkey"],
right_on=["l_partkey", "l_suppkey"],
)
# 或者
SELECT * FROM partsupp
JOIN lineitem
ON partsupp.ps_partkey = lineitem.l_partkey
AND partsupp.ps_suppkey = lineitem.l_suppkey
```
### 内存连接
(https://quasiben.github.io/blog/ooc-shuffling-rapidsmpf/#in-memory-joins)
内连接由两个阶段组成:
1. **构建阶段**:扫描较小的表 (`partsupp`),并在连接键 `(ps_partkey, ps_suppkey)` 上构建一个哈希表,将每个哈希键映射到其来源行。在探测阶段开始前,此哈希表必须完全填充。
2. **探测阶段**:扫描较大的表 (`lineitem`),并对每一行的键 `(l_partkey, l_suppkey)` 进行哈希计算。构建表和探测表连接键的哈希值之间的匹配会输出一个组合了两个表列的结果行。没有匹配的行将被丢弃(技术上,这里还涉及哈希冲突处理,但暂时忽略)。
*注意:左连接、右连接和全外连接使用相同的构建/探测策略,但对未匹配行的处理规则不同。*
至少,这种内存连接需要同时保存*三张*表:构建表、探测表、输出表,*以及*在构建侧构建的哈希表。
### 分布式连接
(https://quasiben.github.io/blog/ooc-shuffling-rapidsmpf/#distributed-join)
在内存场景中,所有数据已经位于同一内存空间内。但当表分布在多个进程/节点/秩(rank)之间,或者表被批处理以进行“流式”连接时,情况就不再如此。一个秩/进程只能连接其内存中驻留的行。最终会进行内存连接,但首先我们需要将构建表和探测表的所有匹配键放到同一个秩上。
下面的示意图展示了相同颜色的行如何被混洗到同一个输出分区,而这些分区位于不同的秩上。
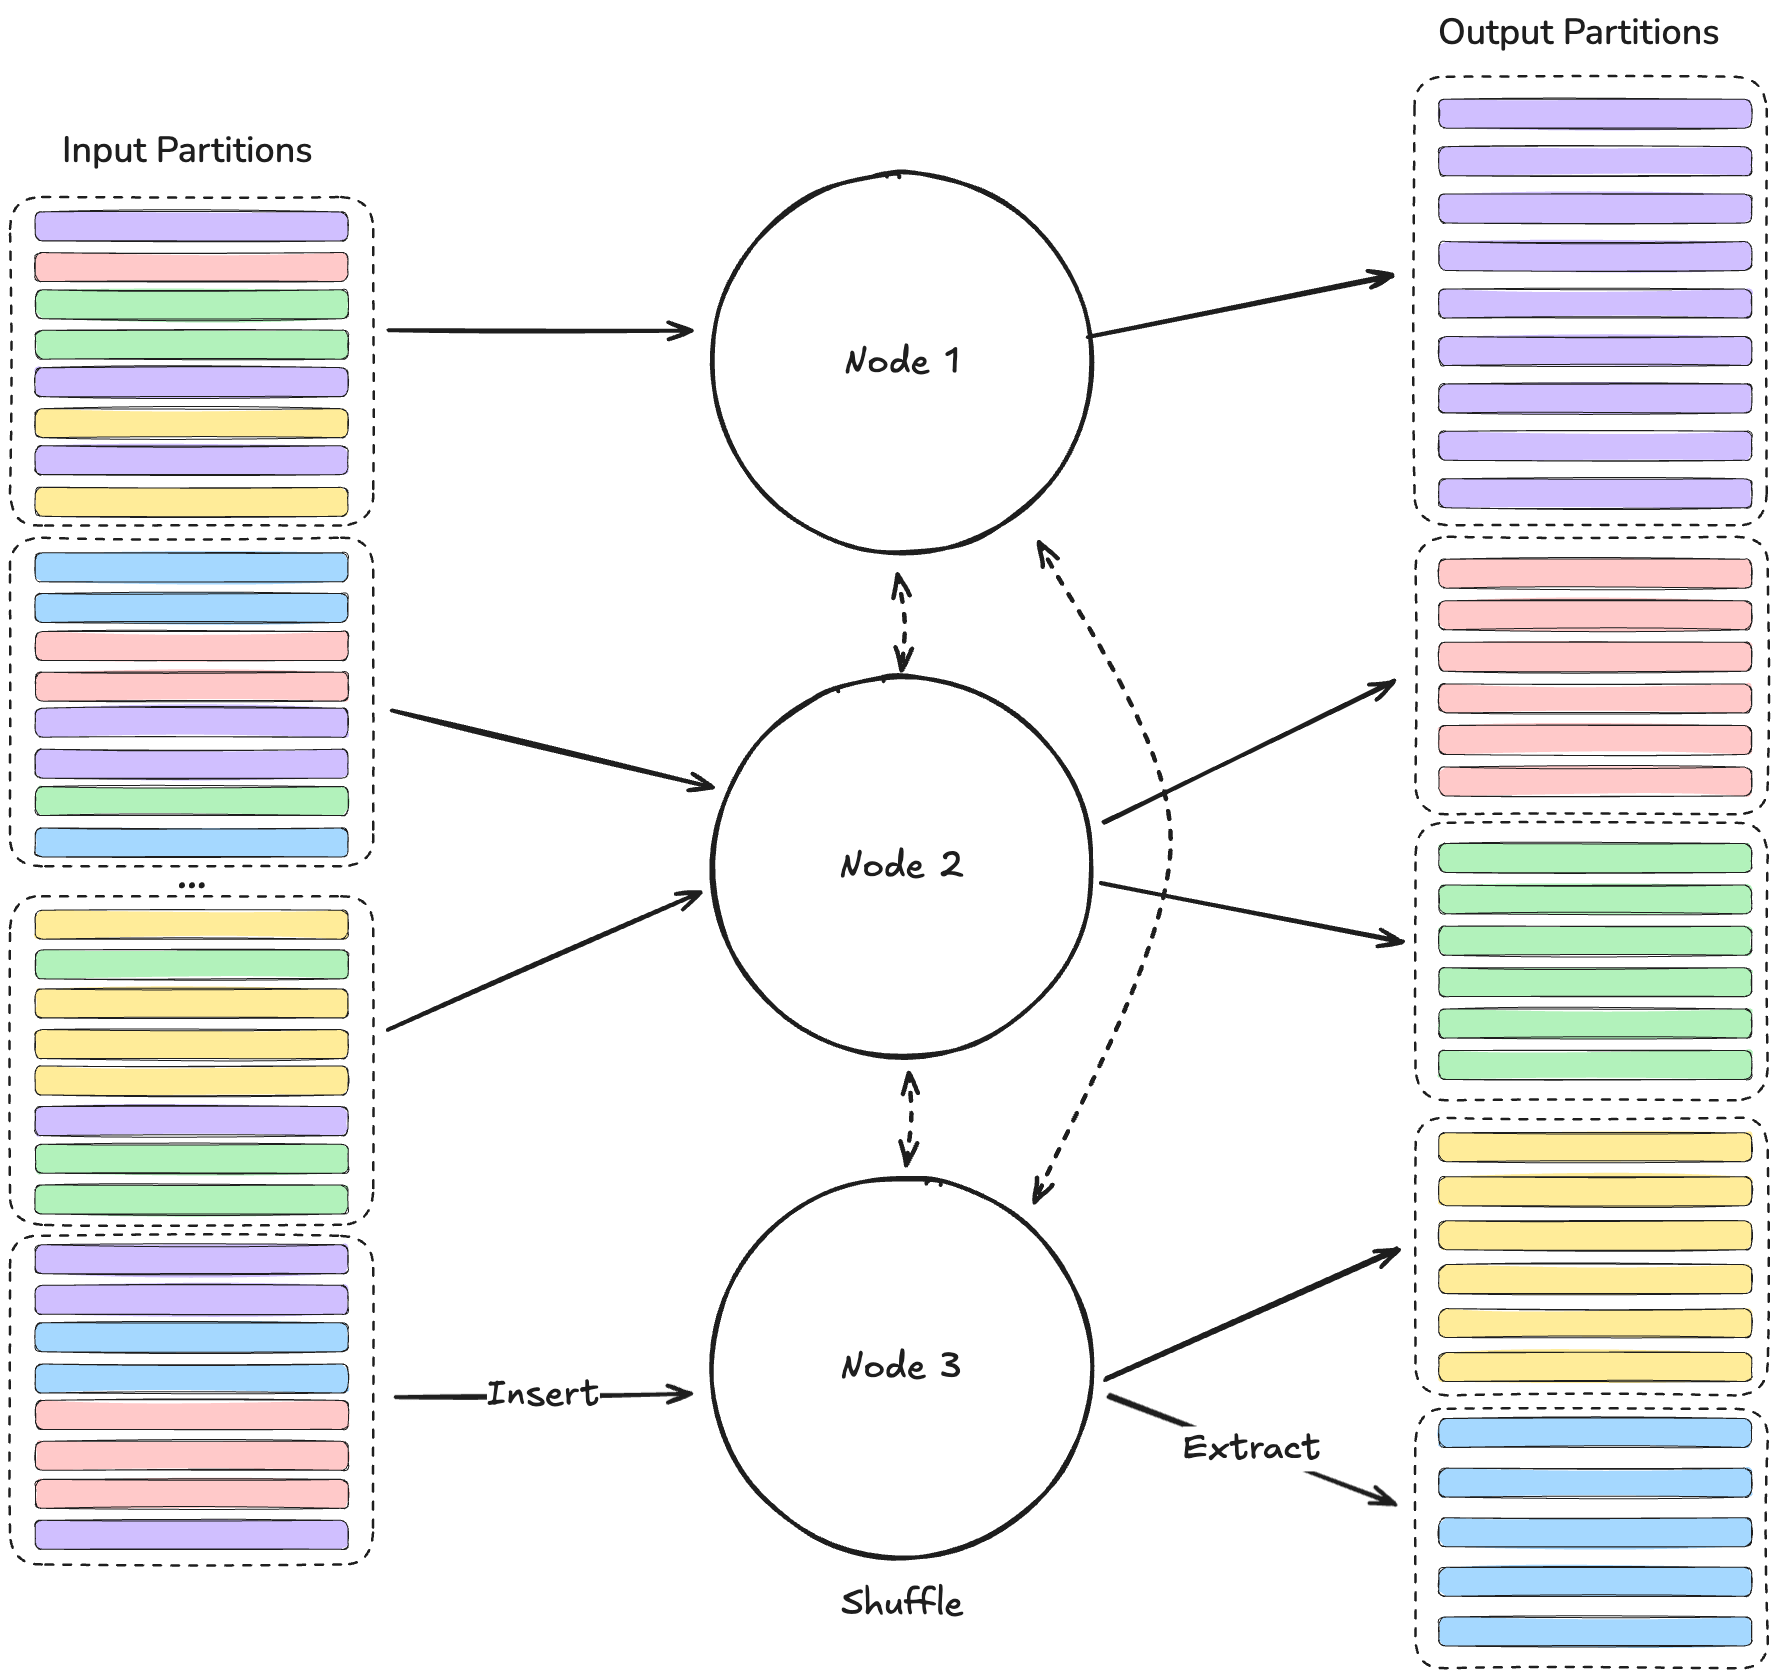
要执行一次分布式哈希连接,必须执行以下步骤:
1. 扫描构建表,对每一行的连接键进行哈希以选择目标分区,`hash(keys) % n_out_partitions`。将每一行打包并发送到将拥有它的秩。
2. 以相同方式扫描探测表并路由行,使探测键落到已拥有相同哈希构建键的秩上。
3. 等待每个秩完成发送。只有这时,一个秩才能保证拥有其负责的所有键的、来自两个表的所有行。
4. 在每个秩的本地数据切片上运行上述内存连接:为其构建行构建哈希表,用其探测行进行探测,输出匹配项。
在最坏情况下,如果每个阶段都在下一个阶段开始前完全物化,一个秩将同时持有以下所有内容:
1. 构建表(源扫描)
2. 探测表(源扫描)
3. 暂存的构建表(为发送而打包)
4. 暂存的探测表(为发送而打包)
5. 混洗后的构建切片(已接收)
6. 混洗后的探测切片(已接收)
7. 构建切片上的哈希表
8. 输出表
这就是为什么数据混洗是内存密集型而非计算密集型。哈希计算本身成本低廉,这也是为什么在着手构建 ETL 引擎时,核外混洗实现应是首要关注点的原因。此外,能够流式传输数据,而不是在混洗前完全物化表,对于降低内存压力至关重要。
基于这些原因,我们启动 RapidsMPF 的初衷就是构建一个流式核外混洗器。
## RapidsMPF
(https://quasiben.github.io/blog/ooc-shuffling-rapidsmpf/#rapidsmpf)
RapidsMPF 自其最初概念以来已经扩展。它现在是一个由两大部分组成的库:
1. 一个专为溢出/核外内存处理设计的混洗库,具有加速传输功能。
2. 用于构建流式数据管道的执行器网络。
今天,用户仍然可以*仅*采用 RapidsMPF 的混洗组件(C++ 或 Python 接口)。我们已经看到这种采用出现在 [NeMo-Curator](https://github.com/NVIDIA-NeMo/Curator/blob/15bcdef495246dc98da41954f3a6fb4cc0030a8c/nemo_curator/stages/deduplication/shuffle_utils/rapidsmpf_shuffler.py#L65) 中,并且在实验阶段也出现在 [Ray Data](https://github.com/ray-project/ray/blob/90b5e6b993b3fd96f89fd8a2cacf9f3230f4dd7c/python/ray/data/_internal/gpu_shuffle/hash_aggregate.py#L1484) 中。
最重要的是,[cuDF Polars](https://docs.nvidia.com/cudf/latest/cudf_polars/) 同时使用 RapidsMPF 进行混洗*和*执行器网络。在后续文章中,我们可以深入探讨执行器网络,或者如果你现在好奇,我推荐阅读关于[流式引擎](https://docs.nvidia.com/rapidsmpf/latest/background/streaming-engine/)的部分。
我们的混洗实现需要:
1. 快速
2. 可扩展
3. 能处理超出显存(VRAM/GPU)容量的数据(核外)
4. 可复用
在本文的其余部分,我们将重点关注内存压力下的混洗。
### 基准测试设置
(https://quasiben.github.io/blog/ooc-shuffling-rapidsmpf/#benchmarking-setup)
cuDF/RapidsMPF 有一个易于使用的 C++ 基准测试:[`bench_shuffle`](https://github.com/NVIDIA/cudf/blob/9e8e79962d7ced863e209f49da466a23ec0c5819/cpp/libcudf_streaming/benchmarks/bench_shuffle.cpp),它帮助我们研究 RapidsMPF 混洗实现如何在各种硬件(传输层、GPU 数量等)以及各种配置(如输入/输出分区大小、内存资源等)下工作。
以下是当前 `bench_shuffle` 测试向用户暴露的完整参数分解,以及我在本文中使用的值。通常,此基准测试在每个秩(每个 GPU)上构建可调节数量的随机 32 位(4 字节)整数,混洗所有数据并完成(这里没有连接,只有混洗)。
| 标志 | 含义 | 本文使用的值 |
| :--- | :--- | :--- |
| `-C` | 通信器 | `ucxx` |
| `-c` | 列数 | `10` |
| `-r` | 计时运行次数 | `10` |
| `-w` | 预热运行次数 | `3` |
| `-n` | 每个秩的行数 | `536870912` (每列 2 GiB,按每行 4 字节计算) |
| `-p` | 每个秩的输入分区数 | `1` |
| `-o` | 每个秩的输出分区数 | `8` (每个秩一个) |
| `-m` | RMM 内存资源 | `pool` |
| `-l` | 设备内存限制(MiB) | 省略 = 无限制(二进制默认值 `-1`);在溢出测试中从 `32768` 下降到 `12288` |
| `-s` | 启用输出丢弃(模拟流式传输) | 标志,始终设置 |
| `-x` | 启用内存分析 | 标志,始终设置 |
| `-g` | 使用预分区的输入表 | 标志,始终设置 |
对于所有测试,我们将使用单个 DGX B200,并使用 [`rrun`](https://github.com/rapidsai/rapidsmpf/tree/2d9a3f2876174514086e780929f6c4d4976c0d2c/cpp/tools)(一个类似 mpi 的多进程启动工具,能够将进程绑定到 NUMA 节点)来启动混洗。
### 简单混洗
(https://quasiben.github.io/blog/ooc-shuffling-rapidsmpf/#simple-shuffling)
一台 [DGX B200](https://www.nvidia.com/en-us/data-center/dgx-b200/) 拥有 8 个 Blackwell GPU,每个 GPU 有 180GB 显存,以及 2 个 Intel® Xeon® Platinum 8570 处理器。为了建立基线,我们将首先混洗能舒适地容纳在所有 GPU 上的数据。
```bash
rrun -n 8 --bind-to cpu --bind-to memory -x UCX_MAX_RNDV_RAILS=1 -x UCX_PROTO_ENABLE=y -x UCX_WARN_UNUSED_ENV_VARS=n libcudf_streaming_bench_shuffle -C ucxx -w 3 -r 10 -m pool -g -s -x -p 1 -o 8 -c 10 -n 536870912
```
在这里,我们*预热*基准测试 3 次,然后*运行*基准测试 10 次。有 536,870,912 行(`-n`),10 列(`-c`),每个秩 1 个输入分区(`-p`),数据将被混洗到 8 个输出分区(`-o`)。我们还使用 [UCXX](https://github.com/rapidsai/ucxx) / [UCX](https://openucx.org/) 来启用加速传输/GPUDirect RDMA。
> 536,870,912 行 * 4 字节(32 位整数)= 每列 2 GiB
> 10 列 * 2 GiB = 20 GiB / 秩
> 8 个秩 * 20 GiB = 总计 160 GiB
```
# 20GiB/秩的示例输出
[6:PRINT:0:2026-09-16 02:09:53.934930934] elapsed: 17.91 s | local throughput: 1.12 GiB/s | global throughput: 8.93 GiB/s (warmup run)
[5:PRINT:0:2026-09-16 02:09:53.935046244] elapsed: 17.91 s | local throughput: 1.12 GiB/s | global throughput: 8.93 GiB/s (warmup run)
[4:PRINT:0:2026-09-16 02:09:54.072443638] elapsed: 94.58 ms | local throughput: 211.47 GiB/s | global throughput: 1.65 TiB/s (warmup run)
[2:PRINT:0:2026-09-16 02:09:54.072450366] elapsed: 89.15 ms | local throughput: 224.35 GiB/s | global throughput: 1.75 TiB/s (warmup run)
[0:PRINT:0:2026-09-16 02:09:54.328272061] elapsed: 86.89 ms | local throughput: 230.19 GiB/s | global throughput: 1.80 TiB/s
[1:PRINT:0:2026-09-16 02:09:54.328286361] elapsed: 85.38 ms | local throughput: 234.25 GiB/s | global throughput: 1.83 TiB/s
[7:PRINT:0:2026-09-16 02:09:54.328417037] elapsed: 84.58 ms | local throughput: 236.47 GiB/s | global throughput: 1.85 TiB/s
[4:PRINT:0:2026-09-16 02:09:54.328429082] elapsed: 85.15 ms | local throughput: 234.87 GiB/s | global throughput: 1.83 TiB/s
[2:PRINT:0:2026-09-16 02:09:54.328554677] elapsed: 86.28 ms | local throughput: 231.80 GiB/s | global throughput: 1.81 TiB/s
```
每个秩会输出它花费的混洗时间以及本地和全局吞吐量。我们已经可以观察到,预热运行有一定开销,其速度慢于“正式”运行。最后,程序会返回每个秩的本地/全局吞吐量平均值,以及每个秩时间花费的汇总统计:混洗时间、内存分配时间、溢出时间(如有)等。
> **注意**:全局吞吐量因秩而异,这在技术上是不正确的,是一个报告错误。基准测试不是将所有秩的本地吞吐量相加,而是将每个秩的本地吞吐量乘以秩数来报告全局吞吐量。在 DGX B200 上,这是 8 * 本地吞吐量。在解决此错误之前,这暂时足够使用。
```
[0:PRINT:0:2026-09-16 02:09:55.476576210] means: 87.06 ms | local throughput: 229.74 GiB/s | global throughput: 1.79 TiB/s | in_parts: 1 | out_parts: 8 | nranks: 8 | device memory peak: 60 GiB | device memory total
[0:PRINT:0:2026-09-16 02:09:55.476629379] Statistics (of the last run):
- alloc-device: 17.50 GiB | 1.73 ms | 9.90 TiB/s | avg-stream-delay 213.98 us
- event-loop-total: 3.44 ms | avg 2.29 us
- metadata-payload-exchange-complete-data-transfers: 518.71 us | avg 345.80 ns
- metadata-payload-exchange-progress: 2.35 ms | avg 1.57 us
- metadata-payload-exchange-receive-metadata: 558.98 us | avg 372.65 ns
- metadata-payload-exchange-send-messages: 557.40 us
- metadata-payload-exchange-setup-data-receives: 617.31 us | avg 411.54 ns
- shuffle-payload-recv: 17.50 GiB | avg 319.95 MiB
- shuffle-payload-send: 17.50 GiB | avg 320.01 MiB
Memory Profiling ----------------
Legends:
ncalls - number of times the scope was executed.
peak - peak memory usage by the scope.
g-peak - global peak memory usage during the scope's execution.
accum - total accumulated memory allocations by the scope.
max - largest single allocation by the scope.
Ordered by: peak (descending)
ncalls peak g-peak accum max filename:lineno(name)
1 60 GiB 60 GiB 1.29 TiB 2 GiB main (all allocations using RmmResourceAdaptor)
1 40 GiB 40 GiB 44.06 GiB 2 GiB /libcudf_streaming/src/partition_utils.cpp:183(partition_and_pack)
1 20 GiB 20 GiB 20 GiB 320.39 MiB /libcudf_streaming/src/partition_utils.cpp:242(split_and_pack)
8 2.50 GiB 2.50 GiB 20 GiB 256.12 MiB /libcudf_streaming/src/partition_utils.cpp:298(unpack_and_concat)
1 0 B 0 B 0 B 0 B /libcudf_streaming/benchmarks/bench_shuffle.cpp:277(shuffling)
4 5 GiB 5 GiB 20 GiB 512.17 MiB /libcudf_streaming/src/partition_utils.cpp:136(unpack_and_concat)
1 0 B 0 B 0 B 0 B /libcudf_streaming/benchmarks/bench_shuffle.cpp:276(shuffling)
```
在上面的内容中,只提供了秩 0 的信息,但秩 1-7 的情况非常相似。秩的完成时间略有不同,吞吐量也有微小但可测量的差异。考虑到我们有八个 GPU 总共 1,440 GB 显存,RapidsMPF 有足够的空间进行混洗而无需溢出。
在上述配置中,RapidsMPF 的全局吞吐量约为 **1.8 TiB/s**。我们仍未达到 [理论上限](https://resources.nvidia.com/en-us-dgx-systems/dgx-b200-datasheet?ncid=no-ncid&_gl=1*1r7pck2*_gcl_au*MzY0MTM5NDA2LjE3ODQxNjcwODIuLS4tLjE3ODQ5MTg2MjQuNjkyNDk3MzIuMTc4OTUyNjczNS4xNzg5NTYwMjk4) 14.4 TB/s,但这已经非常快了!
内存配置文件值得深入研究,因为它将帮助我们理解后续的溢出情况。每个秩仅持有 20 GiB 的输入数据,但峰值设备使用量为 **60 GiB**,是输入的 3 倍。配置文件准确显示了内存去向:20 GiB 用于输入本身,40 GiB 用于 `partition_and_pack`(此时输入被哈希并复制到按目标划分的缓冲区中)。在一次混洗中,程序可能暂时同时拥有本地数据的原始副本和复制副本;这是一个很好的例证,说明为什么我们需要在管道的所有阶段深入思考内存管理。
当混洗是工作流的必需部分时,数据以各种不同的分区大小、形状和类型进入,而 GPU 的显存容量也各不相同。因此,我们应该预期随着数据形状和大小以及整体工作流的变化,吞吐量会发生变化。目前,我们将继续使用相同的设置:单个 20GiB 输入分区。
## 糟糕,你溢出了一点...
(https://quasiben.github.io/blog/ooc-shuffling-rapidsmpf/#oops-you-spilled-a-little)
每个秩将用 20 GiB 数据初始化,然后进行混洗。然而,我们将通过*降低*设备限制(从无限制降低到 12 GiB)来持续*增加*内存压力。我们将观察到的是,不仅没有发生 OOM,RapidsMPF 也没有因设备和主机之间不必要数据的来回移动而性能抖动。
> **注意**:我们并非要让这个特定系统面临 OOM 风险。相反,我们将设置限制为每个秩 20 GiB 数据,因为我想快速模拟和探究当系统*面临* OOM 风险时会发生什么。
让我们向基准测试施加一些人为的内存压力,并将设备限制为 32GB:`-l 32768`,看看会发生什么:
```
[7:PRINT:0:2026-09-16 02:10:59.613588706] means: 335.15 ms | local throughput: 59.67 GiB/s | global throughput: 477.39 GiB/s | in_parts: 1 | out_parts: 8 | nranks: 8 | device memory peak: 32.00 GiB | device memory total
[7:PRINT:0:2026-09-16 02:10:59.613657226] Statistics (of the last run):
- alloc-device: 13.50 GiB | 301.02 ms | 44.86 GiB/s | avg-stream-delay 747.00 us
- event-loop-total: 6.41 ms | avg 4.27 us
- metadata-payload-exchange-complete-data-transfers: 545.14 us | avg 363.43 ns
- metadata-payload-exchange-progress: 3.31 ms | avg 2.21 us
- metadata-payload-exchange-receive-metadata: 618.16 us | avg 412.11 ns
- metadata-payload-exchange-send-messages: 561.92 us
- metadata-payload-exchange-setup-data-receives: 580.90 us | avg 387.27 ns
- shuffle-payload-recv: 14.00 GiB | avg 358.97 MiB
- shuffle-payload-send: 14.00 GiB | avg 358.97 MiB
- spill-to-device-memory: 6.00 GiB | 3.09 ms | avg 2.00 GiB
- spill-to-host-memory: 6.00 GiB | 297.59 ms | avg 20.16 MiB
```
等等,吞吐量从 1.8 TiB/s 下降到了 477 GiB/s?是的,这是预期的。但请注意,没有 OOM!我们有 20 GiB 输入,峰值使用量为 32 GiB(等于限制),并且有 12 GiB 数据被溢出。关键点在于:
1. **没有 OOM**:RapidsMPF 成功管理了内存压力,避免了崩溃。
2. **无抖动**:溢出被高效管理;系统没有进入设备和主机之间反复交换数据的“抖动”状态。性能下降是由于数据溢出到主机内存造成的,而不是由于低效的内存管理。
3. **可预测的性能下降**:我们向系统施加了限制,性能下降了,但系统仍然正常运行并完成了工作。这就是为什么我们在标题中提到“你可以预算溢出”。你可以根据可用内存和数据大小来预估溢出量及其对性能的影响。
从统计数据中可以看到,有 6 GiB 被溢出到设备内存池(`spill-to-device-memory`),还有 6 GiB 被溢出到主机内存(`spill-to-host-memory`)。主机内存溢出耗时较长(约 300ms),而设备内存溢出很快(约 3ms),这解释了吞吐量下降的主要原因。
RapidsMPF 的内存管理器(基于 RMM)能够智能地决定将数据溢出到何处(设备内存池还是主机内存),以最大限度地减少性能影响。在本例中,它优先将部分数据溢出到仍在同一设备上的可用内存池,只有当设备内存耗尽时才溢出到主机内存。
这个演示展示了 RapidsMPF 的核心价值之一:**将 OOM 崩溃转变为可管理的、可预测的性能降级**。在实际生产环境中,数据规模经常超过单个 GPU 的容量,一个健壮的核外混洗器是确保工作流能够完成的关键。
相似文章
在两个独立云区域通过公共WAN使用推测解码+CUDA图实现Qwen2.5-7B上28 TPS [P]
分布式LLM推理框架ShardFlow通过推测解码与CUDA图缓解WAN延迟,在云区域间对Qwen2.5-7B实现28 TPS。
D-Matrix Raptor 3D-DRAM 加速器:面向 Hot Chips 2026 的生成式推断
D-Matrix 在 Hot Chips 2026 上展示了其 Raptor 3D-DRAM 加速器,该加速器通过直接将计算单元堆叠在 DRAM 晶圆上,解决了生成式 AI 推断中的内存容量和带宽挑战。
RED-PIM: 使用处理内存减少Transformer的数据移动
提出了RED-PIM,一种算法-架构协同设计,将内存体间的数据移动从O(N²)降低到O(N),并缩小注意力矩阵,使Transformer模型的推理时间显著降低(16%到99.99%)。
超越静态RAG:一种用于商品GPU上高效长上下文推理的自适应三元度量路由框架
本文提出一种三元度量路由器,这是一种确定性框架,用于推理管道之间的自适应路由,以解决商品GPU上长上下文RAG中的压缩悖论,实现零OOM故障并提升性能。
RAMPART:基于注册表的智能体记忆系统,具备优先级感知的运行时转换能力
RAMPART 是一种面向基于 LLM 的智能体的编译期内存模型和纯内存块注册表,通过五种可组合的原语管理上下文组装,支持优先级排序与淘汰策略。在多个 7B 至 14B 参数规模模型上的实验表明,块分组、相关性门控和模式淘汰能够显著提升任务成功率并降低提示词 token 开销。