@ajassy:处理数据时一直很痛苦的一点是,实时数据和历史数据一直被分隔在不同的……
摘要
Amazon Aurora PostgreSQL 现已内嵌 DuckDB,用户可直接对实时业务数据以及存储在 S3 数据湖中、采用 Apache Iceberg 和 Parquet 格式的历史数据进行查询,无需 ETL 管道,也无需数据复制。
查看缓存全文
缓存时间: 2026/10/01 04:14
处理数据时有一个长期存在的痛点:实时数据与历史数据被割裂在不同的系统里——客户刚刚下的订单存放在你的数据库中,而他们过去五年的订单则躺在 S3 的数据湖里。要回答一个真实的问题,通常两者缺一不可(这笔购买对他们来说是否正常,还是应该标记出来?),而要做到这一点,你必须先把数据搬到一起:把历史数据从数据湖拷进数据库(或者反过来),因为数据库读不到它所在位置的数据。这意味着你得提前猜测将来会需要哪些数据、为它们全部保留一份副本、搭建管道来搬运数据,并且不断同步,以免两边的数据出现偏差。大量的管道工程,进展缓慢,而这还只是回答一个问题之前的铺垫。即便如此,得到的答案也只能跟你上次同步时一样新。
这一现状即将随着 Aurora PostgreSQL 而改变:它可以在一条查询里同时调用你的实时数据和 S3 中的历史数据。无需复制,也不需要维护保持同步的管道。而且速度很快,因为我们在其中内置了 DuckDB——一个很擅长在数据原地读取和分析数据的热门开源引擎。DuckDB 直接读取已经存在于你数据湖中的 Parquet、Iceberg 等开放格式,因此无需任何转换或搬运。
随着开发者把 AI agent 构建到应用中,agent 所需的数据将取决于它面前的具体任务。能够实时查询那份特定数据,而不是“以防万一”地把它复制过来,对开发者来说将是一个巨大的帮助。
https://aws.amazon.com/blogs/aws/amazon-aurora-postgresql-now-supports-direct-querying-of-apache-iceberg-and-parquet-data-in-your-data-lake/…
Amazon Aurora PostgreSQL 现已支持直接查询数据湖中的 Apache Iceberg 和 Parquet 数据 | Amazon Web Services
来源:https://aws.amazon.com/blogs/aws/amazon-aurora-postgresql-now-supports-direct-querying-of-apache-iceberg-and-parquet-data-in-your-data-lake/
AWS News Blog (https://aws.amazon.com/blogs/aws/)
Voiced by Polly (https://aws.amazon.com/polly/)
今天,我们宣布推出 Amazon Aurora PostgreSQL (https://aws.amazon.com/rds/aurora/) 的一项新能力:你可以使用现有的 PostgreSQL 应用程序和工具,将运营数据与数据湖中以 Apache Iceberg 和 Apache Parquet 格式存储的数据一起直接查询。通过消除将结构化数据从数据湖抽取、转换并加载(ETL)到运营数据库的需要,你可以降低运维复杂度并简化应用开发。你还可以使用 Aurora PostgreSQL 查询由兼容 Iceberg REST Catalog(IRC)的数据目录所管理的数据湖数据,从而在不移动或复制数据的情况下访问各类分析系统的数据。
无论你是要驱动实时仪表盘、用历史上下文丰富交易数据,还是构建能够同时基于实时数据和归档数据进行推理的 AI agent,如今都可以通过单一的熟悉界面完成所有这些工作。
此前,如果应用需要将 Aurora 中的近期事务数据与存储在 Amazon S3 中的历史记录结合起来,常见的做法是构建反向 ETL 管道,这会复制数据、增加基础设施成本,并且需要持续的工程投入来保持一切同步。随着 AI agent 越来越多地嵌入应用中,这一难题只会进一步加剧——要预测并预先复制 agent 可能需要的每一个数据集,是不现实的。
DuckLabs 是维护 DuckDB 项目的团队,他们近期加入了 Amazon,而这项能力正是 DuckDB 的效率被整合进我们服务的一个例子。DuckDB 现在已直接嵌入 Aurora PostgreSQL,你可以在一条查询中同时查询实时运营数据(包括尚未提交的写入)与数据湖数据。查询处理完全在 Aurora 内部完成,不涉及额外的网络跳转,也不需要任何复制数据的 ETL 管道。你可以查询通过 AWS Glue Data Catalog 管理的 Apache Iceberg 表,也可以查询存储在 Amazon S3 和 S3 Tables 中的 Parquet 和 Iceberg 数据。这一切都可以使用你熟悉的 PostgreSQL 语法、现有应用程序和工具来完成。
我们很高兴能将 DuckDB 的速度与简洁性直接带入 Aurora PostgreSQL,让你和你的 agent 可以使用现有的 PostgreSQL 应用程序、工具和端点来查询与整合运营数据和 Iceberg 数据。围绕 DuckDB 构建这项能力,意味着未来这个开源引擎的改进可以持续为 Aurora 及其他 AWS 服务带来性能与功能上的提升。
新增内容
这项能力支持两个 Aurora PostgreSQL 大版本:17(从 17.11 开始)和 18(从 18.6 开始)。要使用它,你需要创建一个 Aurora PostgreSQL 集群,附加一个具有 AuroraAnalytics 功能的 IAM 角色,并启用 aurora_analytics 扩展。正是这个 IAM 角色赋予了 Aurora 访问你 Amazon S3 和 AWS Glue Data Catalog 中数据的权限。然后,你创建指向数据湖中 Iceberg 或 Parquet 数据的外部表,并使用熟悉的 PostgreSQL 语法进行查询。你可以通过 Amazon RDS 控制台 (https://console.aws.amazon.com/rds/home) 或任何 PostgreSQL 客户端(如 psql)完成这些设置。整个过程在 Aurora PostgreSQL 文档 (https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/) 中有详细说明。
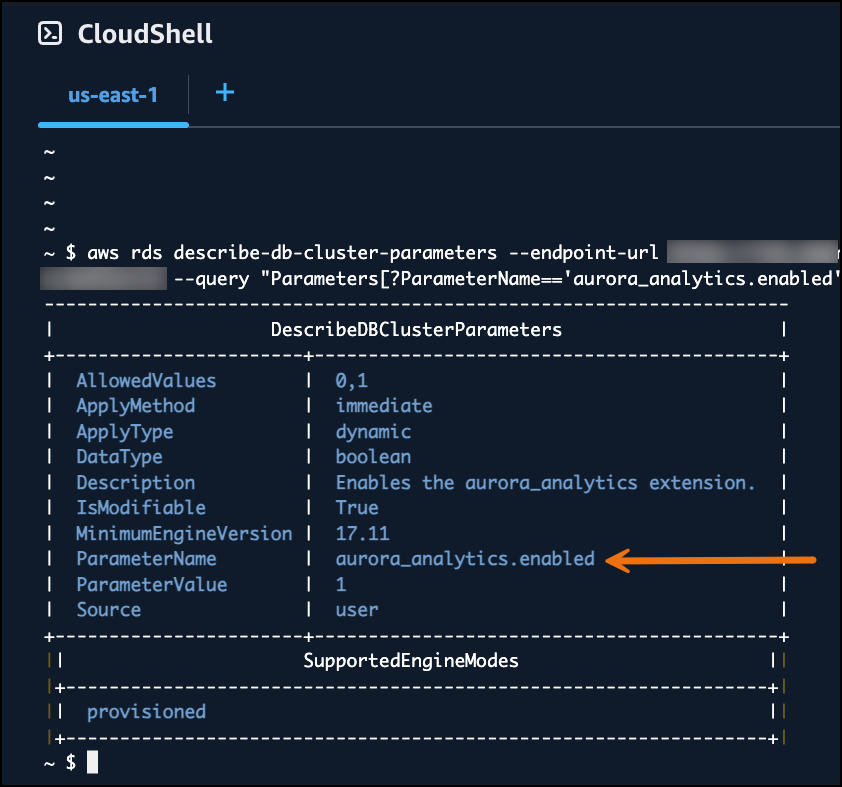
你可以通过 AWS Glue Data Catalog 联邦(federation)访问跨外部 IRC 兼容目录的数据。你只需向 Glue 注册一次外部目录,然后就可以像为任何 Glue 原生表那样,为想要查询的表创建外部表。一条查询即可将 Aurora 中存储的数据与注册在多个目录中的 Iceberg 表连接起来,应用因此获得统一视图,而无需移动数据,也不必替换你在现有目录上的投入。
Aurora 还会应用谓词下推(predicate pushdown)和列裁剪(column pruning)等优化,只读取相关的数据。这能保证即使底层数据不断增长,查询依然保持高效。频繁访问的数据还会缓存在你的 Aurora 实例中,因此对同一数据的后续查询返回得更快。你可以使用 aurora_analytics_stat_statements() 逐条查询地检查这一行为,它会报告扫描行数、从 Amazon S3 读取的字节数以及缓存命中等指标。
为了展示直接查询是如何工作的,我用 psql 连接了我的 Aurora PostgreSQL 数据库,并创建了扩展:
CREATE EXTENSION aurora_analytics;
在我的演示中,我设置了一个简单的金融场景:Aurora 中有一张 recent_transactions 表,包含最近 7 天的客户交易;而 Amazon S3 中有一个 Parquet 文件,包含 5 年的历史交易数据。为了让 Aurora 了解这些历史数据,我创建了一个指向 S3 中 Parquet 文件的外部表:
CREATE FOREIGN TABLE transaction_history ()
SERVER aurora_analytics_server
OPTIONS (
  location 's3:///finance/transaction_history.parquet',
  format 'parquet'
);
注意 CREATE FOREIGN TABLE 语句中那对空括号。Aurora 会自动从 Parquet 文件的元数据中读取表结构,因此你不需要手动定义列。对于包含大量表的工作负载,你可以跳过逐个创建:一条 IMPORT FOREIGN SCHEMA 语句就能为 AWS Glue Data Catalog 中某个数据库里的每一个 Iceberg 或 Parquet 表批量创建外部表,并自动推断表结构。
两张表都就位后,我运行了一条查询,将 Aurora 中的近期运营数据与 S3 中的历史数据结合起来:
SELECT merchant, category, amount, transaction_date, 'recent' AS source
FROM recent_transactions
WHERE customer_id = 'C-1001'
UNION ALL
SELECT merchant, category, amount, transaction_date, 'historical' AS source
FROM transaction_history
WHERE customer_id = 'C-1001'
  AND transaction_date >= CURRENT_DATE - INTERVAL '5 years'
ORDER BY transaction_date DESC
LIMIT 15;
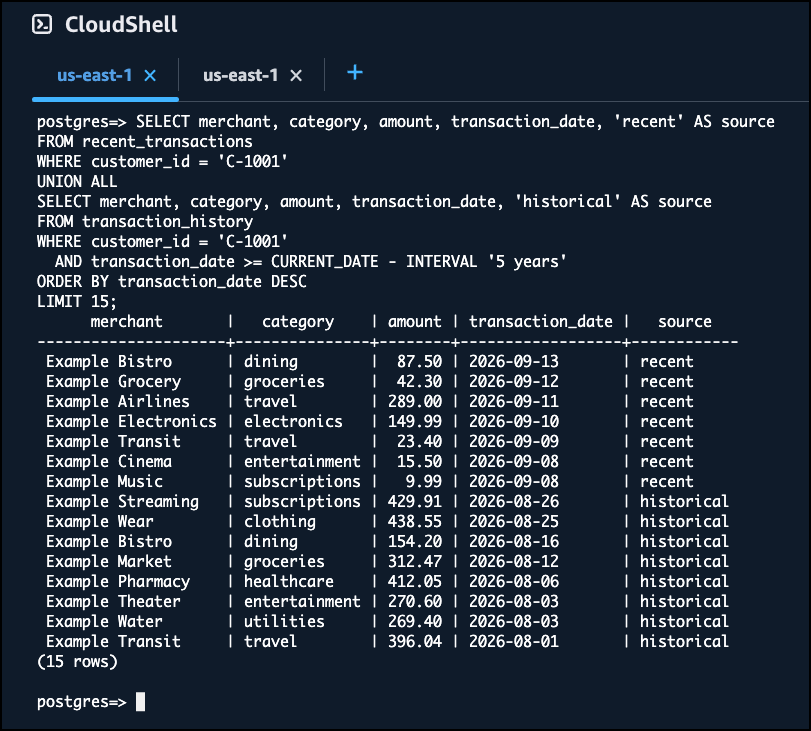
结果在一个结果集中同时展示了近期和历史交易。最近的 7 行来自 Aurora,其余数据则直接来自 S3 中的 Parquet 文件。在底层,DuckDB 负责 Parquet 数据的分析扫描,而 Aurora 负责运营数据。而这样一条查询,此前必须先建立管道把历史数据搬进数据库。
如果你的查询场景需要个位数毫秒级的延迟,可以使用熟悉的命令(如 CREATE TABLE AS SELECT、INSERT INTO ... SELECT 或 MERGE INTO)将数据湖中的数据物化(materialize)到 Aurora PostgreSQL 的原生表中。物化后的表存放在 Aurora 内,并像其他任何 PostgreSQL 表一样被查询,从而在不额外运维一套摄入管道的情况下,为热点数据提供低延迟路径。
读查询可以运行在集群中的任意 Aurora PostgreSQL 实例上,无论是写实例还是读副本,因此你可以将分析扫描负载从运营工作负载中分流出去。物化命令会把数据写入 Aurora,因此它们运行在写实例上。
立即开始
从 Amazon Aurora PostgreSQL 直接查询 Apache Iceberg 和 Parquet 数据的功能现已在所有商业 AWS 区域和 AWS GovCloud(美国)区域正式可用,且不收取额外费用。你只需为查询所消耗的增量 Aurora 计算资源付费,以及为读取数据湖文件产生的 Amazon S3 请求费用 (https://aws.amazon.com/s3/pricing/)。
了解更多,请访问 Amazon Aurora 功能页面 (https://aws.amazon.com/rds/aurora/features)、阅读 Aurora PostgreSQL 文档 (https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/),或在 Amazon RDS 控制台 (https://console.aws.amazon.com/rds/) 中试用。我们欢迎你通过 AWS re:Post (https://repost.aws/) 或你惯用的 AWS 支持渠道向我们反馈。
— Esra (https://www.linkedin.com/in/esrakayabali/)
相似文章
将Postgres数据以Parquet格式存储在S3上:LTAP架构解析
Databricks推出Lakebase LTAP架构,将Postgres数据以Parquet格式存储在S3上,无需CDC或镜像即可在单份数据上实现事务与分析。
AWS 收购 DuckDB
AWS 收购了分析型数据库 DuckDB 背后的公司 DuckLabs,确保项目在 MIT 许可证下保持开源,同时利用 AWS 资源推动其发展。
Greptime:GreptimeDB Enterprise 现已集成 Apache Iceberg,支持从 Spark、Trino、DuckDB 和 pyiceberg 等引擎查询您的表,无需复制数据。
GreptimeDB Enterprise 与 Apache Iceberg 集成,通过发布基于现有 Parquet 文件的 Iceberg 元数据,使表可以从 Spark、Trino、DuckDB 等引擎查询,无需复制数据。
@guizmaii: DuckDB 是数据工程的终极对手
Duckherder 是一个新的 DuckDB 扩展,它使用 Arrow Flight 在多个工作节点之间支持分布式查询执行,旨在通过并行处理增强数据工程工作流。
Show HN: Streambed – 将Postgres流式传输到S3上的Iceberg,支持Postgres Wire协议
Streambed是一个开源的CDC引擎,它将Postgres的WAL变更流式传输到S3上的Iceberg表,并内置了一个使用DuckDB的查询服务器,该服务器支持Postgres wire协议。