Open ASR 排行榜新增首个全球南方语言
摘要
Voice Arena 和 Hugging Face 已将印地语和印度英语添加到 Open ASR 排行榜,引入新的评估集,旨在捕捉多样化的说话者属性并解决自动语音识别中的偏见。
查看缓存全文
缓存时间: 2026/08/28 21:20
开放ASR排行榜新增首个全球南方语言
来源:https://huggingface.co/blog/open-asr-leaderboard-global-south Voice Arena与Hugging Face合作推出面向印地语和印度英语的开放ASR评估
基准测试决定了技术发展方向。在开放ASR排行榜上表现优异的模型会获得广泛应用与迭代,而未被评测覆盖的能力往往难以提升。近期排行榜的改进主要聚焦于提升评估指标的可信度:
- 独立验证私有数据子集(https://huggingface.co/blog/open-asr-leaderboard-private-data)。
- 基准适配分析(https://huggingface.co/blog/asr-benchmark-optimization)量化模型对参考文本的复现程度与纯音频转写的差异。
- 完善标准化处理流程,确保合理预测结果不受错误惩罚。
这些措施让单词错误率更难被人为操控。但这仍然是一个单一指标。大量研究表明,ASR错误率在用户群体中分布不均。自动语音识别中的种族差异研究(https://www.pnas.org/doi/10.1073/pnas.1915768117)发现商业系统对黑人说话者的错误率约为白人两倍,而《量化自动语音识别偏差》论文(https://huggingface.co/papers/2103.15122)进一步揭示了性别、年龄和口音带来的差异。这些维度在排行榜上不可见——并非因为排行榜刻意隐瞒,而是其使用的测试集仅记录语音内容,几乎不包含说话者信息。
为弥补这一空白,我们向开放ASR排行榜引入了两个评估集:Monsoon en-IN 和 Monsoon hi-IN。印地语作为超过五亿人使用的语言,成为这个目前仅覆盖欧洲语言的多语言排行榜中首个印度语言数据集。每个数据集包含公开子集(可用于自主评估)和私有子集(限制基准针对性优化)。四个子集在说话者层面完全独立,涵盖4888位说话者,每人记录12项属性特征。
数据集设计
测试集只能揭示其设计所针对的缺陷模式。多数基准测试基于现有音频构建,而Monsoon数据集围绕九个维度进行差异化设计:地理分布、年龄、性别、词汇量、设备类型、声学环境、语音类型、语速,以及同一音频存在多个有效转写文本的可能性。这些维度正是平均WER指标可能掩盖特定群体误差的关键所在。
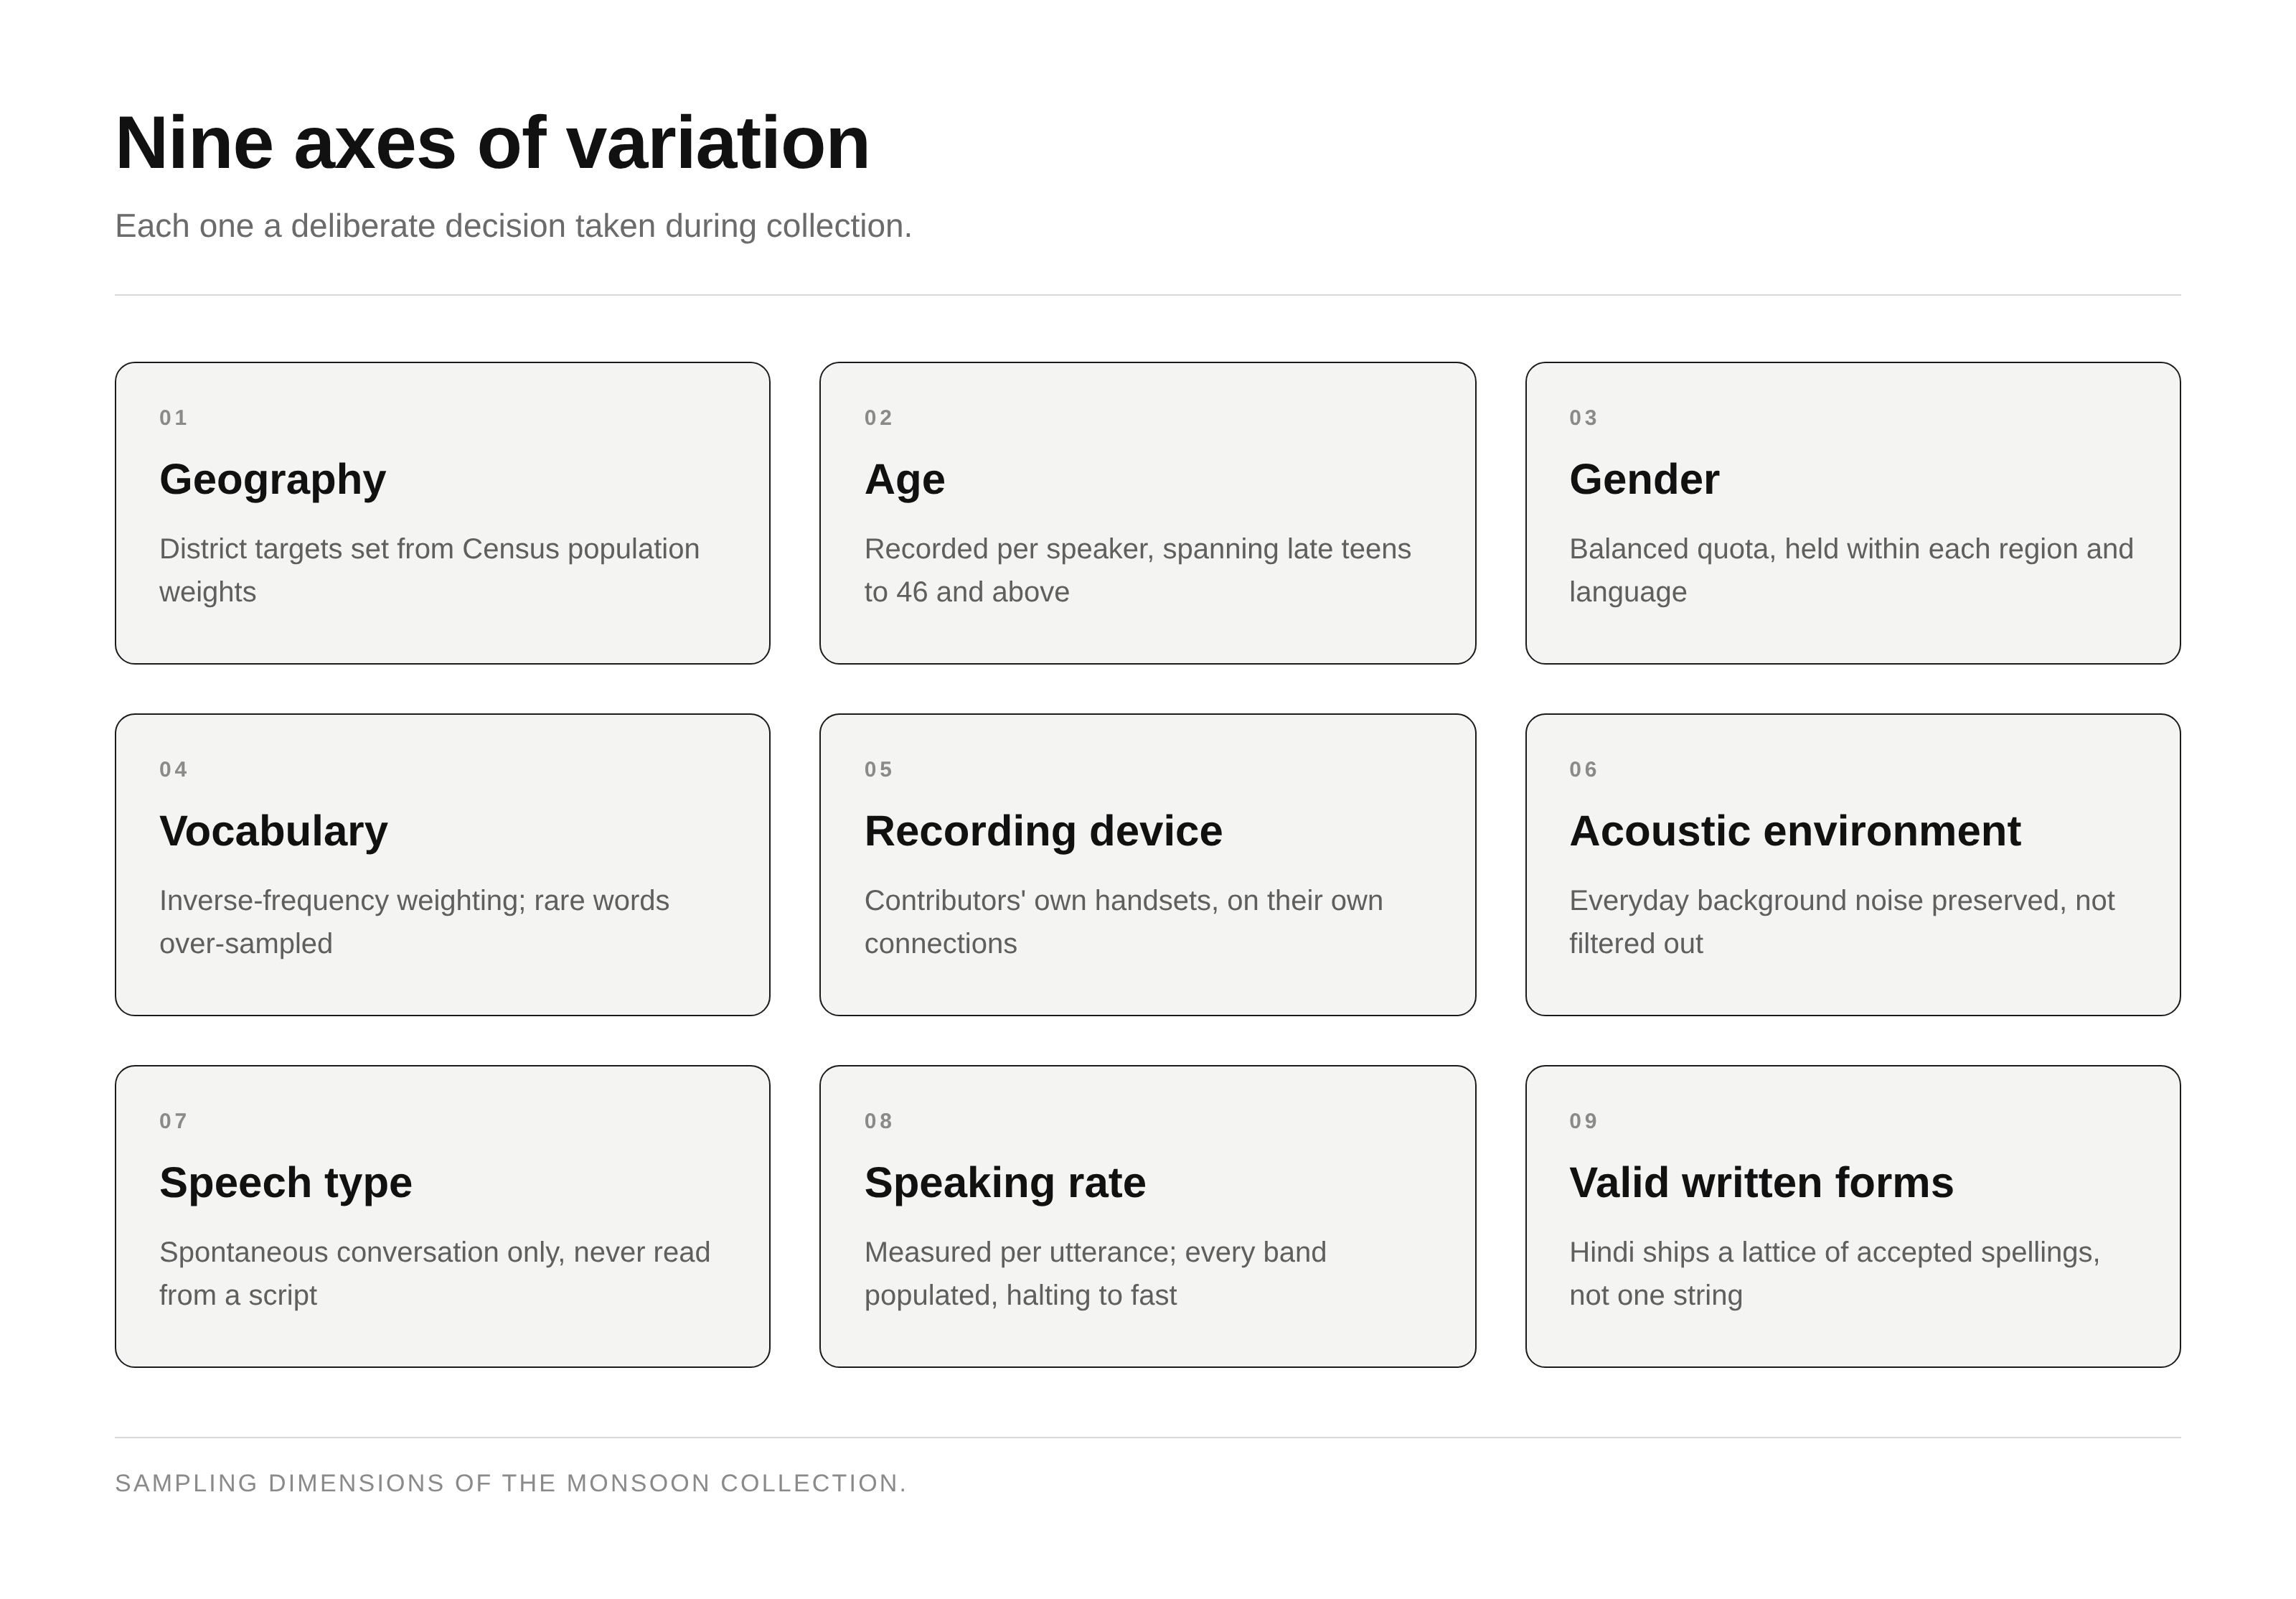
采集方法由此延伸:
- 地理覆盖通过数百个地区的招募实现,而非集中在少数地区进行长时间录制。
- 设备与声学条件采用参与者自有设备,涵盖室内外多种环境,而非实验室统一配发设备。
- 词汇量、语音类型和语速通过话题引导实现:日常主题促使参与者表达观点、分歧、叙事和回忆,从而自然产生专有名词、数字及非预设表述。
- 年龄与性别信息按说话者记录并经核验。
- 多重有效转写是参考文本的属性而非音频属性,将在后文详述。
数据集构成
四个子集、两种语言、统一采集流程。
| 数据集 | 语言 | 时长 | 说话者 | 片段长度(均值/中位) | 男女比例 | 地区数 | 州/联邦属地 | 设备数 | 风格 | 转写形式 |
|---|---|---|---|---|---|---|---|---|---|---|
| Monsoon en-IN公开集 | 印度英语 | 5.62小时 | 1,444人 | 9.6秒/10.4秒 | 50%/50% | 428区 | 30州/6联邦属地 | 56种设备 | 对话式自发语音 | 标准化转写(含非流利特征) |
| Monsoon en-IN私有集 | 印度英语 | 5.58小时 | 1,405人 | 9.6秒/10.4秒 | 45%/55% | 420区 | 24州/6联邦属地 | 60种设备 | 对话式自发语音 | 标准化转写(含非流利特征) |
| Monsoon hi-IN公开集 | 印地语 | 1.33小时 | 468人 | 6.4秒/5.0秒 | 54%/46% | 202区 | 11州/3联邦属地 | 15种设备 | 对话式自发语音 | 网格转写(接受正字法变体) |
| Monsoon hi-IN私有集 | 印地语 | 4.47小时 | 1,571人 | 6.6秒/5.3秒 | 55%/45% | 295区 | 12州/3联邦属地 | 82种设备 | 对话式自发语音 | 网格转写(接受正字法变体) |
数据源自动态双通道自发对话,片段从单通道分割以确保每段仅含单个说话者。除表中字段外,每段音频还记录职业、教育程度、婚姻状况、收入区间、手机品牌、当前城市及居住年限。
以下是公开印度英语子集中的五个示例片段及其元数据:
- 29岁女性,特里普拉邦西特里普拉区,学生,三星SM-G781B
- 32岁女性,中央邦萨特纳区,待业,三星SM-E146B
- 22岁男性,比哈尔邦罗赫塔斯区,学生,摩托罗拉moto g54 5G
- 27岁女性,特伦甘纳邦瓦朗加尔区,待业,vivo V2247
- 57岁男性,本地治里联邦属地,私营企业职员,小米M2006C3LI
英语数据集采用标准字符串参考文本,排行榜标准化工具可处理多数拼写变体。而印地语存在更多变体,且无法通过标准化工具统一,因为变体间并非固定映射关系。因此印地语数据集采用网格格式:为每个转写片段提供多个被认可的正确拼写形式。
说话者覆盖范围
Monsoon以小时数衡量规模较小,但以说话者数量衡量则规模庞大。这是其设计重点,也是核心价值所在。
说话者集中度与字段外多样性
| 统计指标 | Monsoon hi-IN公开集 | Monsoon hi-IN私有集 | Monsoon en-IN公开集 | Monsoon en-IN私有集 |
|---|---|---|---|---|
| 人均片段数 | 1.61 | 1.56 | 1.46 | 1.48 |
| 单片段说话者占比 | 26.1% | 9.9% | 49.6% | 49.2% |
| 人均音频时长(中位数) | 8.34秒 | 8.28秒 | 12.36秒 | 12.39秒 |
| 前10位说话者贡献时长占比 | 6.8% | 3.1% | 2.8% | 2.9% |
| 覆盖当前城市数 | 289 | 814 | 641 | 584 |
| 设备制造商数量 | 18 | 25 | 23 | 20 |
由此产生三个特性,均涉及方差而非总量:
- 无单一语音主导评分:前十大贡献者仅占总时长2.8%-6.8%,超过半数说话者仅出现一次。Monsoon的评估结果基于数百个不同声音的平均,而非少数长录音说话者。同等时长的测试集通常采用相反构建方式。
- 无单一地区或设备主导评分:印度英语公开集涵盖30个邦和联邦属地的428个原生地区;印地语数据集虽属印地语带语言而更集中,仍覆盖202-295个地区。录音来自315-582种不同设备型号,无任何单一型号在子集中占比超过2.1%。标准化硬件采集的语料库易对特定麦克风响应过拟合,本数据集避免了此问题。
- 印度英语并非单一口音:这是全国范围内使用的英语,非某一地区专属。所有六个区域均有代表:公开集中35%片段来自南部说话者,东部、中部各18%,北部16%,西部11%。由此产生的口音差异记录在元数据中而非主观断言。
元数据字段
Monsoon每个片段包含18列数据,其中12列为元数据(多数公开ASR测试集仅提供标识符、转写文本和时长)。人口统计字段完整或接近完整,贡献者同意此使用方式。
| 字组 | 字段 | 片段信息 |
|---|---|---|
| 基础 | id、audio、audio_length_s、language | 参考文本lattice(印地语)或text(印度英语) |
| 说话者 | speaker_id、gender、date_of_birth | |
| 背景 | occupation、educational_background、marital_status、income | |
| 地理 | native_district、native_state、current_city、years_spent_in_current_district | |
| 录制 | device_manufacturer、device_model |
两种语言的地理分布特征各异且具信息量。印地语数据集集中在印地语带,北方邦约占说话者总数的40%,符合按人口抽样的印地语语料库特征。印度英语数据集分布更均衡:无任何邦占比超过13%,三分之一说话者来自八大邦以外地区。公开与私有子集在两项指标上均高度匹配。
印度邦界按语言划分,因此地区和邦字段携带真实口音信号,这也是发布而非汇总这些字段的原因。此前大规模印度ASR分析显示,地区级错误率跨度约4%-44%,代表性不足地区显著落后于印地语带和大城市,另有按音质、语速、语音时长、性别、年龄和设备的分类分析。此类分析此前仅限于封闭基准测试,Monsoon使其在公开排行榜测试集上成为可能。
采集与质量控制
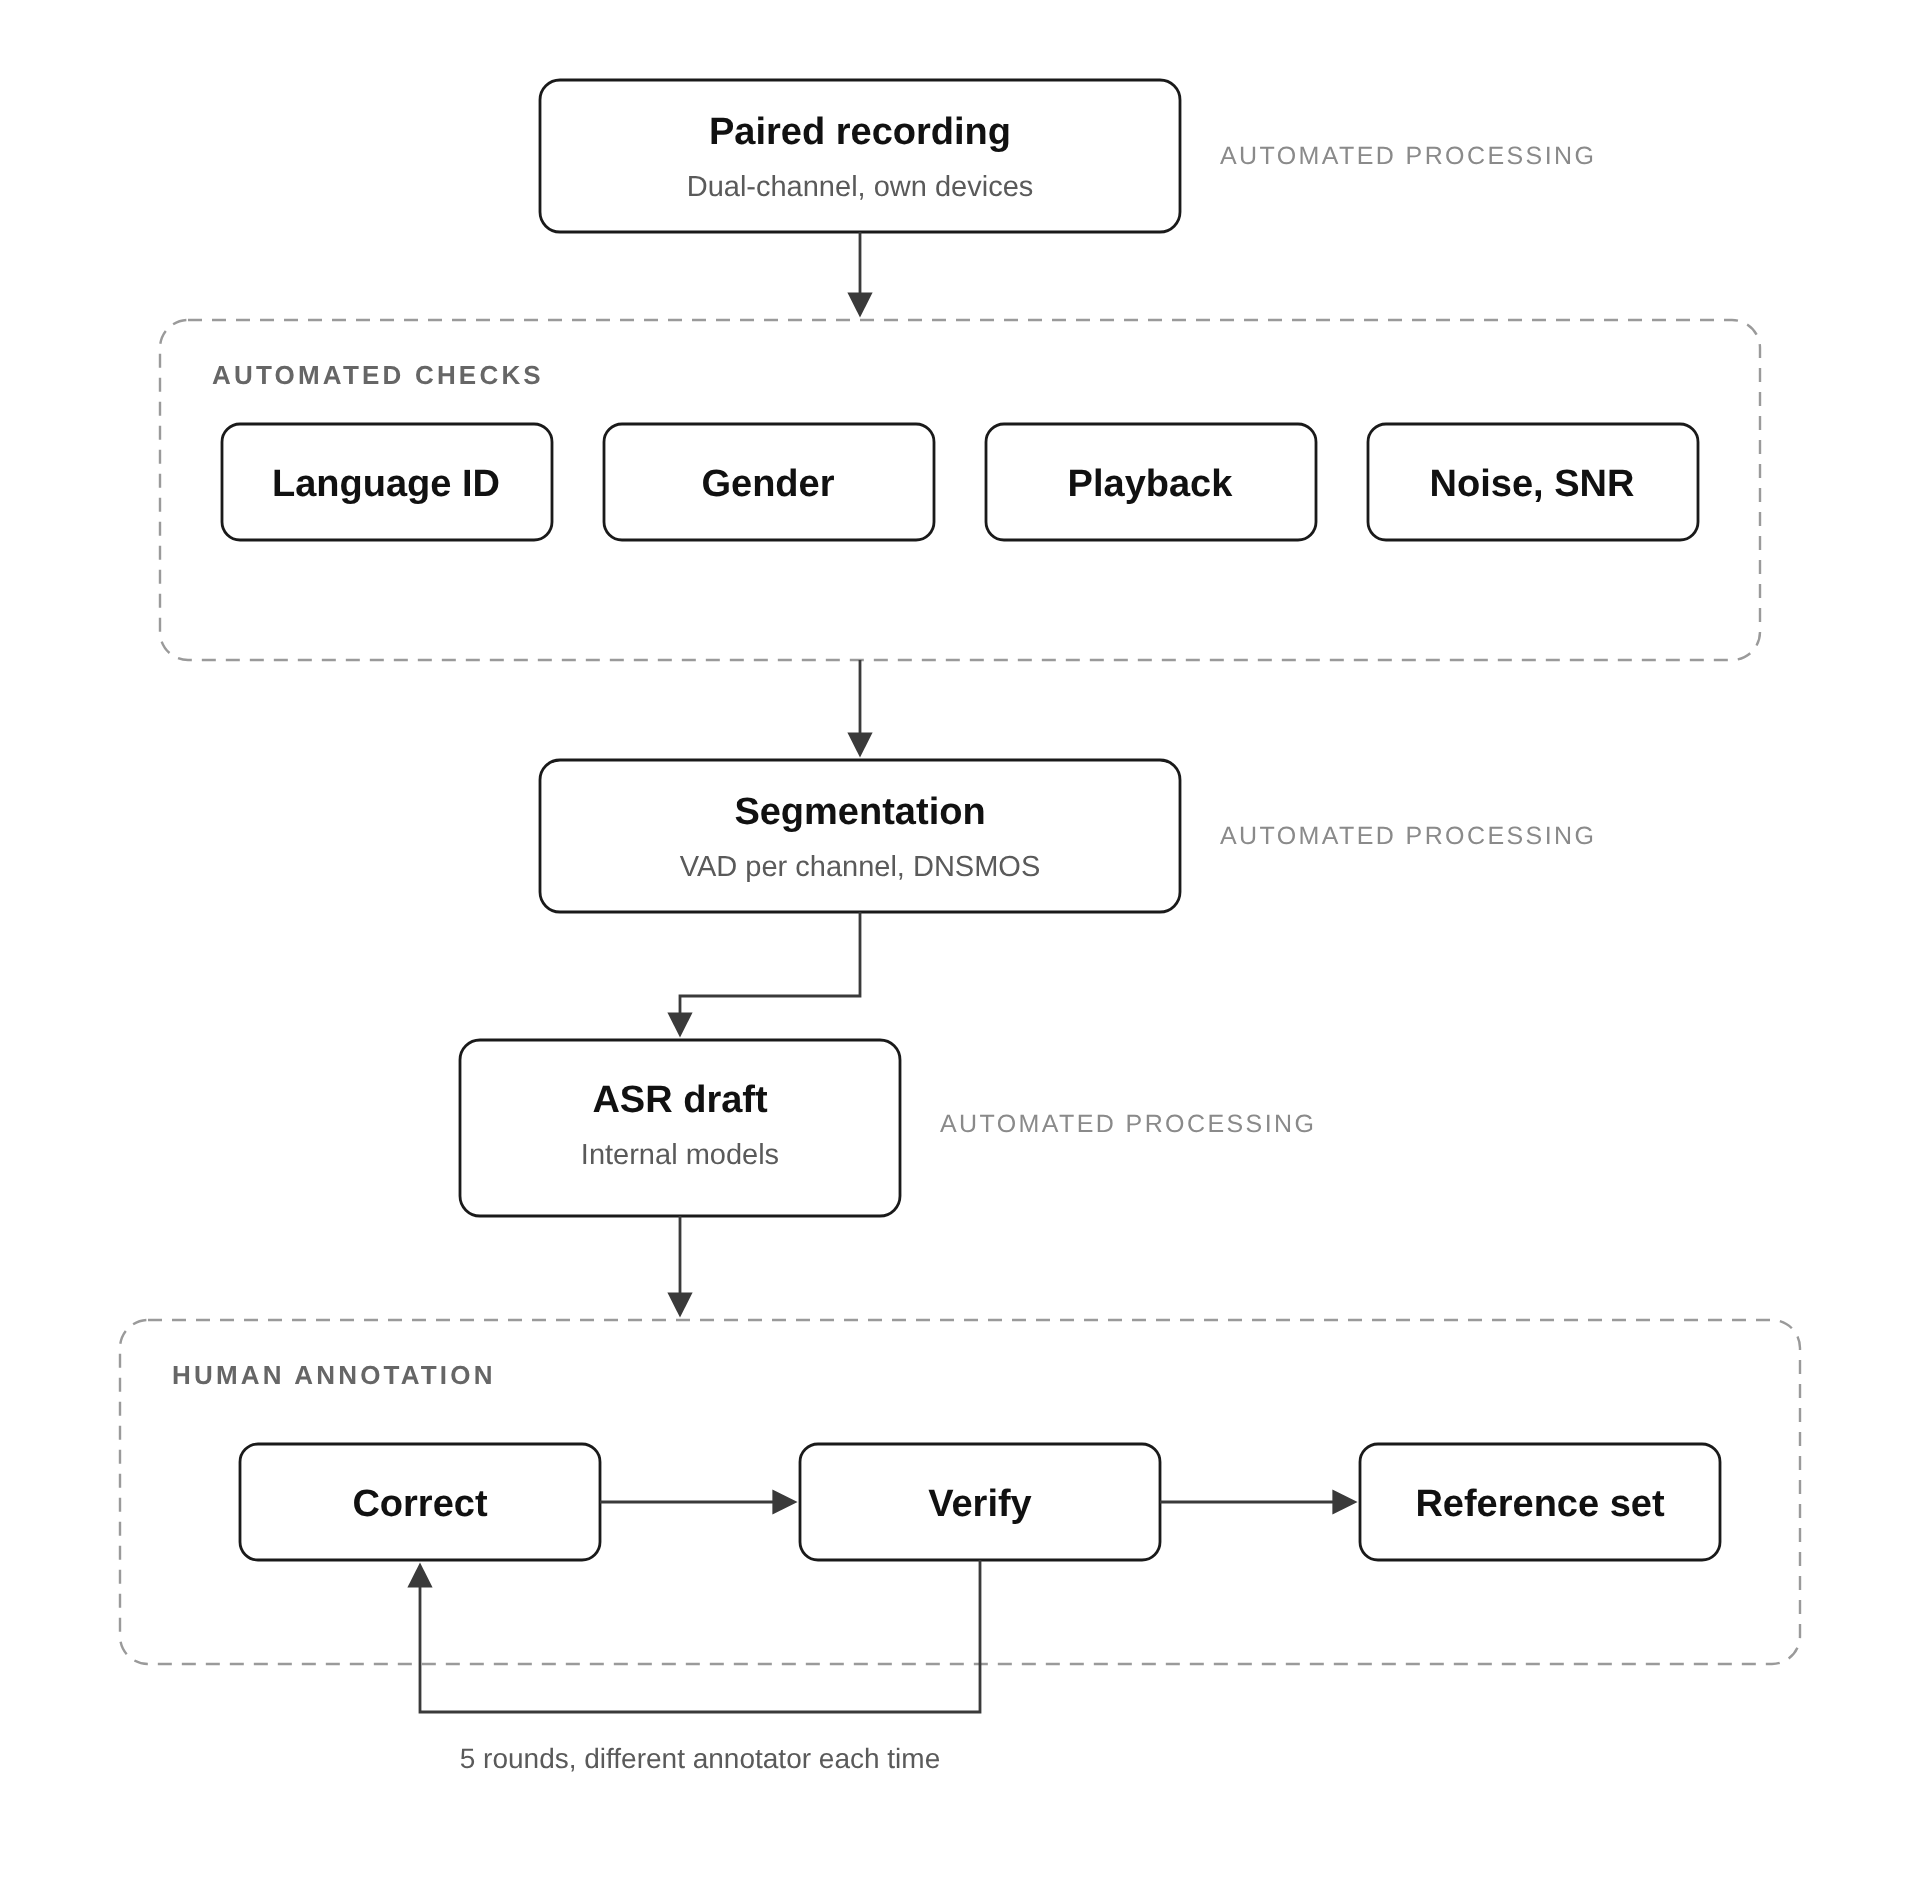
广泛地理覆盖需要在数百个地区开展招募,而非从少数说话者进行长时间录音。大规模分布式采样面临小型数据集不存在的挑战:参与者投机行为、提交预录音频伪装实时语音、标注不专注等。每个问题均有对应检测机制:
- 招募与录制:通过Voice Arena社区招募,该全球数字平台覆盖语料库常缺失的农村和半城镇地区。参与者通过点对点接口录制双通道双人对话,话题为指定日常主题。使用自有设备和网络连接,多数为低端设备和不稳定带宽,因此保留此条件而非过滤。候选人在获得录制权限前完成语言能力筛查,获得报酬并签署知情同意书(涵盖训练与分发用途)。按语言人口规模和地理分布校准的单人时长上限,防止少数高频贡献者主导特定语言或地区:超过半数说话者仅贡献一个片段。
- 诱导生成:大规模诱导自发语音存在挑战,参与者若无结构化引导易产生简短稀疏回应。每个对话以开放式叙事提示开场,逐步揭示后续问题,涵盖旅行、医疗、农业、教育和数字服务等领域,引导交流趋向扩展描述而非照本宣科。话题由大语言模型生成,经母语语言学家审核本地化。
- 质量控制:所有录音在转写前经过多项门控检测。使用在30多种人类标注数据上训练的语言识别模型验证所用语言是否匹配指定语言。专用分类器核实说话者性别标签,作为自报信息的辅助验证而非替代。额外模型区分真实自发对话与预录音频。信噪比估计移除难以辨识的劣质录音,同时保留自然环境背景音以维持真实场景声学特征。通过检测的录音经语音活动检测分割,在连续静音2秒或15秒软上限(于下一个检测到静音处截断)时分割。双通道独立分割,确保每段单人单通道。片段随后通过DNSMOS P.808检测。
- 转写:参考文本由人工完成。初稿由内部ASR模型生成,这些模型均未出现在任何公开排行榜,确保被评估系统未参与参考文本制作。后续阶段由母语语言学家按五级协议执行,基于严格分工:每轮修正后由不同标注员独立验证,避免自我审核。语言学家首先逐段对照声学信号修正初稿;第二位语言学家重新验证并标记残留分歧。后续级别由新标注员迭代此过程,逐步解决模糊音位实现、语码转换边界、专有名词及拼写变体间正字法一致性。数字以文字形式书写,确保转写与口语内容直接对应。最终级别仍被标记的片段返回重新转写。全程自动监控标注员行为,标记包含目标文字外字符、不自然字符/单词重复、异常低/高编辑次数的提交。
区域差异示例
以下基于公开印度英语子集的分析示例,展示元数据支持的评估类型。其价值不在于具体发现,而在于说明每个片段携带说话者信息后哪些问题可被回答。
排行榜上八款模型在该集WER介于4.81-4.99之间,极差仅0.18,符合五小时数据可分辨范围。按语料库排名,这些模型实为同一系统。
按地区分组后呈现不同结果。每位说话者的原生地区归入其所在区域委员会(印度内政部行政区划),形成五个充分采样的区域。openai/whisper-large-v3-turbo在各区域间波动达0.46个百分点。mistralai/Voxtral-Mini-3B-2507在语料库上落后其0.14个百分点,但区域波动达1.68:中部区域4.38 vs 东部区域6.06。两款在排行榜上无差异的系统,其准确率对说话者地域的依赖性相差近四倍。

最难区域也非固定不变。ibm-granite/granite…
相似文章
@rohanpaul_ai: Open ASR 排行榜 - https://huggingface.co/spaces/hf-audio/open_asr_leaderboard… 技术发布博客 - https://hu…
Open ASR 排行榜是 Hugging Face 推出的基准测试工具,用于评估自动语音识别模型,并附有技术博客文章,链接到 Voice Arena 排行榜。
Voice of India:面向印度真实场景的大规模语音识别基准
研究者发布 Voice of India,一个包含 536 小时、覆盖 15 种印度语言和 139 个区域集群的即兴电话对话闭源基准,揭示地理与人口统计学层面的 ASR 性能差异。
@SamuelZengML:开源ASR刚刚登顶。Audio8 ARK-ASR-3B现以4.76的平均WER在@huggingface Open ASR排行榜上排名第一,……
Audio8的开源ARK-ASR-3B以4.76的平均WER在Hugging Face Open ASR排行榜上夺得第一,同时其0.6B模型也进入前五,展示了一个有竞争力的开源语音技术栈。
@SarvamAI:我们开源两套评估印度语 ASR 的框架,并发布覆盖 22 种语言的完整评测指南。WER(…
SarvamAI 发布开源评估框架与指南,专为 22 种印度语言设计,解决传统 WER/CER 指标在该场景下的局限。
Indic DiarBench:面向印度语言的多语言联合说话人日志与自动语音识别基准
Indic DiarBench 是一个多语言联合说话人日志与自动语音识别基准,覆盖印度全部22种官方语言,包含108小时人工校正的多说话人音频,捕捉了语码混合、说话人重叠等对话细节。