用于文本分类的语言模型:从词袋模型到Jev AI
摘要
本文概述了文本分类方法的历史演进,从词袋模型到近期发布的Jev AI模型,该模型提供了高效且通用的分类能力。
暂无内容
查看缓存全文
缓存时间: 2026/09/30 02:00
# 用于文本分类的语言模型:从词袋到Jev
来源:https://magazine.sebastianraschka.com/p/classifier-history-and-jev
最近发布的Jev (https://typesafe.ai/blog/introducing-system-one-models-and-jev) AI模型在过去两周内成为技术社区的一种文化现象。虽然Jev旨在分类事物,但很容易将其视为“仅仅是一个分类器”,而我自己对Jev的看法在过去几天里也发生了很大变化。特别是,我的想法从“分类器曾是我的谋生工具;我可以轻松自己构建”(后文详述)转变为“哇,这实际上比我想象的要好用。”
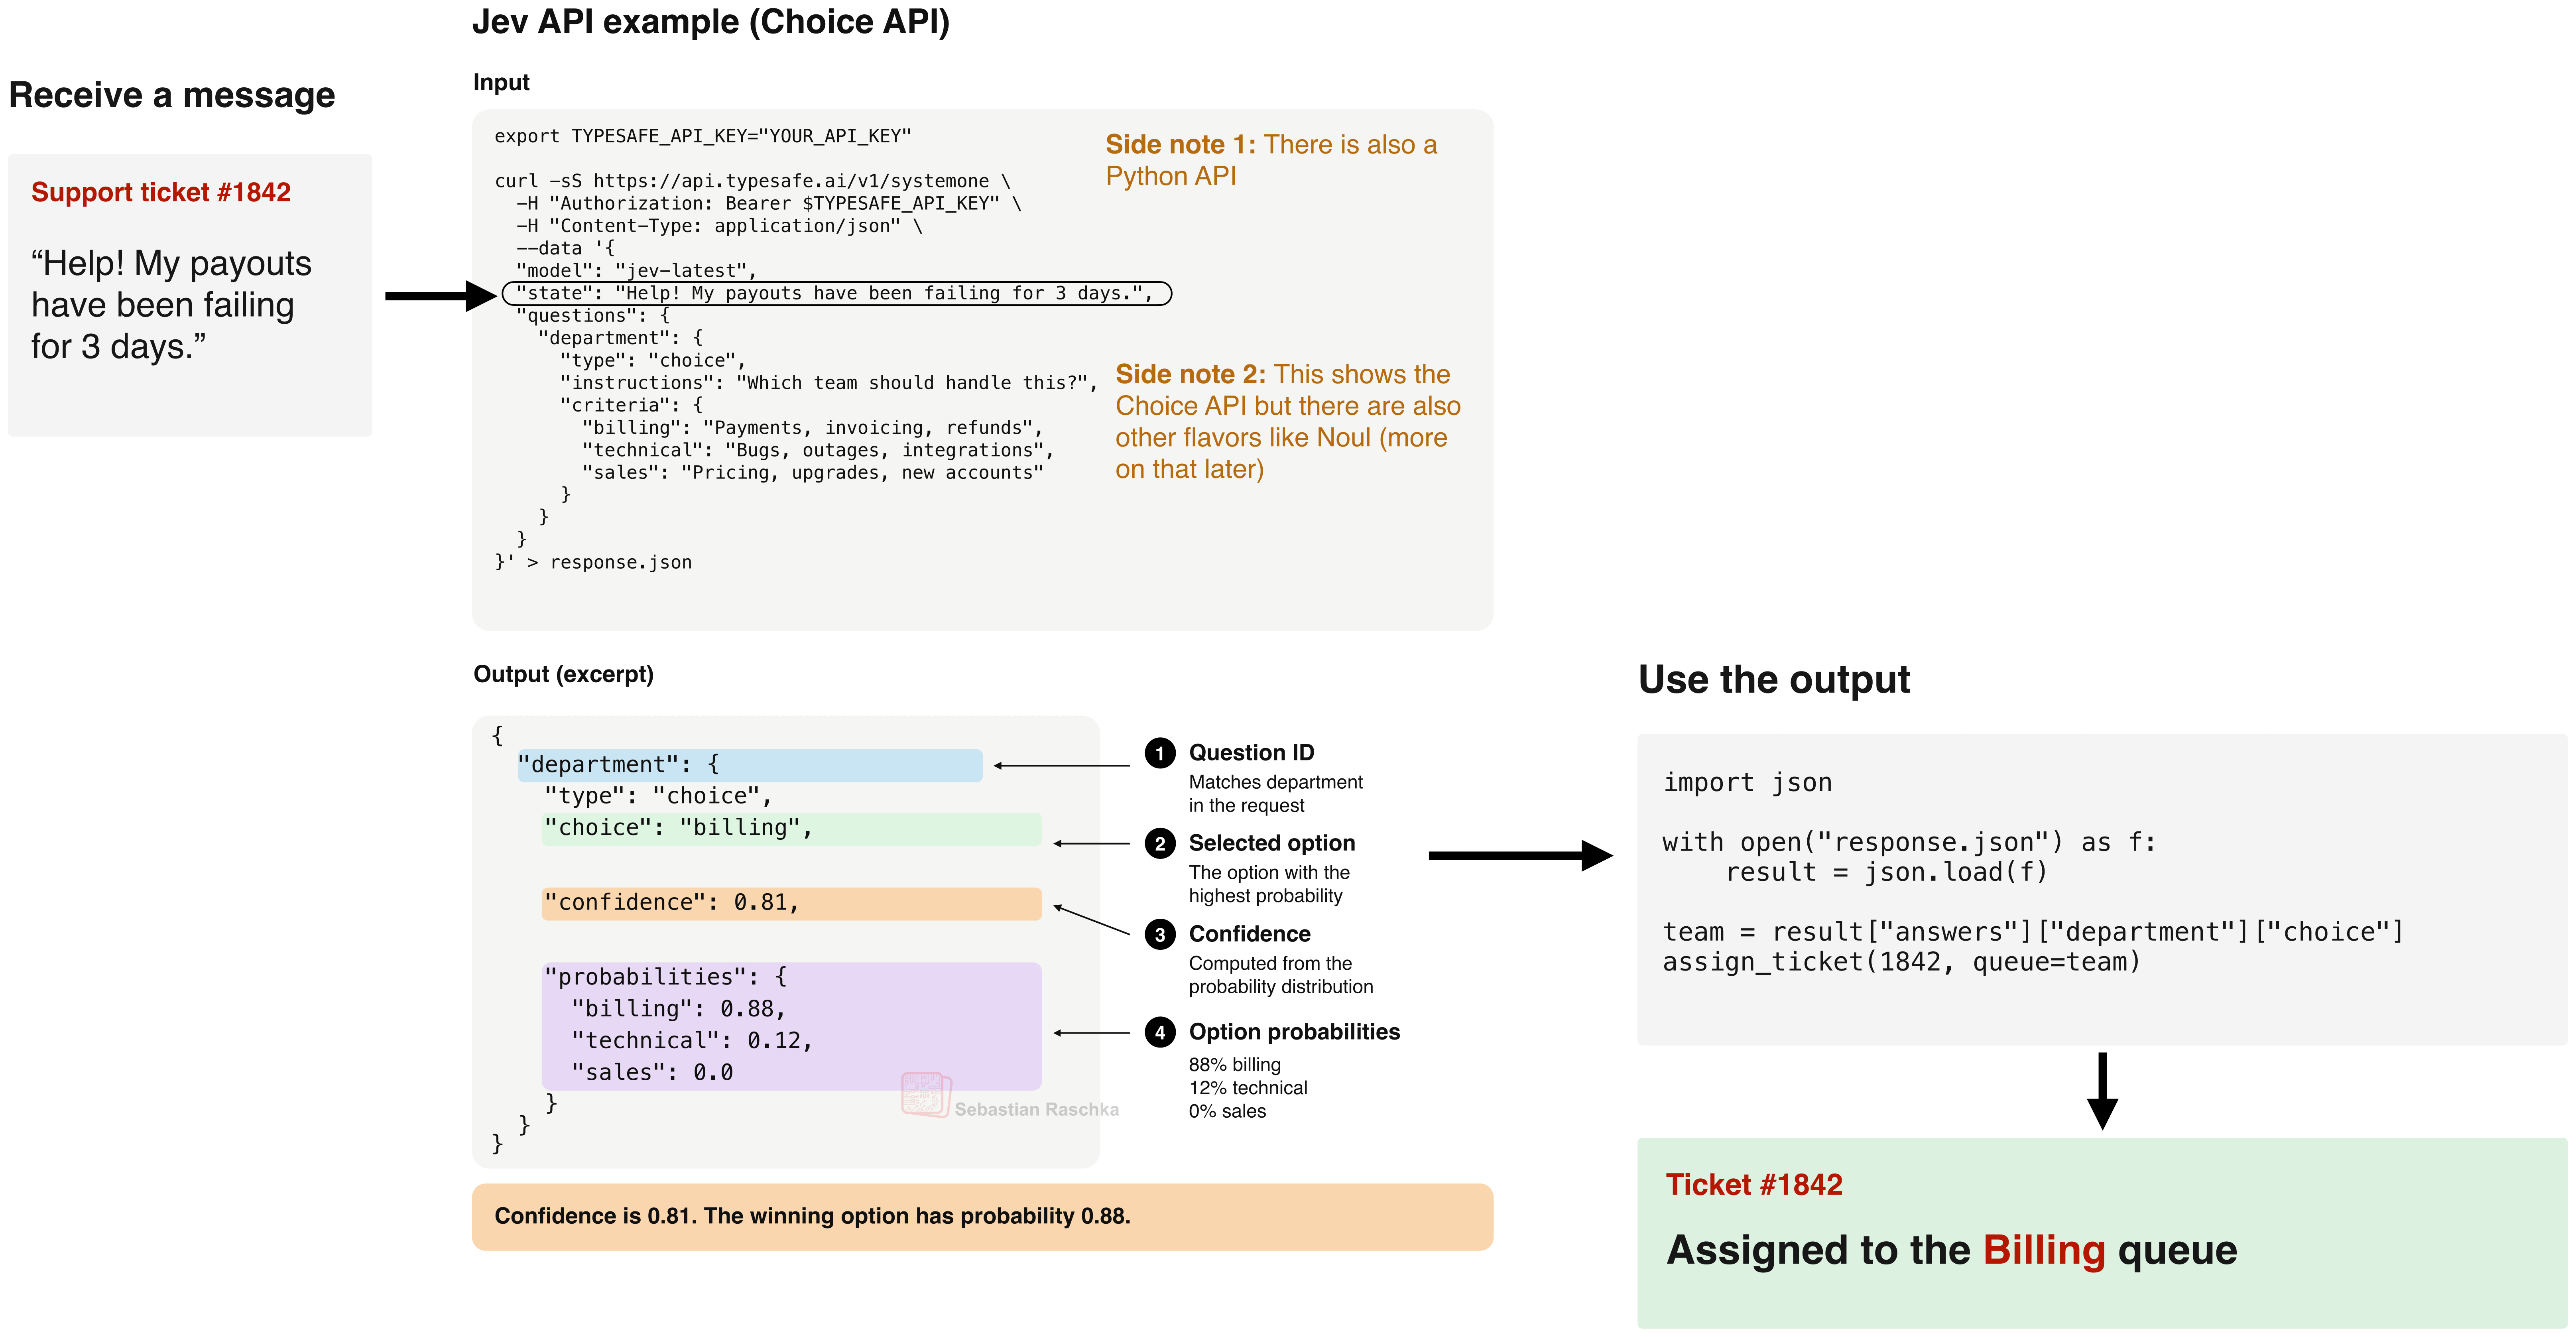
*图1:Jev API的快速概览;更多细节稍后说明。*
当然,最新的前沿GPT和开源大语言模型可以执行与Jev相同的分类任务,同时还能处理更通用的决策。但Jev的优势在于它能更快速、更低成本地处理这些分类任务。在另一个极端,对于狭窄、明确定义的问题,Jev可能不会比专用分类器分类得更好、更快或更便宜。但它的卖点是它比那些特定任务模型通用得多。
那么,Jev背后的方法论(基于有根据的猜测)是什么,它能做什么,以及它为何如此受欢迎?我打算在本文后续部分回答所有这些问题。不过,我认为从语言模型在决策方面的一个简短历史开始将是一个很好的起点。它有望帮助揭穿一些炒作,并展示Jev的亮点(“Jev本质上是一个文本分类器”,但“Jev又‘不仅仅是’一个文本分类器”)。
*注:我与Jev没有任何关联。此外,我没有获得Jev的免费访问权限,这也不是产品推荐,只是一篇技术文章,旨在提供一些关于文本分类历史的见解,以帮助你理解最近的炒作。*
由于这是一篇长文,**我建议你在浏览器中阅读它 (https://magazine.sebastianraschka.com/p/classifier-history-and-jev)**,那里你可以访问左侧的目录菜单。
为了完整起见,在我们把Jev放在其背景中讨论之前(非双关语),我认为最合理的方式是按时间顺序开始。在本节中,我想简要回顾一下基于朴素贝叶斯、逻辑回归和更经典的(深度)神经网络的应用型文本分类,这是在基于Transformer的模型出现之前的情况。
15年前我还是研究生时,尽管循环神经网络已经存在(后文详述),但文本分类通常使用词袋表示法,因为它简单直接,并且能在中等规模的数据集上取得良好结果。简而言之,我们可以将词袋表示法看作一种方法,它使不同长度的自由文本输入能够与经典的分类器(朴素贝叶斯、逻辑回归、支持向量机、随机森林、XGBoost等)兼容,这些分类器期望固定大小的输入向量。流行的实际应用包括从新闻文章分类到电子邮件垃圾过滤的任何事情。没错,据称即使是Gmail最初的垃圾邮件过滤器也使用了带有词袋表示法的朴素贝叶斯模型。
顺便提一下,我恰好在12年前写过关于这种方法 (https://arxiv.org/abs/1410.5329) 的文章。这是我最先在arXiv上分享的内容之一。
*图2:我2014年的一篇旧教程 (https://arxiv.org/abs/1410.5329),解释了如何使用词袋模型的朴素贝叶斯分类器。*
那么,这种词袋表示法到底是什么?它是一种将不同长度的自由形式文本(例如)转换为固定大小表示的方法,以便用于上述的“经典”分类器。
- 训练样本1:*“《Zentropa》是我多年来见过的最具原创性的电影。如果你喜欢受黑色电影影响的独特惊悚片,那么这正是为当今充斥影院的那些好莱坞暑期大片准备的解药。冯·特里尔的后继作品如《破浪》获得了更高的赞誉,但这确实是他最好的作品。”*
- 训练样本2:*“这部电影简直糟透了。约翰·里特的滑稽动作,75%的演员念台词仿佛在读提示卡,剪辑糟糕,声音混音可怕。”*
- 训练样本3:*“《Zentropa》与《第三人》有许多共同点,后者是另一部类似黑色电影的作品,背景设在战后欧洲的废墟中。”*
(上面的摘录来自流行的IMDb电影评论分类数据集 (https://ai.stanford.edu/~amaas/data/sentiment/)。)
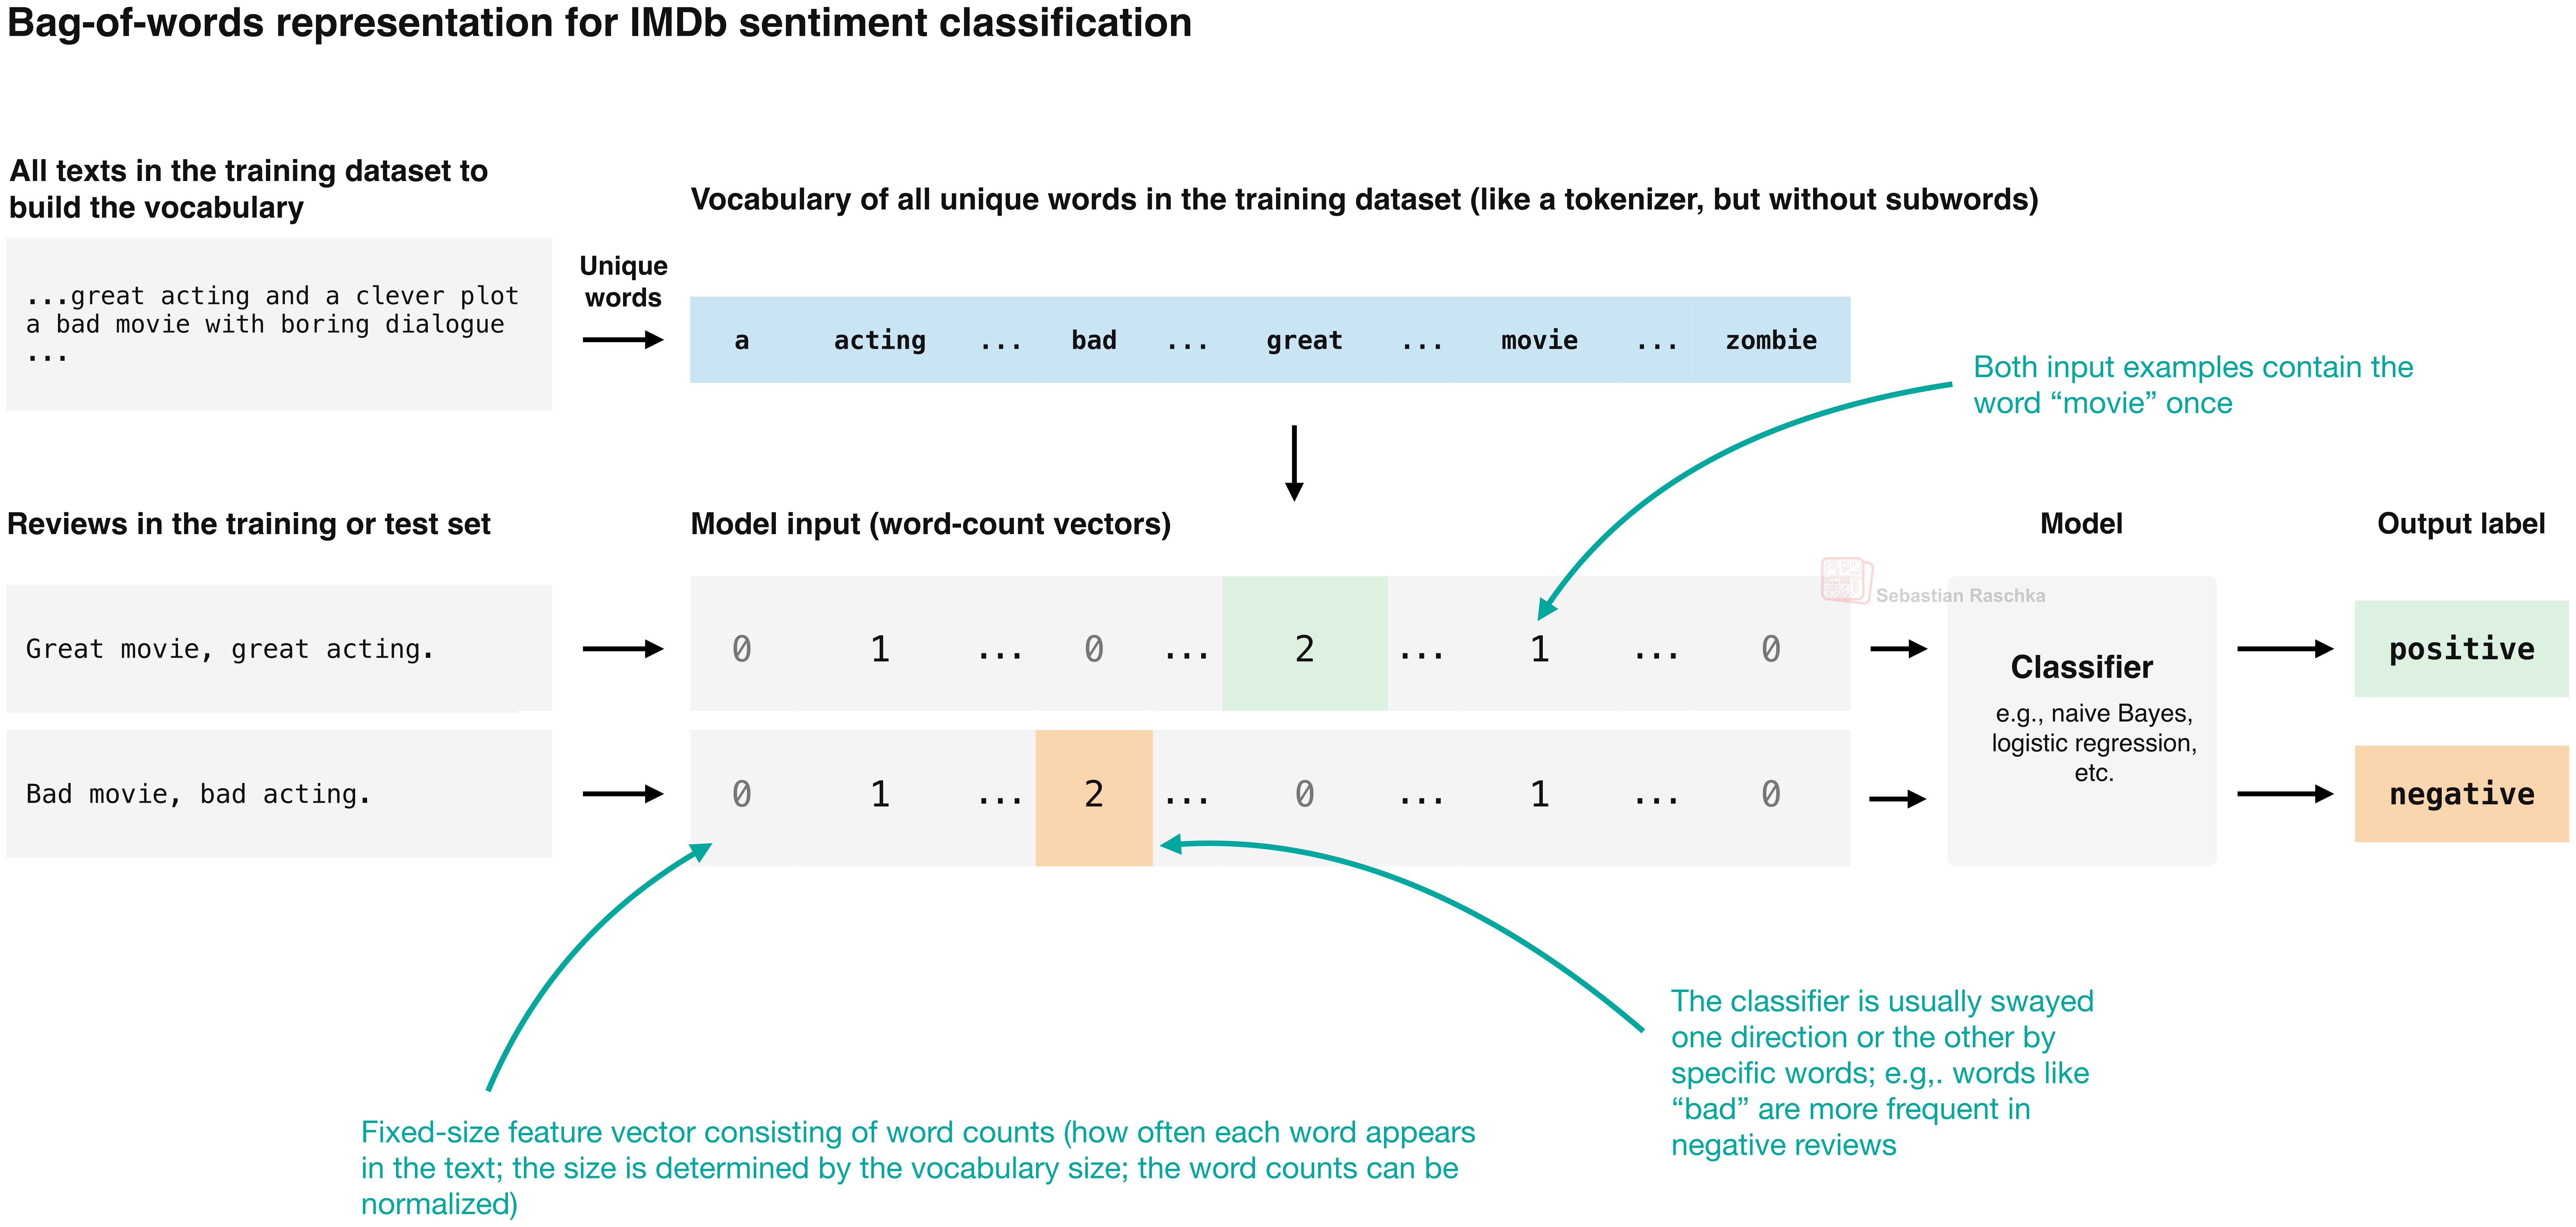
*图3:词袋表示法示意图。*
词袋模型首先构建词汇表,该表由训练集中所有唯一的单词组成(可选地,可以去除所谓的停用词,如“a”和“the”,这些词在大多数上下文中几乎不携带语义信息)。词袋表示法通过为词汇表中的每个单词分配一个在向量中的独立位置,从而产生这些固定大小的输入。然后我们统计每个单词在文档中出现的频率。例如,如果我们有一个包含50,000个唯一单词的词汇表,无论输入是仅包含十个单词还是30万个单词,它都会生成一个具有50,000个条目的固定大小向量。注意,大多数条目为零,因为每个文档只包含词汇表的一小部分子集。(除了表示原始计数,还有像TF-IDF这样的归一化方案。)
然后,一旦我们有了这些词频向量,就可以在有标签的训练集(例如标记为垃圾邮件或非垃圾邮件的电子邮件)上训练分类器。例如,逻辑回归模型会学习与特定标签相关的某些单词(和单词计数)的特征权重。例如,某些单词可能会增加预测的垃圾邮件概率,而其他单词可能会降低它。这种方法计算成本低,当特定单词能为标签提供强力线索时效果很好。在像垃圾邮件分类这样的简单分类任务中,这通常足以获得快速、相当准确的结果。
但这种方法最大的缺点之一是,由于词袋表示法的性质,它丢失了单词顺序。因此,例如,“狗咬人”和“人咬狗”尽管描述的是不同的事件,却产生相同的向量。(有一些变通方法,通过添加称为n-gram的单词对或更长的序列作为特征来保留一些局部顺序,尽管这会增加词汇表的大小。)
尽管有缺点,我仍然认为词袋在某些低风险应用中占有一席之地,因为它成本很低,而词袋表示法加逻辑回归仍然是我应对每个文本分类问题的首选基准,因为它非常容易实现。
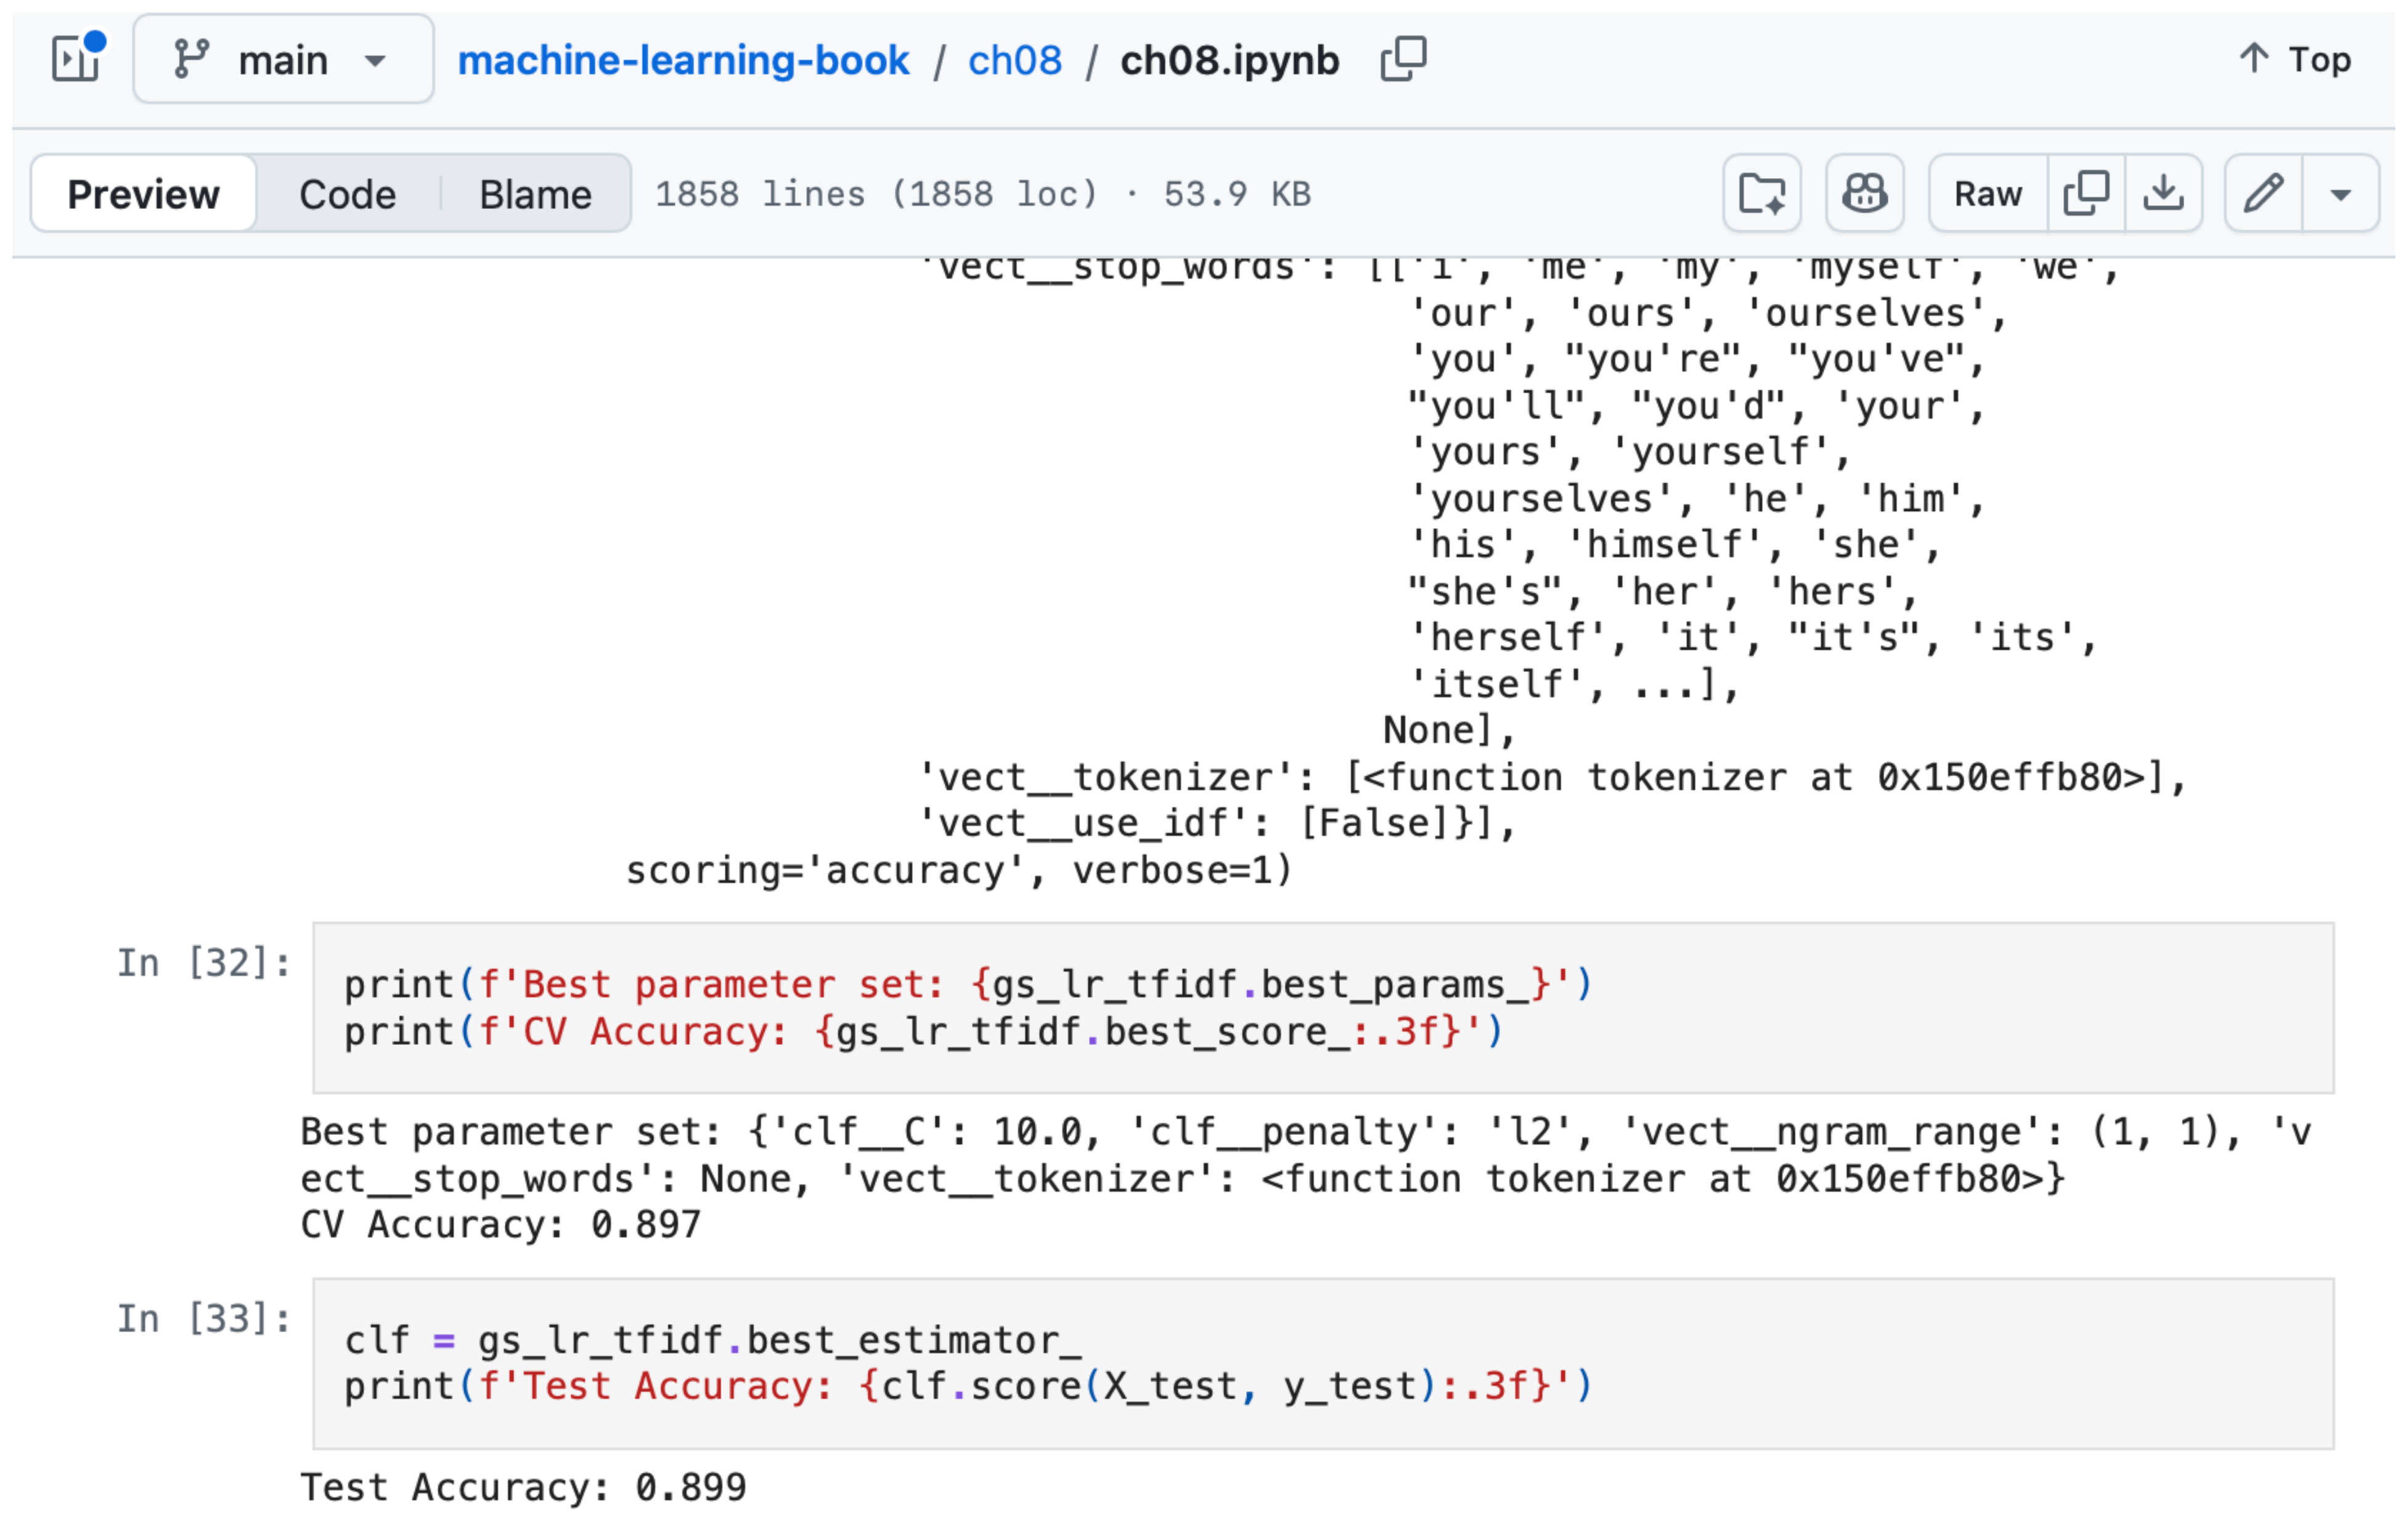
*图4:对于有兴趣构建简单逻辑回归分类器的人,我这里有一个教程 (https://github.com/rasbt/machine-learning-book/blob/main/ch08/ch08.ipynb)。该模型在平衡数据集上达到了89.9%的准确率。*
上述词袋模型也适用于(简单的)深度神经网络,如多层感知机。但缺点仍然是我们会丢失句子结构和单词顺序。然而,更复杂的神经网络架构避免了词袋的变通方案:卷积神经网络(CNN)和循环神经网络(RNN),它们可以接受词嵌入作为输入。
首先,在将输入文本送入模型之前,我们需要将其转换为合适的表示。其中一种表示是词袋。另一种是词嵌入向量。区别在于,词袋向量通过统计每个词汇单词出现的次数来表示整个文本,而词嵌入则将单个单词表示为由学习到的数字组成的稠密向量。
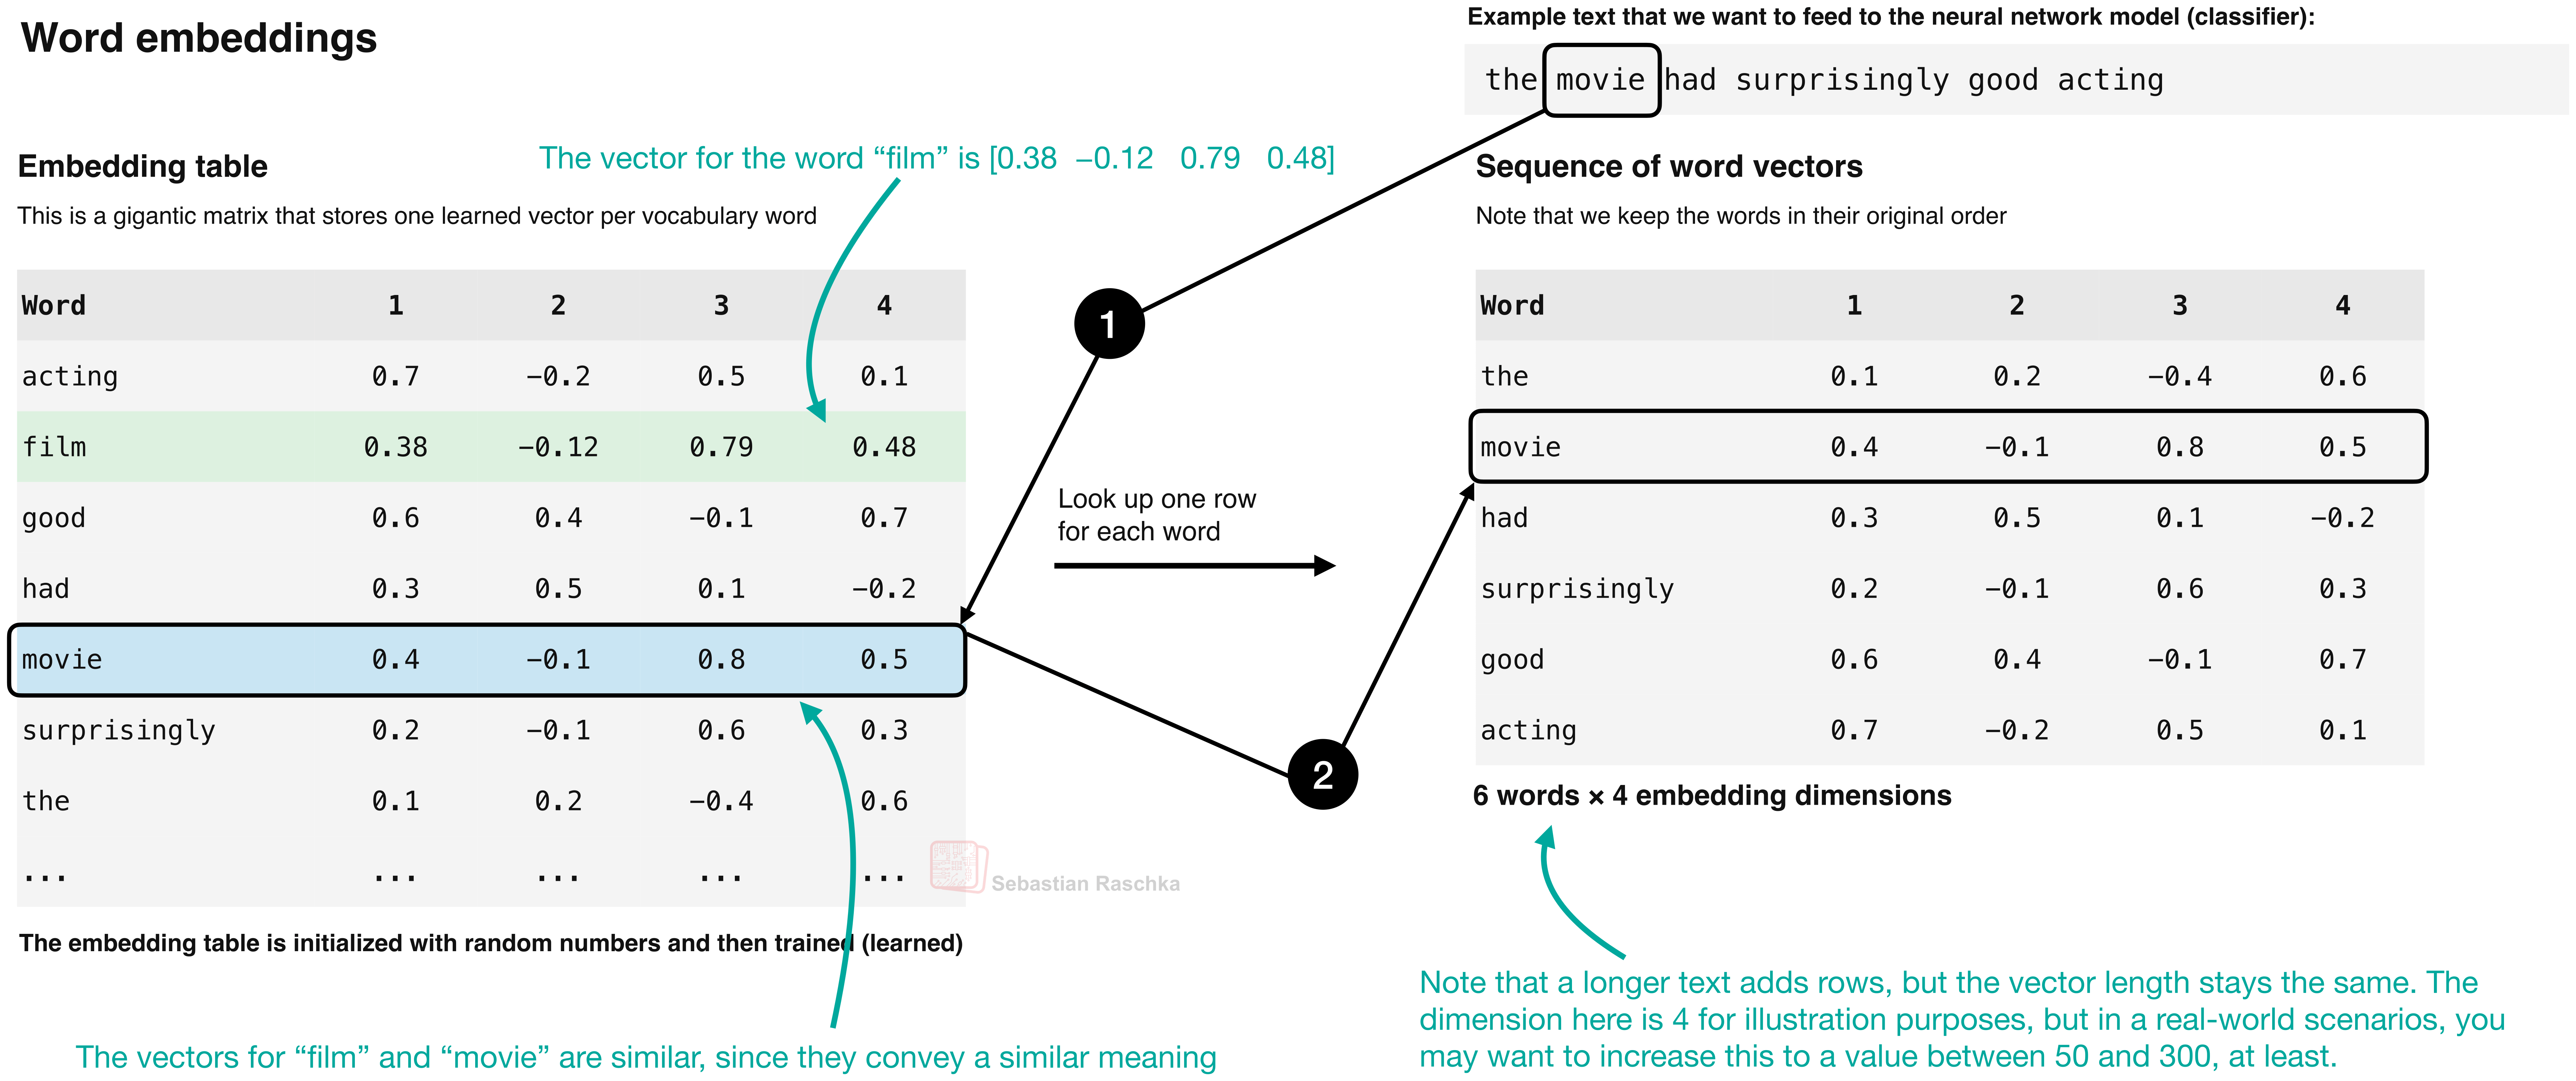
*图5:创建词嵌入的示意图。*
- 词嵌入的工作原理类似于大语言模型中的嵌入层,即它们将输入令牌转换为稠密向量。嵌入可以发生在模型外部(例如,两种经典的、流行的用于学习它们的方法是Word2Vec (https://arxiv.org/abs/1301.3781)和GloVe (https://aclanthology.org/D14-1162/)),或者嵌入层可以是神经网络架构的一部分,在模型训练期间学习和调整。
- 这些经典嵌入在查找时是上下文无关的。例如,单词“bank”在“river bank”和“bank account”中得到相同的向量(如你所知,上下文可以通过注意力等概念来处理)。
- 关于嵌入的更多资源,你可能会觉得以下内容有帮助:
- 第2章:处理文本数据 (https://github.com/rasbt/LLMs-from-scratch/blob/main/ch02/01_main-chapter-code/ch02.ipynb)(这是一个大语言模型章节,但应该能让你理解嵌入单词或令牌的要点;在大语言模型分词器中,我们将单词拆分为子词令牌;在Word2Vec中,通常1个单词就是1个令牌。)
- 理解嵌入层和线性层之间的区别 (https://github.com/rasbt/LLMs-from-scratch/blob/main/ch02/03_bonus_embedding-vs-matmul/embeddings-and-linear-layers.ipynb)(这是一个图示,展示了在什么情况下嵌入向量在数学上等同于线性层和矩阵乘法。)
由于你们中的许多人可能熟悉循环神经网络(RNN),我将保持本节简短。RNN是自然语言处理中经典的首选神经网络架构,流行的变体可以追溯到20世纪80年代和90年代初。2017年引入的Transformer(并使用了最初在RNN中引入的注意力机制;参见我的《理解大语言模型》(https://magazine.sebastianraschka.com/p/understanding-large-language-models) 了解简要时间线),随后逐渐在许多自然语言处理应用中取代了它们。
RNN逐字读取序列(如文本)。在每一步,它们将当前单词嵌入(在前一节讨论)与来自前一步的隐藏状态相结合。我们可以将隐藏状态看作一个固定大小的向量,它总结了到目前为止处理过的文本,这使得单词顺序变得重要,因为重新排列单词会改变状态更新的序列。
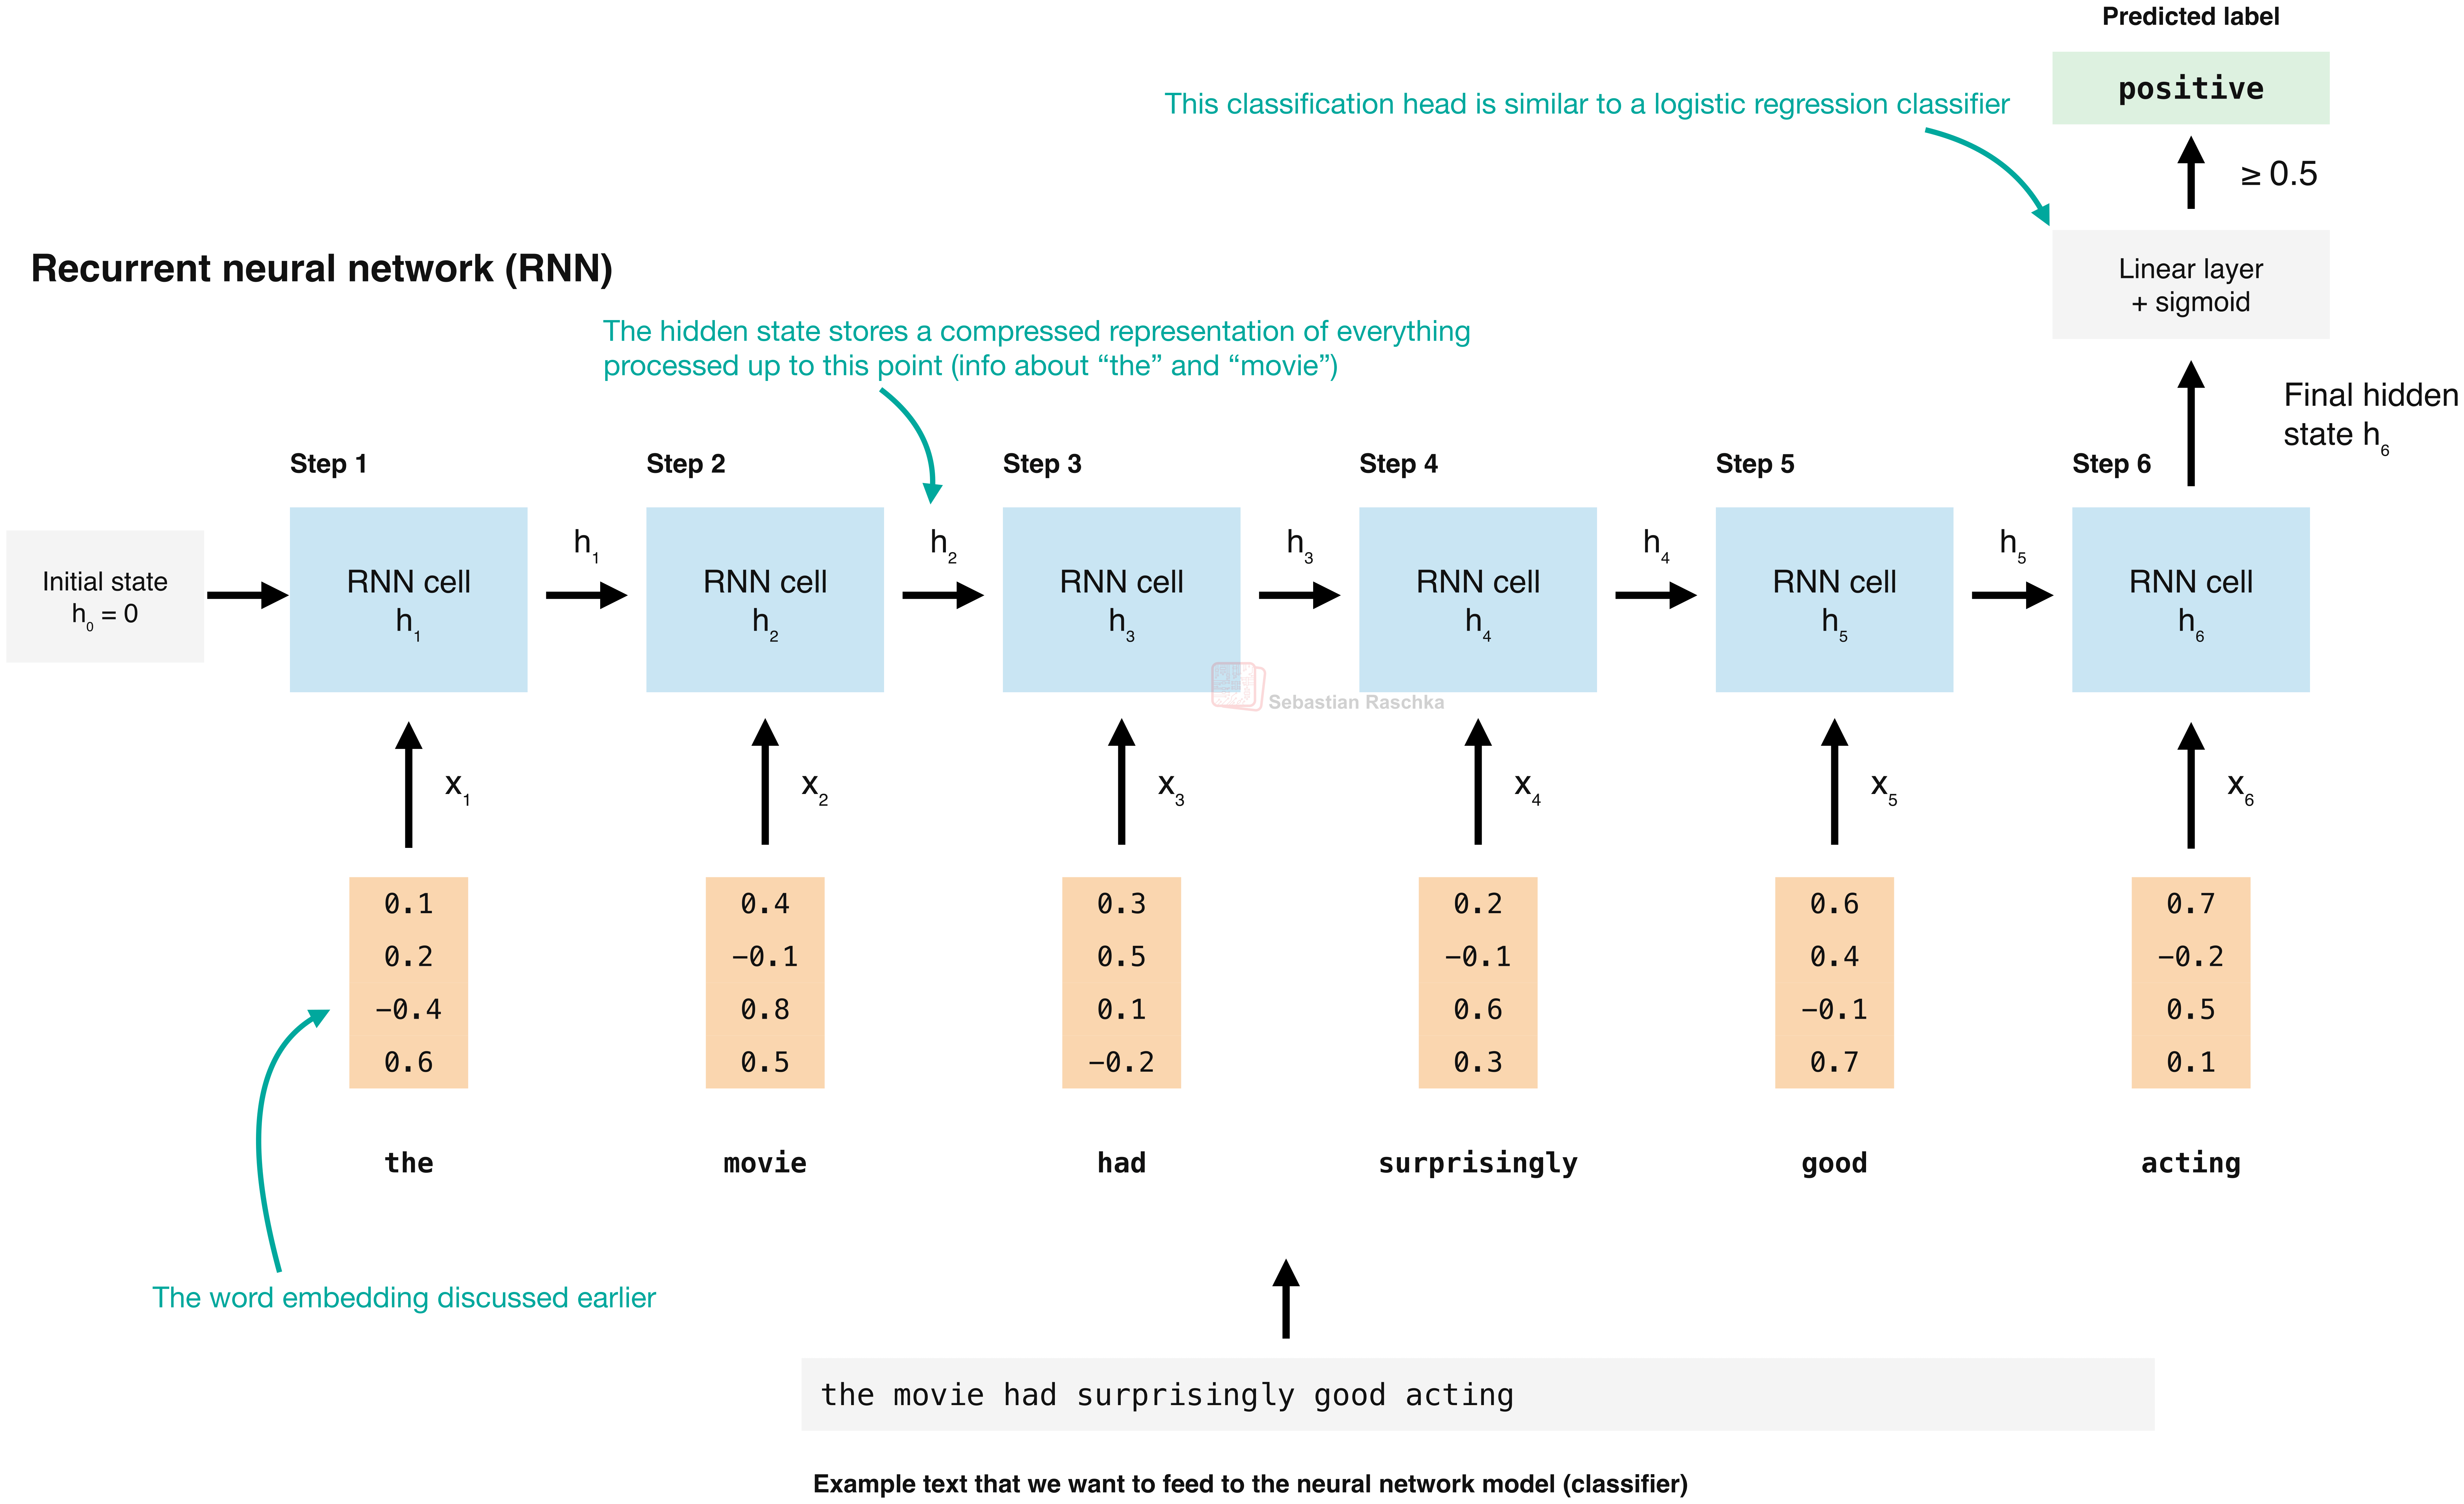
*图6:RNN分类器示意图。*
注意,上图显示的是展开形式的RNN。也就是说,RNN对每个输入都重用相同的层堆栈,因此有“循环”一词。而且因为它是“循环”的,所以输入文本可以具有任意长度。下图将“递归”与展开形式的表示并列说明。注意两者显示的是相同的架构,只是不同的可视化方式。
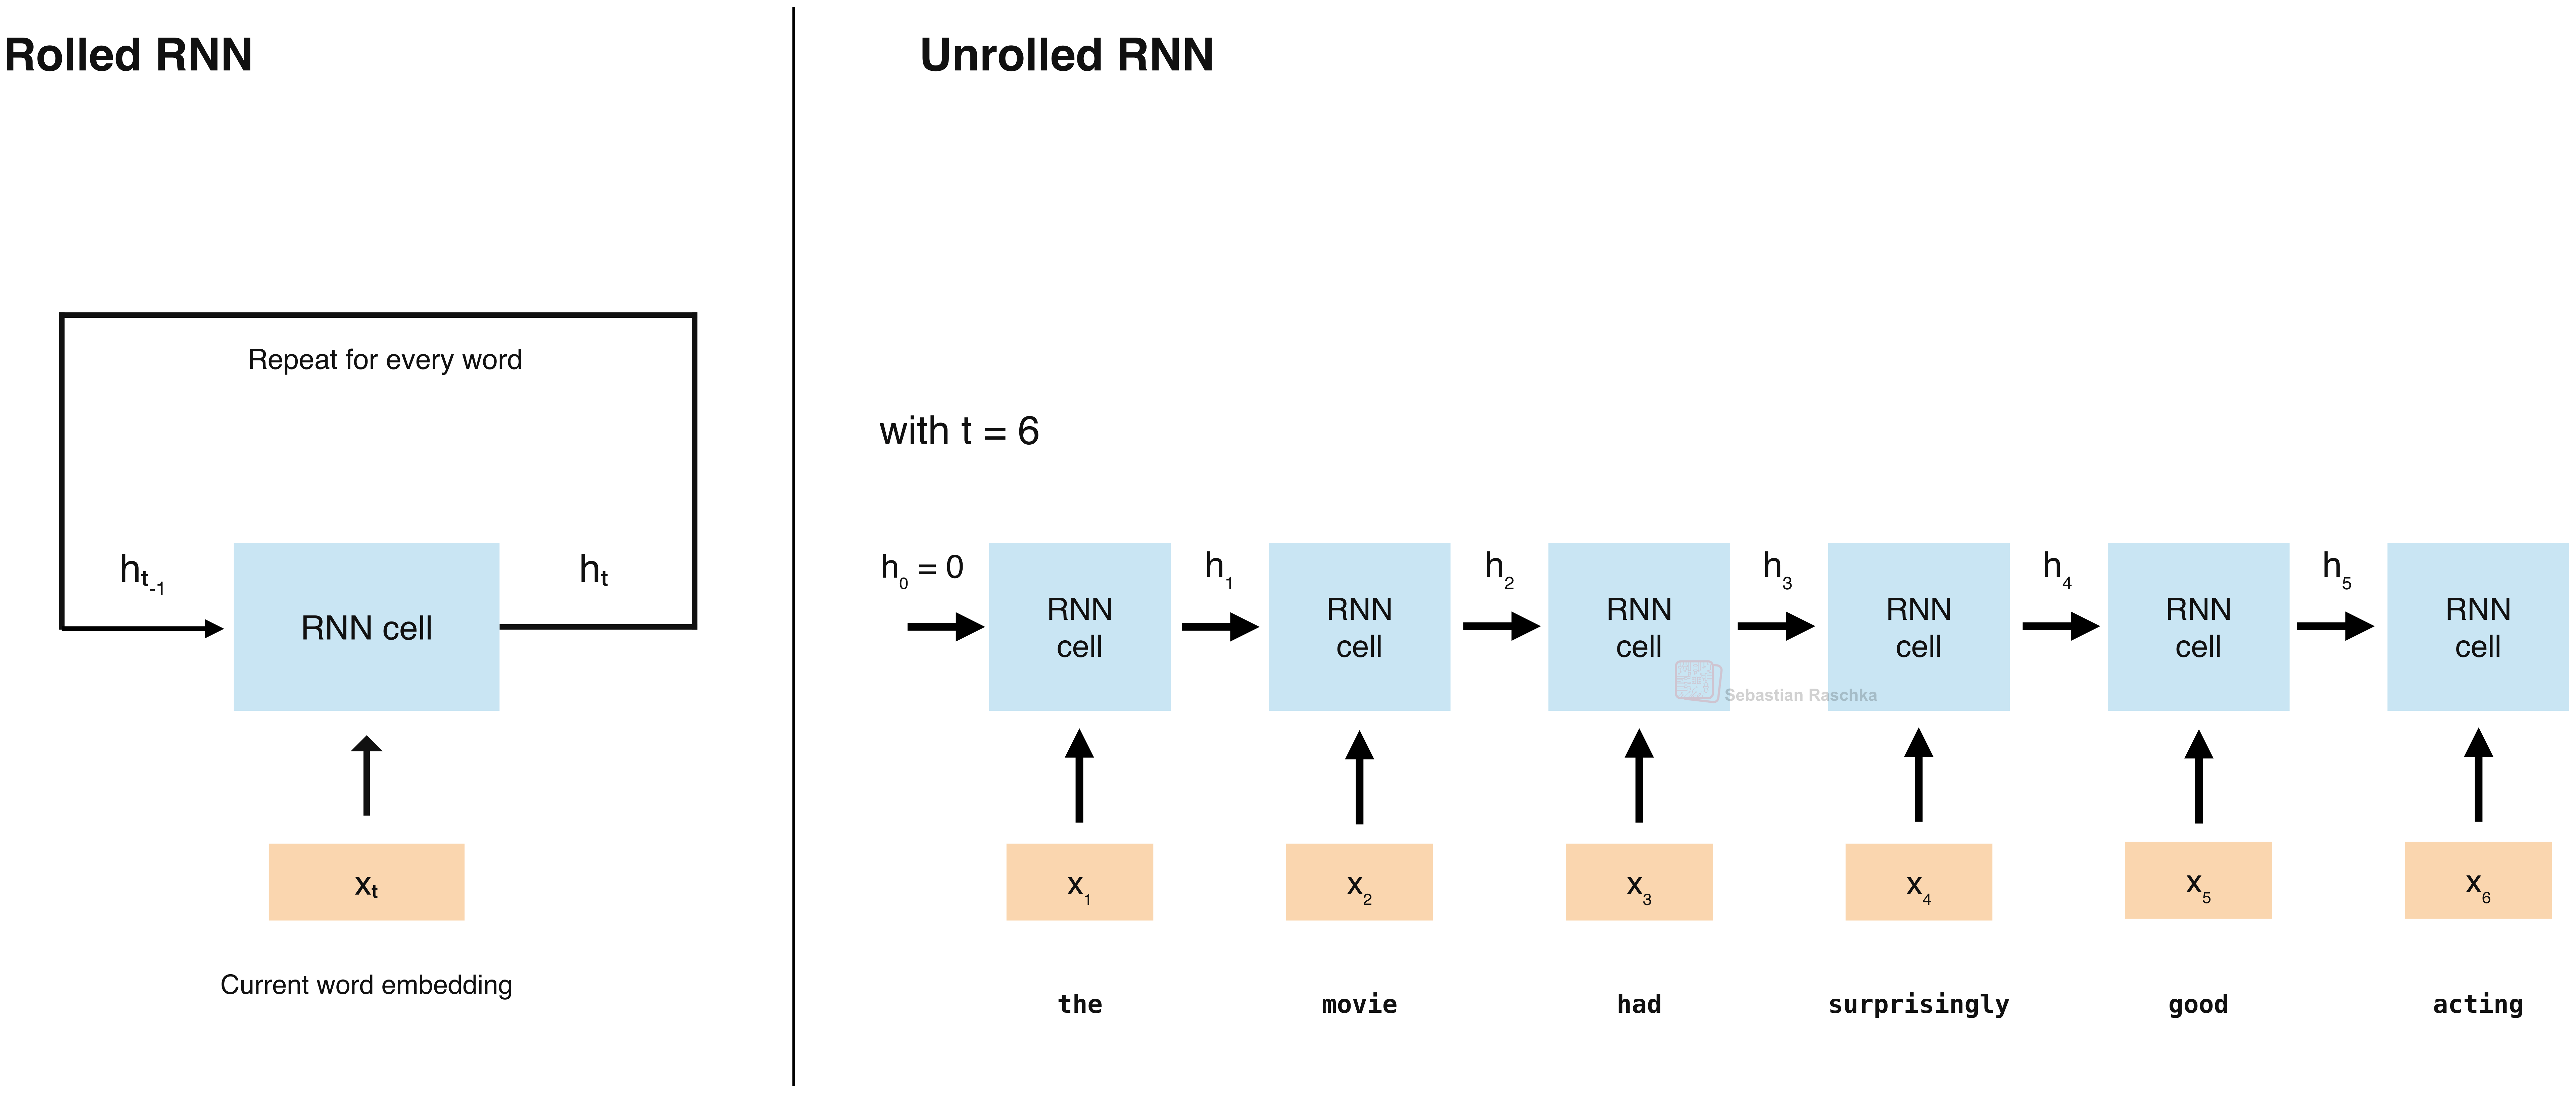
*图7:同一RNN的折叠与展开示意图。*
RNN以难以训练而闻名,对RNN有重要的改进,如1997年引入的长短期记忆 (https://www.bioinf.jku.at/publications/older/2604.pdf)(LSTM)网络和2014年引入的门控循环单元 (https://aclanthology.org/D14-1179/)(GRU),它们使用学习到的门来控制信息的保留和更新方式。(还有更近期的xLSTM:扩展长短期记忆 (https://proceedings.neurips.cc/paper_files/paper/2024/hash/c2ce2f2701c10a2b2f2ea0bfa43cfaa3-Abstract-Conference.html),于2024年引入。)
此外,状态空间模型也受到了这种顺序更新固定大小隐藏状态思想的启发,它比Transformer的注意力机制成本更低。然而,瓶颈仍然是隐藏状态能保留多少信息,并且它仍然必须顺序处理。(有趣的事实:注意力机制最初是为RNN开发的,然后才有了Transformer架构;但这是另一个故事了;我在我的《理解大语言模型》(https://magazine.sebastianraschka.com/p/understanding-large-language-models) 文章中写过。)
底线是,RNN可以用来训练文本分类器。
回到IMDb电影评论数据集,使用逻辑回归的词袋分类器在平衡数据集上达到了约89.9%的准确率,而LSTM RNN仅达到85.66%的准确率。是的,RNN可能更难训练(请继续关注下面的ULMFiT方法,它以更高的准确率训练RNN)。
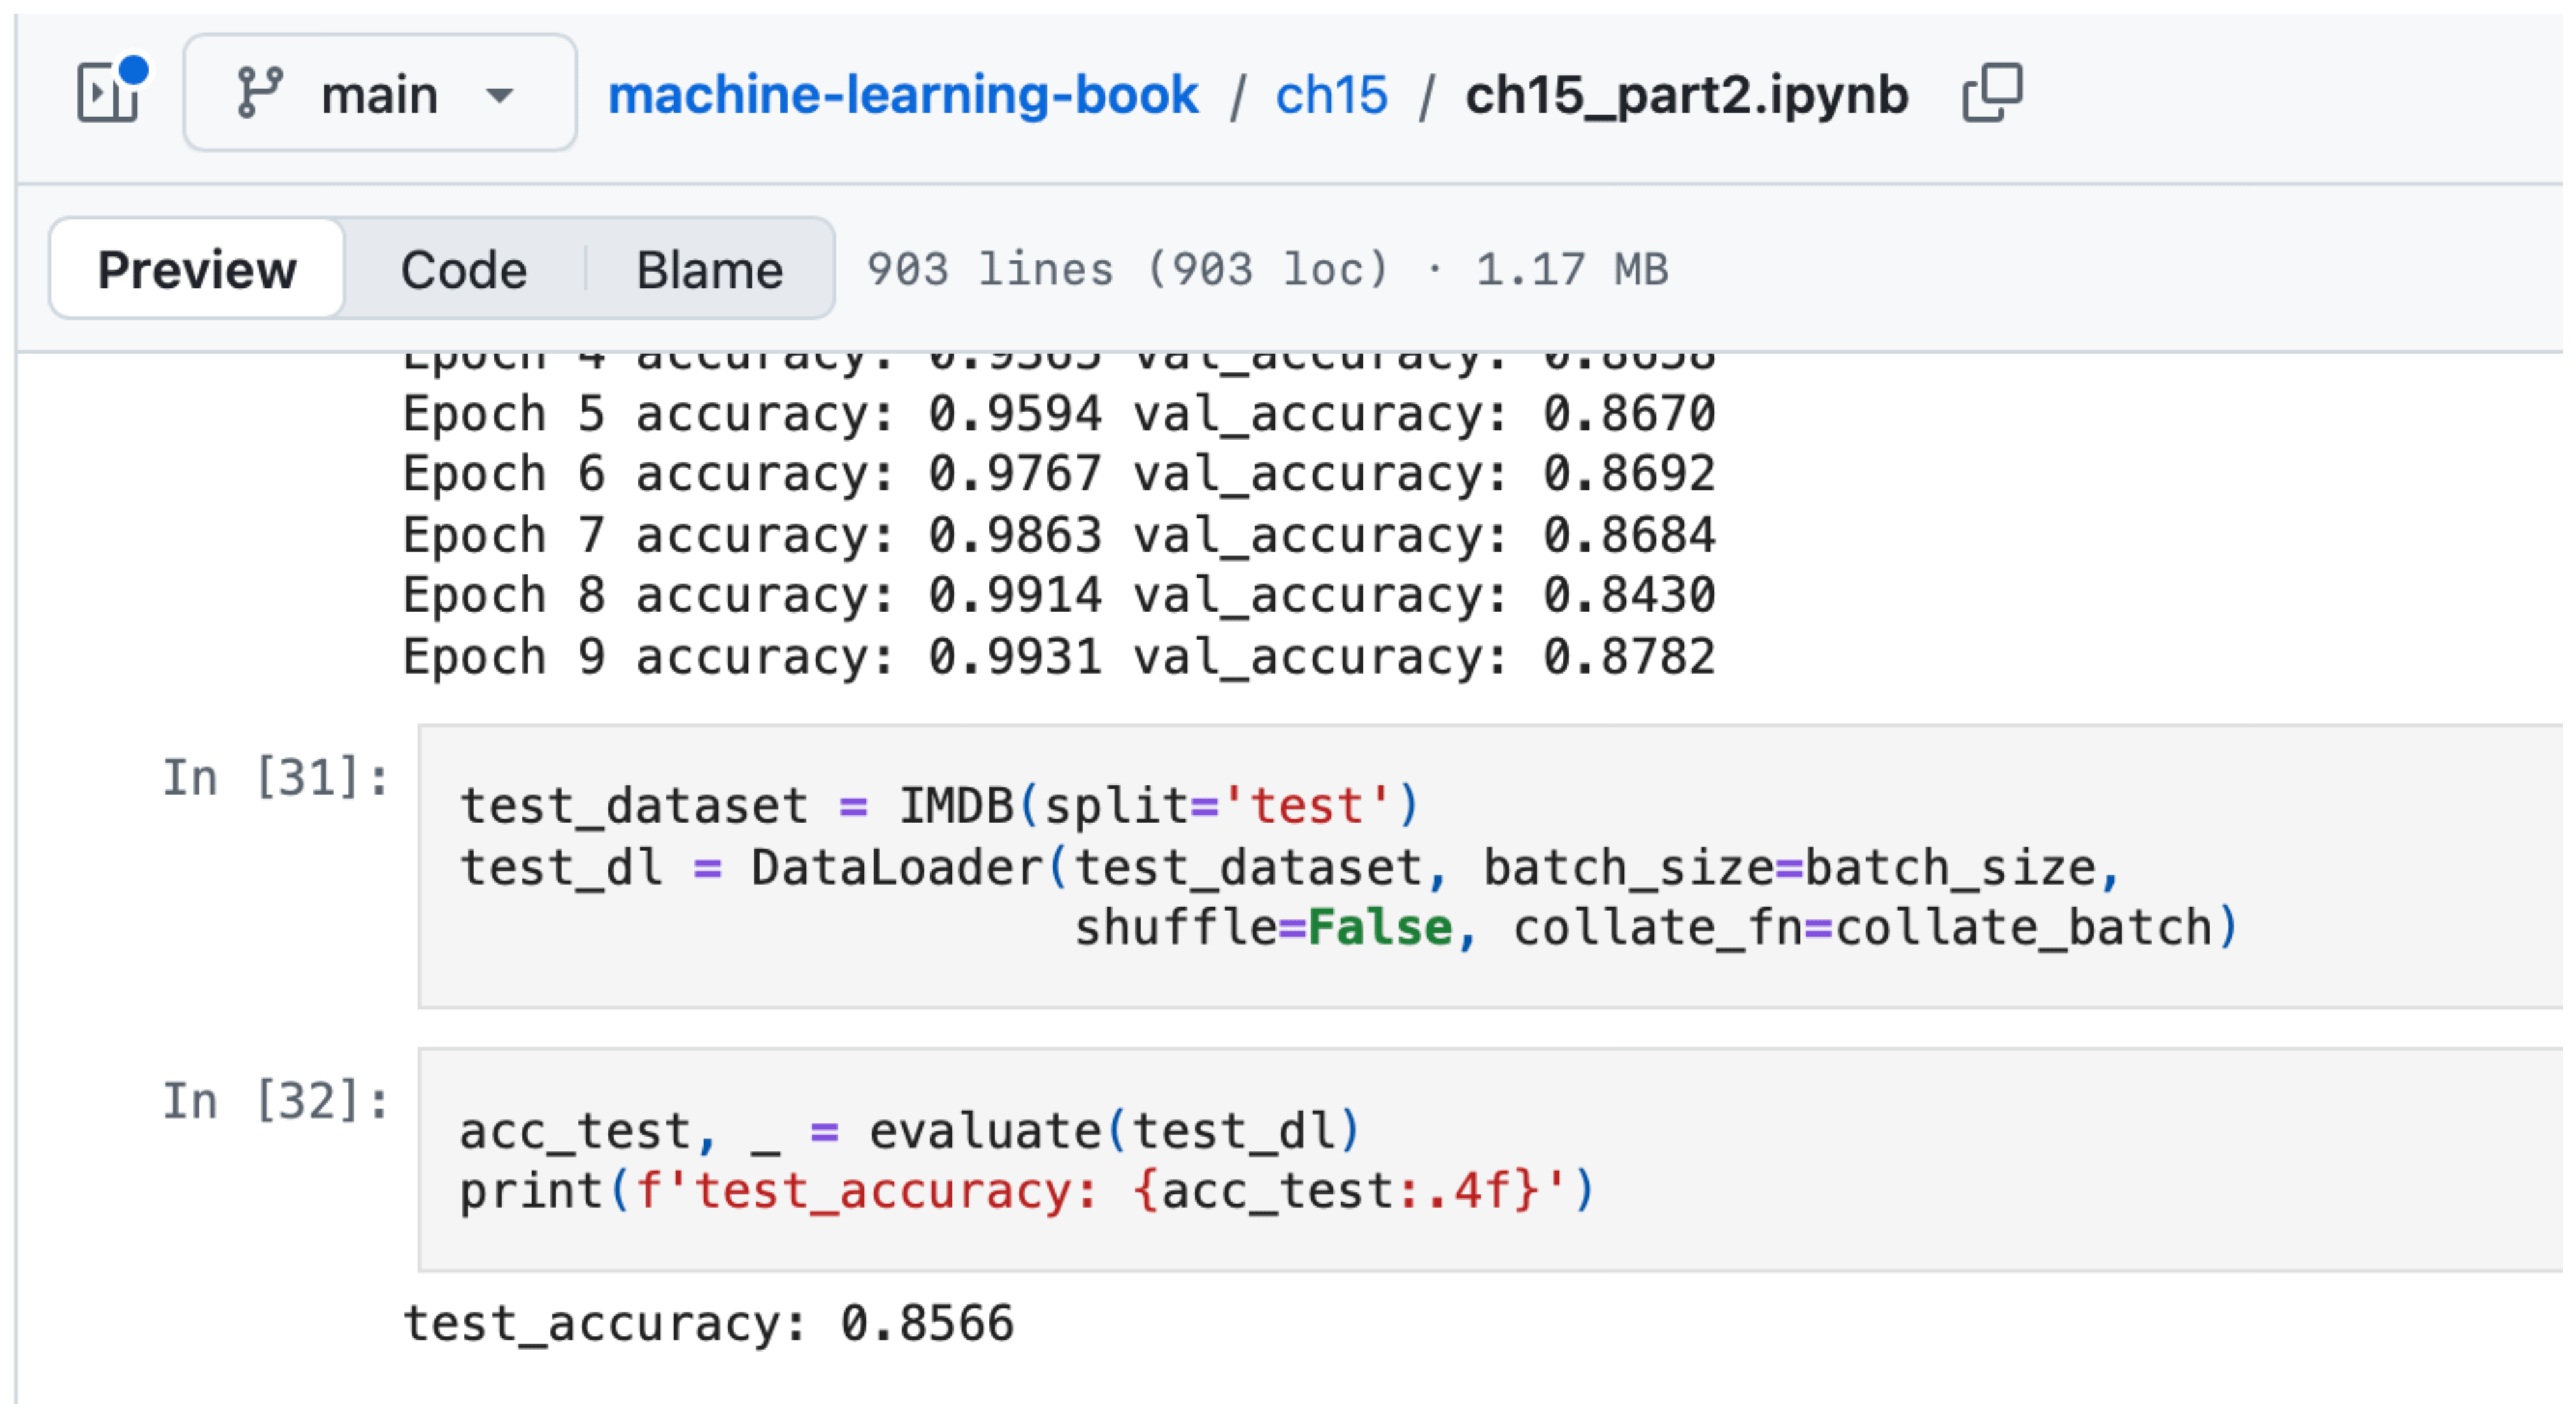
*图8:一个简单的LSTM RNN教程 (https://github.com/rasbt/machine-learning-book/blob/main/ch15/ch15_part2.ipynb)。该模型在平衡数据集上达到85.66%的准确率;较高的训练准确率表明存在明显的过拟合。注意这个RNN是从头开始训练的。*
更好的方法是先在更大的数据集上预训练模型,然后在目标数据集上对其进行微调(经典上,我们称这种方法为“迁移学习”)。在自然语言处理领域,提出这种方法最有影响力的论文之一是ULMFiT (https://arxiv.org/abs/1801.06146)(2018年),它在IMDb上取得了惊人的95.4%的测试准确率。
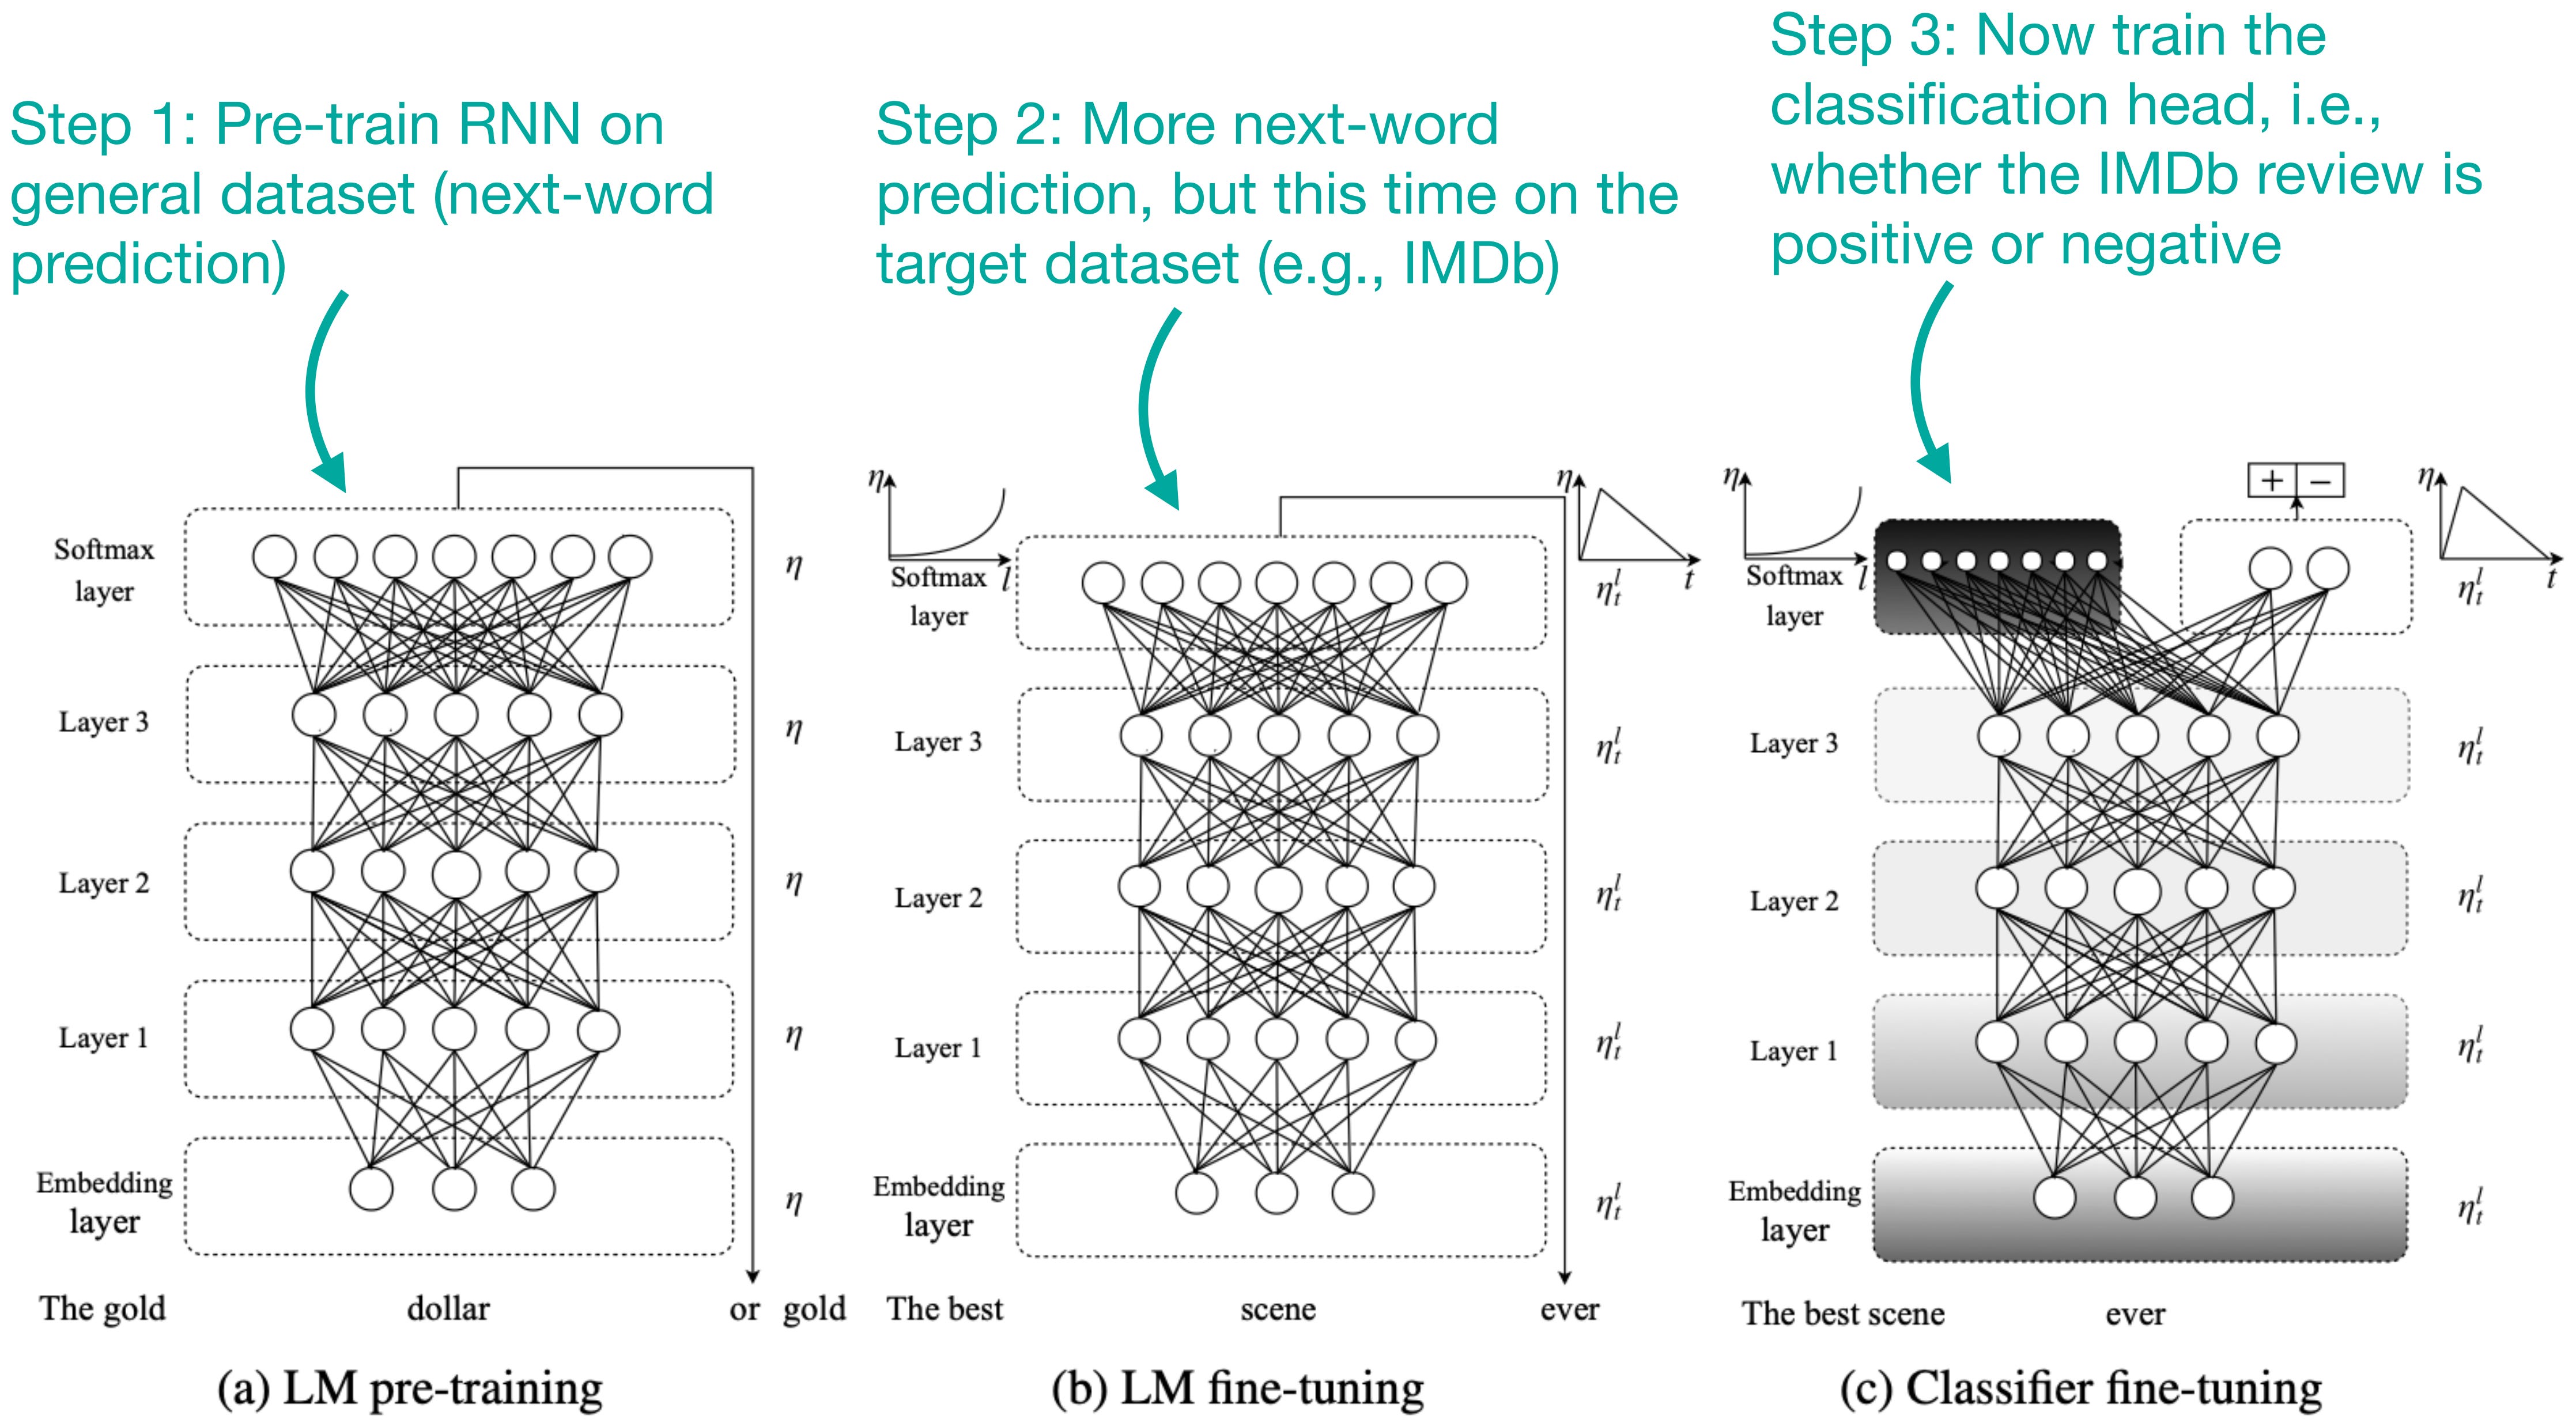
*图9:来自ULMFiT (https://arxiv.org/abs/1801.06146) 论文的标注图。*
你可能从计算机视觉中知道卷积神经网络(CNN)。然而,尽管历史上不太常见,但也可以将它们用于文本。
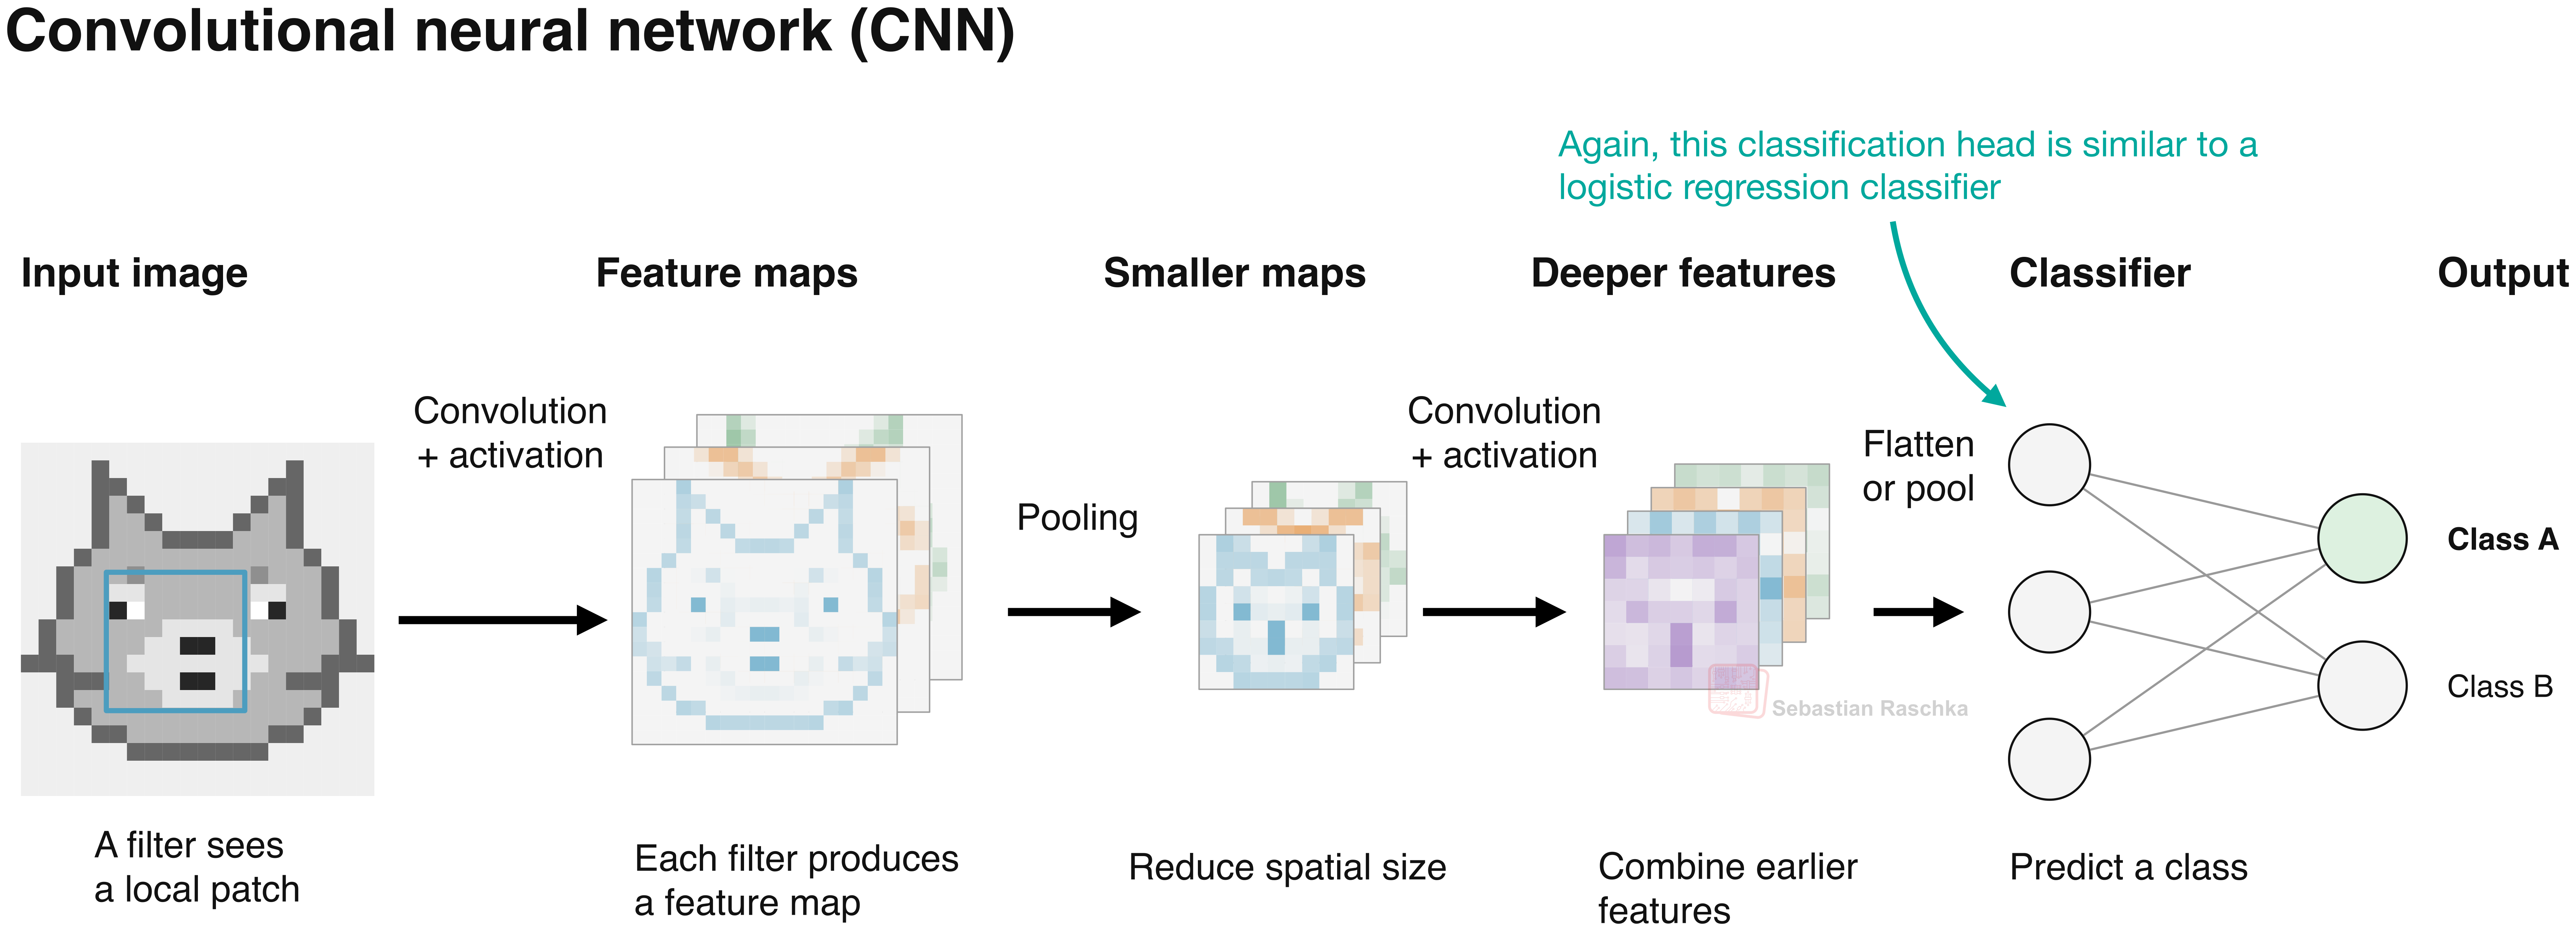
*图10:用于分类图像的卷积神经网络(CNN)示意图。*
如上图中图像分类示例所示,CNN将学习到的滤波器应用于图像块(窗口)。类似地,在自然语言领域,我们可以
相似文章
体验Jev——一种有趣的AI代理方法
作者讨论了尝试使用Jev,这是一种专注于决策的AI代理工具,与使用大型语言模型处理所有任务相比,它声称在速度和成本上有显著优势。
Jev 不是 LLM 杀手,也不仅仅是一个分类器。我们将其部署于生产环境并与真实用户一起使用。以下是我们学到的经验。
文章分享了使用 Jev(一个语义决策引擎)的生产见解,它通过与 LLMs 并行高效处理常规决策来增强 AI 代理系统,而不替代生成模型。
@rasbt: 花了点时间,但终于来了,一篇关于文本分类的语言模型的大型文章,当然也包括Jev。基本上是……
一篇关于文本分类的语言模型的全面视觉指南,包括动手实验,涉及RNNs、CNNs、transformers和校准技术。
Jev / TypesafeAI 在 LLM 领域堪称革命性
Jev 是一种新型 AI 模型,它输出评分、选择或二元决策,因其在创意查询时的速度、经济性和准确性而备受赞誉,不同于传统的前沿模型。
Typesafe的JEV模型作为LLM [P]
描述了一个对话AI系统,该系统使用Typesafe的Jev非生成模型,通过并行分类和评分从预写回复中选择,提供了一种成本效益高且透明的替代生成式LLM的方案。