unsloth/Qwen3.6-27B-NVFP4
摘要
Unsloth 发布了 Qwen3.6-27B 的 NVFP4 量化检查点,声称吞吐量提升 2.5 倍,精度与 FP8 和 BF16 相当,并提供了在 24GB GPU 上通过 vLLM 运行的说明。
查看缓存全文
缓存时间: 2026/07/12 22:52
unsloth/Qwen3.6-27B-NVFP4 · Hugging Face
来源:https://huggingface.co/unsloth/Qwen3.6-27B-NVFP4
查看 Unsloth Dynamic 2.0 GGUFs (https://unsloth.ai/docs/basics/unsloth-dynamic-v2.0-gguf) 以获取我们的量化基准测试结果。
- 吞吐量是其他 NVFP4 量化的 2.5 倍。
- 这是一个使用 Unsloth 数据集和 UltraChat 数据集的混合数据校准的 Unsloth NVFP4 量化检查点。
- 可在 24GB 显存的 GPU 上运行。基准测试基于 1 块 B200,128 并发。
https://huggingface.co/unsloth/Qwen3.6-27B-NVFP4#nvfp4-accuracy-benchmarks
NVFP4 精度基准测试
在精度基准测试方面,我们对 FP8、BF16、NVIDIA 的 NVFP4 以及我们的 NVFP4 进行了 MMLU-Pro、AIME 2025、GPQA 测试 —— 结果显示我们的快速量化在各项测试中表现相似:
| 提供方 | MMLU-Pro | GPQA | AIME 2025 |
|---|---|---|---|
| Unsloth NVFP4 | 86.25 | 86.34 | 93.12 |
| NVIDIA NVFP4 | 85.96 | 86.87 | 93.12 |
| FP8 | 86.11 | 86.87 | 93.75 |
| BF16 | 85.96 | 88.13 | 93.33 |
在 NVFP4 博客 中阅读所有基准测试结果。
https://huggingface.co/unsloth/Qwen3.6-27B-NVFP4#vllm-run-instructions
vLLM 运行说明
要在独立的虚拟环境中安装 vLLM:
uv venv unsloth-nvfp4-env --python 3.13
source unsloth-nvfp4-env/bin/activate
uv pip install "vllm>=0.25.0" "flashinfer-python>=0.6.13" "nvidia-cutlass-dsl>=4.5.2" \
    --torch-backend=auto
然后提供 27B NVFP4 量化服务:
vllm serve unsloth/Qwen3.6-27B-NVFP4 \
    --speculative-config '{"method": "mtp", "num_speculative_tokens": 2}'
另外,不要使用 Marlin 后端(因其慢 2 倍)—— 请使用原生的 vLLM 或 cute-DSL / CUTLASS / flashinfer_trtllm 后端!
| 模型 | 后端 | decode tok/s | 输出 tok/s |
|---|---|---|---|
| nvidia 27B | marlin (auto) | 115.6 | 2,403 |
| unsloth 27B | cute-DSL (auto) | 125.9 | 6,863 |
| nvidia 35B-A3B | marlin (auto) | 240.8 | 8,721 |
| unsloth 35B-A3B | cute-DSL + trtllm (auto) | 295.2 | 15,636 |
https://huggingface.co/unsloth/Qwen3.6-27B-NVFP4#dgx-spark
DGX Spark
必须使用以下设置,否则推理速度会慢 2 倍!
export CUTE_DSL_ARCH=sm_121a
vllm serve unsloth/Qwen3.6-27B-NVFP4 --moe-backend flashinfer_b12x
https://huggingface.co/unsloth/Qwen3.6-27B-NVFP4#multi-token-prediction-mtp
多 Token 预测(MTP)
该检查点包含 MTP 模块,因此它可以作为自身的推测草稿,实现更快的解码,但吞吐量略有下降。
vllm serve unsloth/Qwen3.6-27B-NVFP4 \
    --speculative-config '{"method": "mtp", "num_speculative_tokens": 2}'
Qwen Chat (https://chat.qwen.ai/)
该存储库包含训练后模型的权重和配置文件,格式为 Hugging Face Transformers。这些产物与 Hugging Face Transformers、vLLM、SGLang、KTransformers 等兼容。
继二月份发布 Qwen3.5 系列后,我们很高兴分享 Qwen3.6 的首个开放权重版本。基于社区的反馈,Qwen3.6 优先考虑稳定性和实际效用,为开发者提供更直观、更灵敏且真正高效的编码体验。
https://huggingface.co/unsloth/Qwen3.6-27B-NVFP4#qwen36-highlights
Qwen3.6 亮点
本次发布带来了重大升级,尤其是在以下方面:
- 智能编码(Agentic Coding):模型现在能够更流畅、更精确地处理前端工作流和仓库级别的推理。
- 思考保留(Thinking Preservation):我们引入了一个新选项,可以保留历史消息中的推理上下文,从而简化迭代开发并减少开销。
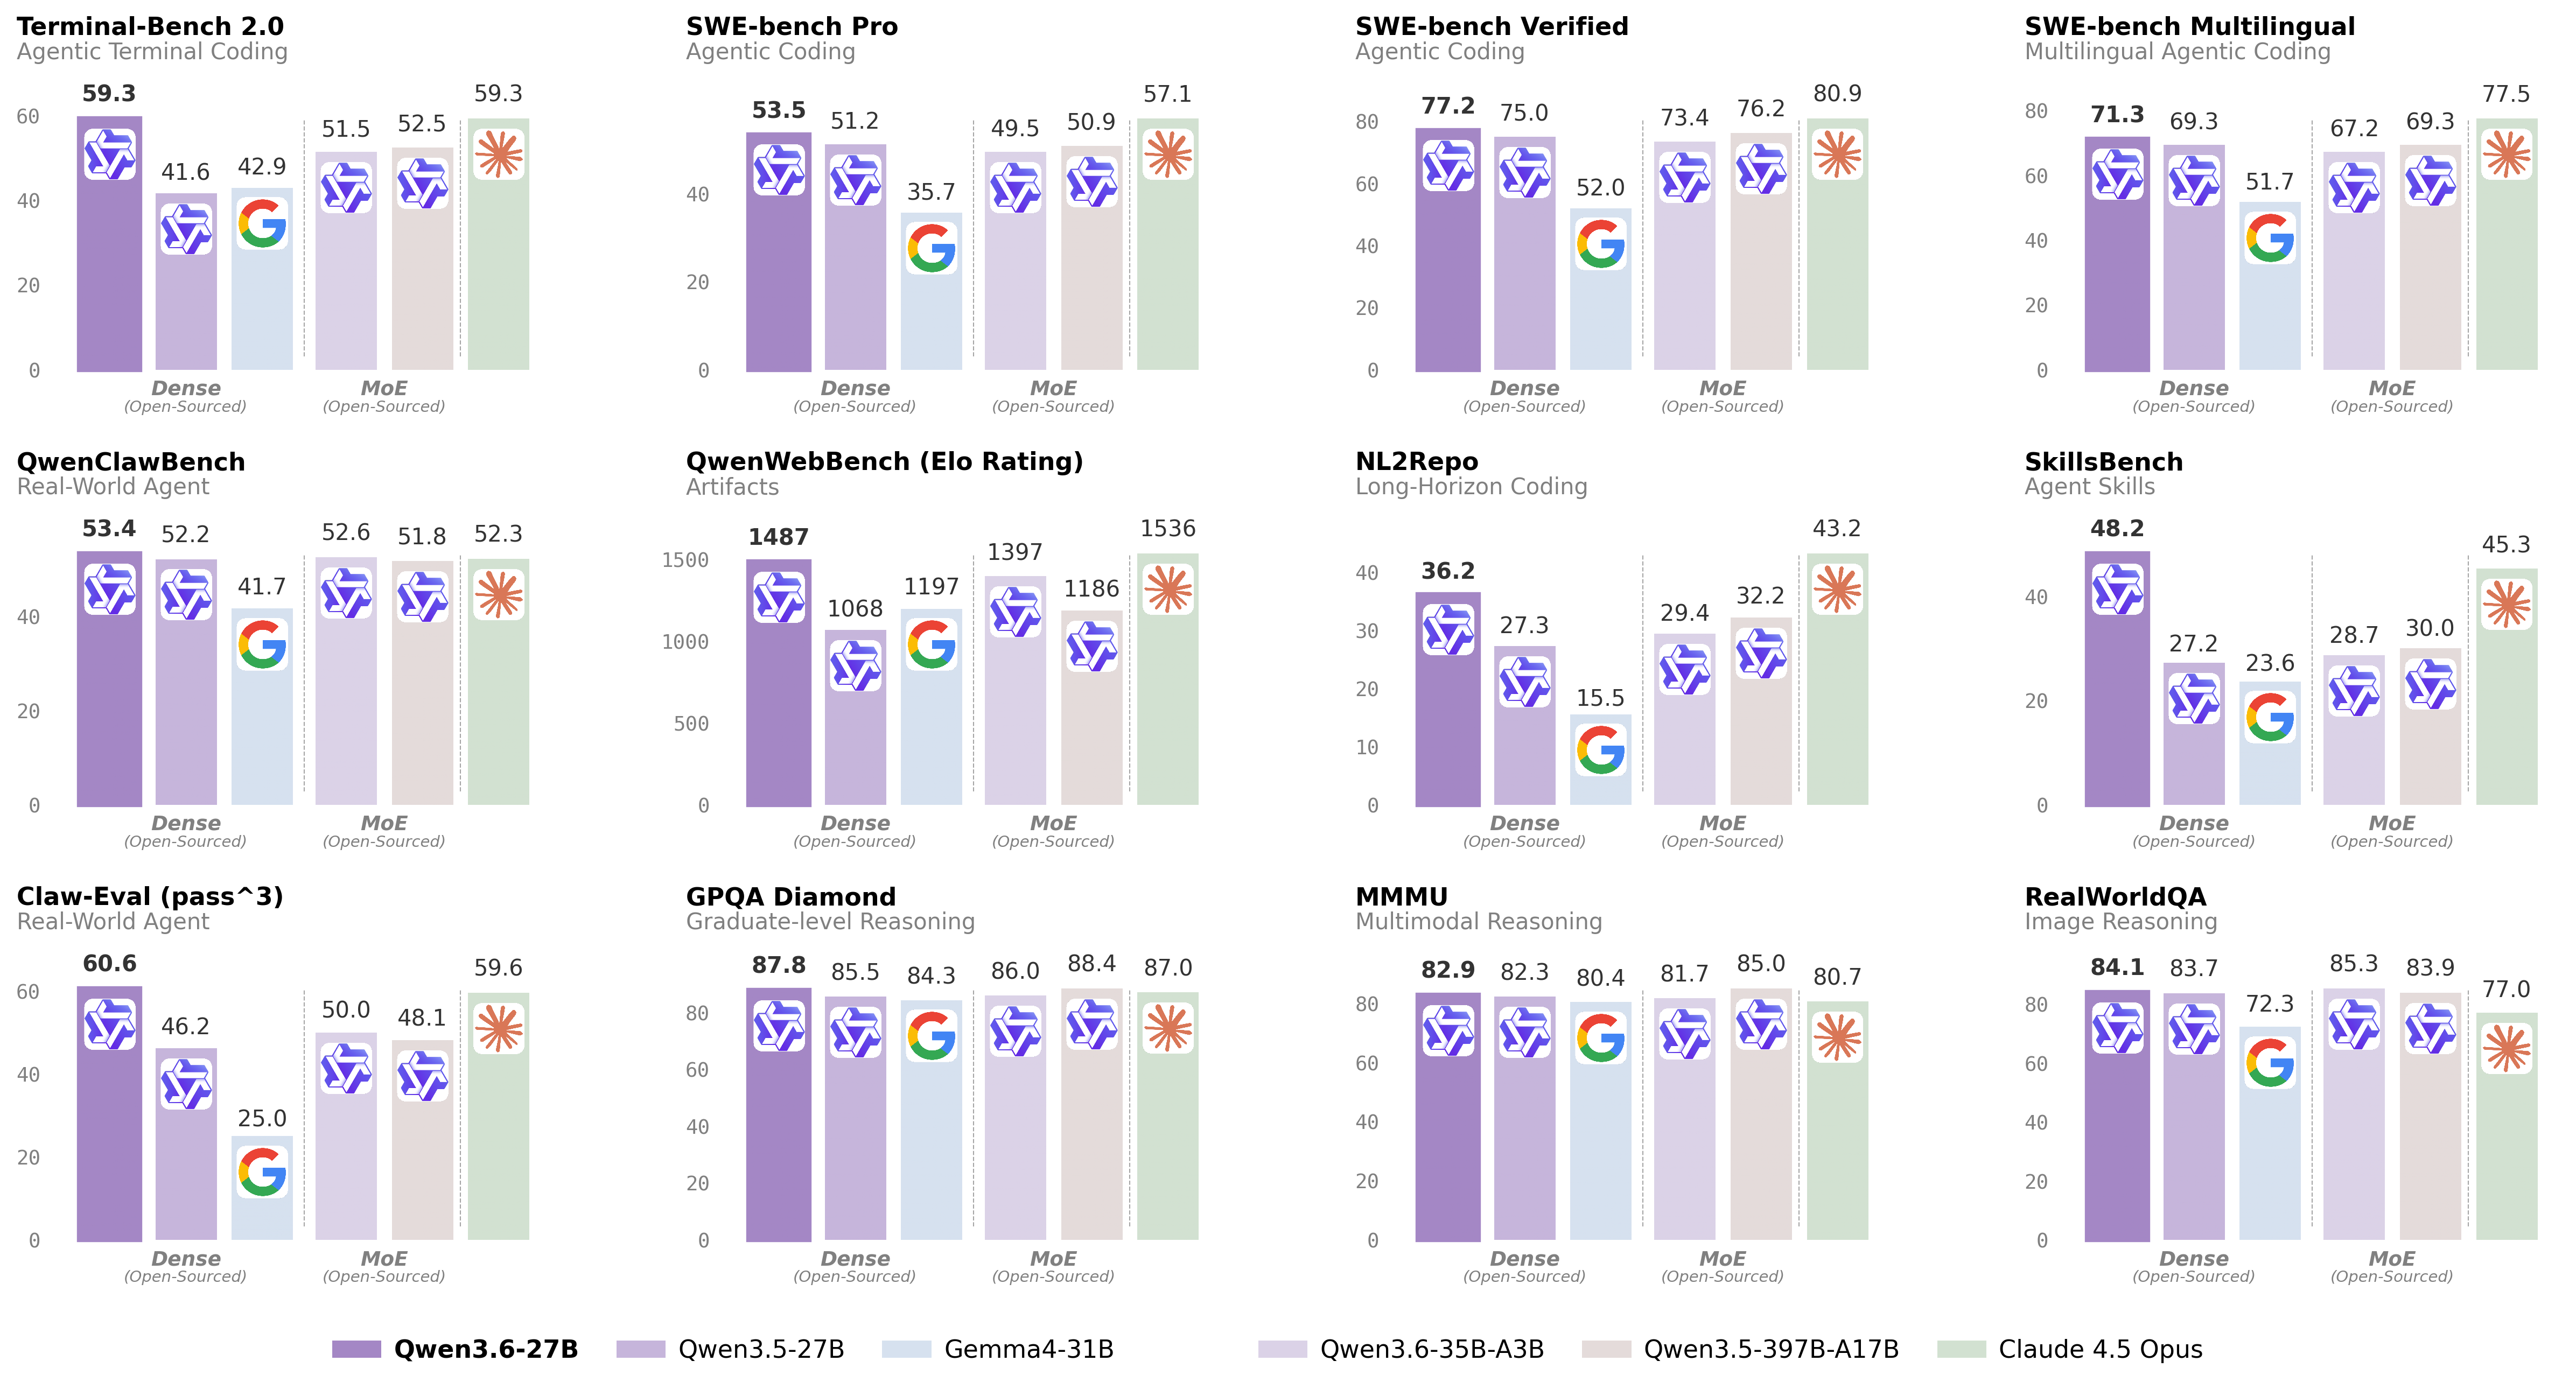
更多详情请参阅我们的博客文章 Qwen3.6-27B。
https://huggingface.co/unsloth/Qwen3.6-27B-NVFP4#model-overview
模型概述
- 类型:因果语言模型 + 视觉编码器
- 训练阶段:预训练 & 后训练
- 语言模型:
- 参数量:27B
- 隐藏层维度:5120
- Token 嵌入:248320(已填充)
- 层数:64
- 隐藏布局:16 × (3 × (门控 DeltaNet → FFN) → 1 × (门控注意力 → FFN))
- 门控 DeltaNet:
- 线性注意力头数:V 的 48 个,QK 的 16 个
- 头维度:128
- 门控注意力:
- 注意力头数:Q 的 24 个,KV 的 4 个
- 头维度:256
- 旋转位置嵌入维度:64
- 前馈网络:
- 中间层维度:17408
- LM 输出:248320(已填充)
- MTP:经过多步训练
- 上下文长度:原生 262,144,可扩展至最多 1,010,000 个 token。
https://huggingface.co/unsloth/Qwen3.6-27B-NVFP4#original-qwen36-bf16-reference-benchmarks
原始 Qwen3.6 BF16 参考基准测试
语言能力
| 项目 | Qwen3.5-27B | Qwen3.5-397B-A17B | Gemma4-31B | Claude 4.5 Opus | Qwen3.6-35B-A3B | Qwen3.6-27B |
|---|---|---|---|---|---|---|
| 编码 Agent | ||||||
| SWE-bench Verified | 75.0 | 76.2 | 52.0 | 80.9 | 73.4 | 77.2 |
| SWE-bench Pro | 51.2 | 50.9 | 35.7 | 57.1 | 49.5 | 53.5 |
| SWE-bench Multilingual | 69.3 | 69.3 | 51.7 | 77.5 | 67.2 | 71.3 |
| Terminal-Bench 2.0 | 41.6 | 52.5 | 42.9 | 59.3 | 51.5 | 59.3 |
| SkillsBench | 52 | 7.2 | 30.0 | 23.6 | 45.3 | 28.7 |
| QwenWebBench | 1068 | 1186 | 1197 | 1536 | 1397 | 1487 |
| NL2Repo | 27.3 | 32.2 | 15.5 | 43.2 | 29.4 | 36.2 |
| Claw-Eval | 64.3 | 70.7 | 48.5 | 76.6 | 68.7 | 72.4 |
| Claw-EvalPass^3 | 46.2 | 48.1 | 25.0 | 59.6 | 50.0 | 60.6 |
| QwenClawBench | 52.2 | 51.8 | 41.7 | 52.3 | 52.6 | 53.4 |
| 知识 | ||||||
| MMLU-Pro | 86.1 | 87.8 | 85.2 | 89.5 | 85.2 | 86.2 |
| MMLU-Redux | 93.2 | 94.9 | 93.7 | 95.6 | 93.3 | 93.5 |
| SuperGPQA | 65.6 | 70.4 | 65.7 | 70.6 | 64.7 | 66.0 |
| C-Eval | 90.5 | 93.0 | 82.6 | 92.2 | 90.0 | 91.4 |
| STEM 与推理 | ||||||
| GPQA Diamond | 85.5 | 88.4 | 84.3 | 87.0 | 86.0 | 87.8 |
| HLE | 24.3 | 28.7 | 19.5 | 30.8 | 21.4 | 24.0 |
| LiveCodeBench v6 | 80.7 | 83.6 | 80.0 | 84.8 | 80.4 | 83.9 |
| HMMT Feb 25 | 92.0 | 94.8 | 88.7 | 92.9 | 90.9 | 93.8 |
| HMMT Nov 25 | 89.8 | 92.7 | 87.5 | 93.3 | 89.1 | 90.7 |
| HMMT Feb 26 | 84.3 | 87.9 | 77.2 | 85.3 | 83.6 | 84.3 |
| IMOAnswerBench | 79.9 | 80.9 | 74.5 | 84.0 | 78.9 | 80.8 |
| AIME26 | 92.6 | 93.3 | 89.2 | 95.1 | 92.7 | 94.1 |
- SWE-Bench 系列:内部 Agent 脚手架(bash + file-edit 工具);temp=1.0,top_p=0.95,200K 上下文窗口。我们对 SWE-bench Pro 公开集中的一些有问题的任务进行了修正,并在修正后的基准上评估所有基线。
- Terminal-Bench 2.0:Harbor/Terminus-2 测试工具;3h 超时,32 CPU/48 GB RAM;temp=1.0,top_p=0.95,top_k=20,max_tokens=80K,256K 上下文;5 次运行的平均值。
- SkillsBench:通过 OpenCode 评估 78 个任务(自包含子集,排除依赖 API 的任务);5 次运行的平均值。
- NL2Repo:其他模型通过 Claude Code 评估(temp=1.0,top_p=0.95,max_turns=900)。
- QwenClawBench:基于真实用户分布的 Claw Agent 基准;temp=0.6,256K 上下文。
- QwenWebBench:内部前端代码生成基准;双语(EN/CN),7 个类别(Web 设计、Web 应用、游戏、SVG、数据可视化、动画、3D);自动渲染 + 多模态评判(代码/视觉正确性);BT/Elo 评分系统。
- AIME 26:我们使用完整的 AIME 2026(I 和 II),分数可能与 Qwen 3.5 说明中的不同。
视觉语言
| 项目 | Qwen3.5-27B | Qwen3.5-397B-A17B | Gemma4-31B | Claude 4.5 Opus | Qwen3.6-35B-A3B | Qwen3.6-27B |
|---|---|---|---|---|---|---|
| STEM 与谜题 | ||||||
| MMMU | 82.3 | 85.0 | 80.4 | 80.7 | 81.7 | 82.9 |
| MMMU-Pro | 75.0 | 79.0 | 76.9 | 70.6 | 75.3 | 75.8 |
| MathVistamini | 87.8 | - | 79.3 | - | 86.4 | 87.4 |
| DynaMath | 87.7 | 86.3 | 79.5 | 79.7 | 82.8 | 85.6 |
| VlmsAreBlind | 96.9 | - | 87.2 | - | 96.6 | 97.0 |
| 通用 VQA | ||||||
| RealWorldQA | 83.7 | 83.9 | 72.3 | 77.0 | 85.3 | 84.1 |
| MMStar | 81.0 | 83.8 | 77.3 | 73.2 | 80.7 | 81.4 |
| MMBench EN-DEV-v1.1 | 92.6 | - | 90.9 | - | 92.8 | 92.3 |
| SimpleVQA | 56.0 | 67.1 | 52.9 | 65.7 | 58.9 | 56.1 |
| 文档理解 | ||||||
| CharXivRQ | 79.5 | 80.8 | 67.9 | 68.5 | 78.0 | 78.4 |
| CC-OCR | 81.0 | 82.0 | 75.7 | 76.9 | 81.9 | 81.2 |
| OCRBench | 89.4 | - | 86.1 | - | 90.0 | 89.4 |
| 空间智能 | ||||||
| ERQA | 60.5 | 67.5 | 57.5 | 46.8 | 61.8 | 62.5 |
| CountBench | 97.8 | 97.2 | 96.1 | 90.6 | 96.1 | 97.8 |
| RefCOCOavg | 90.9 | 92.3 | - | - | - | 92.0 |
| EmbSpatialBench | 84.5 | - | - | - | - | 84.3 |
| RefSpatialBench | 67.7 | - | 4.7 | - | 64.3 | 70.0 |
| 视频理解 | ||||||
| VideoMME (w sub.) | 87.0 | 87.5 | - | 77.7 | 86.6 | 87.7 |
| VideoMMMU | 82.3 | 84.7 | 81.6 | 84.4 | 83.7 | 84.4 |
| MLVU | 85.9 | 86.7 | - | 81.7 | 86.2 | 86.6 |
| MVBench | 74.6 | 77.6 | - | 67.2 | 74.6 | 75.5 |
| 视觉 Agent | ||||||
| V* | 93.7 | 95.8 | - | 67.0 | 90.1 | 94.7 |
| AndroidWorld | 64.2 | - | - | - | - | 70.3 |
- 空单元格(–)表示分数尚未获得或不适用。
https://huggingface.co/unsloth/Qwen3.6-27B-NVFP4#quickstart
快速开始
为简化集成,我们建议通过 API 使用 Qwen3.6。以下是使用 OpenAI 兼容 API 的指南。
提供 Qwen3.6 服务
Qwen3.6 可以通过流行的推理框架实现 API 服务。下面我们展示了为 Qwen3.6 模型启动 OpenAI 兼容 API 服务器的示例命令。
不同框架的推理效率和吞吐量差异很大。我们建议使用最新的框架版本以确保最佳性能和兼容性。对于生产工作负载或高吞吐量场景,强烈推荐使用 SGLang、KTransformers 或 vLLM 等专用服务引擎。
该模型默认上下文长度为 262,144 个 token。如果遇到显存不足(OOM)错误,请考虑减小上下文窗口。然而,由于 Qwen3.6 利用长上下文处理复杂任务,我们建议至少保持 128K 的上下文长度以保留思考能力。
SGLang
SGLang 是一个用于大语言模型和视觉语言模型的快速服务框架。建议使用 sglang>=0.5.10,可在新环境中通过以下命令安装:
uv pip install sglang[all]
详细信息请参阅 其文档。
以下命令将在 http://localhost:8000/v1 创建 API 端点:
-
标准版本:以下命令可创建最大上下文长度 262,144 个 token 的 API 端点,使用 8 张 GPU 进行张量并行:
python -m sglang.launch_server --model-path Qwen/Qwen3.6-27B --port 8000 --tp-size 8 --mem-fraction-static 0.8 --context-length 262144 --reasoning-parser qwen3 -
工具使用:要支持工具使用,可以使用以下命令:
python -m sglang.launch_server --model-path Qwen/Qwen3.6-27B --port 8000 --tp-size 8 --mem-fraction-static 0.8 --context-length 262144 --reasoning-parser qwen3 --tool-call-parser qwen3_coder -
多 Token 预测(MTP):建议使用以下命令进行 MTP:
python -m sglang.launch_server --model-path Qwen/Qwen3.6-27B --port 8000 --tp-size 8 --mem-fraction-static 0.8 --context-length 262144 --reasoning-parser qwen3 --speculative-algo NEXTN --speculative-num-steps 3 --speculative-eagle-topk 1 --speculative-num-draft-tokens 4
详细部署指南请参见 SGLang Qwen3.5 Cookbook。
vLLM
vLLM 是此 NVFP4 检查点的推荐服务路径。建议使用 vllm>=0.19.0:
uv pip install vllm --torch-backend=auto
以下命令在 http://localhost:8000/v1 创建 OpenAI 兼容 API 端点:
vllm serve unsloth/Qwen3.6-27B-NVFP4 --trust-remote-code --dtype bfloat16 --max-model-len 4096
在检查可用 GPU 显存后再增加 --max-model-len。对于长上下文服务,请参考下面的 YaRN 说明,并将模型 ID 保持指向 unsloth/Qwen3.6-27B-NVFP4。
KTransformers
KTransformers 是一个灵活的框架,用于体验 CPU-GPU 异构计算的最先进 LLM 推理优化。使用 KTransformers 运行 Qwen3.6,请参见 KTransformers 部署指南。
Hugging Face Transformers
Hugging Face Transformers 包含一个轻量级服务,可用于快速测试和中度负载部署。Qwen3.6 需要最新的 transformers:
pip install "transformers[serving]"
详细信息请参阅 其文档。请同时确保安装 torchvision 和 pillow。然后运行 transformers serve 启动服务器,API 端点在 http://localhost:8000/v1;它会将模型放在可用的加速器上:
transformers serve Qwen/Qwen3.6-27B --port 8000 --continuous-batching
通过 Chat Completions API 使用 Qwen3.6
Chat Completions API 可通过标准 HTTP 请求或 OpenAI SDK 访问。这里我们展示使用 OpenAI Python SDK 的示例。开始前,确保已安装并配置好 API 密钥和 API 基础 URL,例如:
pip install -U openai
# 设置相应的环境变量
export OPENAI_BASE_URL="http://localhost:8000/v1"
export OPENAI_API_KEY="EMPTY"
我们建议在生成时使用以下采样参数组合:
- 思考模式(适用于一般任务):
temperature=1.0, top_p=0.95, top_k=20, min_p=0.0, presence_penalty=0.0, repetition_penalty=1.0- 思考模式(适用于精确编码任务,如 WebDev):
temperature=0.6, top_p=0.95, top_k=20, min_p=0.0, presence_penalty=0.0, repetition_penalty=1.0- 指令(或非思考)模式:
temperature=0.7, top_p=0.80, top_k=20, min_p=0.0, presence_penalty=1.5, repetition_penalty=1.0
请注意,不同推理框架对采样参数的支持有所不同。
Qwen3.6 模型默认以思考模式运行,在生成最终回答前会输出以\n...\n\n标识的思考内容。要禁用思考内容并直接获得响应,请参考 此处 的示例。
纯文本输入
from openai import OpenAI

# 通过环境变量配置
client = OpenAI()

messages = [
    {"role": "user", "content": '将 "I love Qwen3.6" 反向拼写'},
]

chat_response = client.chat.completions.create(
    model="Qwen/Qwen3.6-27B",
    messages=messages,
    max_tokens=81920,
    temperature=1.0,
    top_p=0.95,
    presence_penalty=0.0,
    extra_body={
        "top_k": 20,
    },
)

print("Chat response:", chat_response)
图像输入
from openai import OpenAI

# 通过环境变量配置
client = OpenAI()

messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image_url",
                "image_url": {
                    "url": "https://qianwen-res.oss-accelerate.aliyuncs.com/Qwen3.5/demo/CI_Demo/mathv-1327.jpg"
                }
            },
            {
                "type": "text",
                "text": "图中四个圆的圆心位于正方形的四个角。两个大圆彼此相切,同时也与两个小圆相切。要将小圆的半径乘以什么因子才能得到大圆的半径?\n选项:\n(A) $\\frac{2}{9}$\n(B) $\\sqrt{5}$\n(C) $0.8 \\cdot \\pi$\n(D) 2.5\n(E) $1+\\sqrt{2}$"
            }
        ]
    }
]

response = client.chat.completions.create(
    model="Qwen/Qwen3.6-27B",
    messages=messages,
    max_tokens=81920,
    temperature=1.0,
    top_p=0.95,
    presence_penalty=0.0,
    extra_body={
        "top_k": 20,
    },
)

print("Chat response:", response)
视频输入
from openai import OpenAI

# 通过环境变量配置
client = OpenAI()

messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "video_url",
                "video_url": {
                    "url": "https://qianwen-res.oss-accelerate.aliyuncs.com/Qwen3.5/demo/video/N1cdUjctpG8.mp4"
                }
            },
            {
                "type": "text",
                "text": "墓室主室壁龛中发现了多少件瓷器?"
            }
        ]
    }
]
相似文章
unsloth/Qwen3.8-27B-NVFP4
Unsloth 发布了 Qwen3.8-27B AI 模型的 NVFP4 量化版本,该模型在编码、专业工作、智能体任务和原生视觉语言理解方面提供了增强的能力。
2.5倍更快的Qwen3.6 NVFP4 Unsloth量化版本
Unsloth推出使用NVFP4格式的量化Qwen3.6模型,推理速度提升2.5倍。
@0xkeenz: 有意思,昨天刚好还在研究 Unsloth 和 NVIDIA 的 Qwen3.6 27B NVFP4 有什么区别,结果今天 Unsloth 就更新了! 新版 Unsloth 的量化思路和 NVIDIA 官方方案很类似:不再从 BF16 和 …
Unsloth 发布新版 Qwen3.6 27B NVFP4 量化方案,引入 FP8_E4M3 中间精度层并细化权重保护,在 24GB VRAM 上实现 2.5 倍速度提升,同时改进准确性和工具调用能力。
unsloth/Qwen3.6-27B-GGUF
Unsloth 发布了 Qwen3.6-27B 模型的 GGUF 量化版本,具备更强的智能体编程能力、工具调用功能,并支持 Unsloth Studio。
unsloth/Qwen3.6-27B-NVFP4 vs. Intel/Qwen3.6-27B-int4-AutoRound vs. nvidia/Qwen3.6-27B-NVFP4 —— 该选哪一个?
本文比较了 Qwen3.6-27B 的三种量化变体(Unsloth 和 Nvidia 的 NVFP4,Intel 的 int4-AutoRound),并向社区请求基准测试和幻觉数据。