@ProfTomYeh:自注意力与交叉注意力交互式图解。打开 https://byhand.ai/self-vs-cross
摘要
比较AI模型中自注意力和交叉注意力机制的交互式图解,作为注意力教育库的一部分发布。
查看缓存全文
缓存时间: 2026/09/20 07:17
自注意力与交叉注意力交互图示。打开 https://t.co/RgpT6ger01 https://t.co/FETxf0Zzql
自注意力与交叉注意力
来源:https://www.byhand.ai/p/library-models-attention-self-vs-cross
技术库 (https://www.byhand.ai/p/library)›注意力机制 (https://www.byhand.ai/p/library-series-models-attention)
- QKV投影 (https://www.byhand.ai/p/library-models-attention-qkv-projection)
- 注意力计算 (https://www.byhand.ai/p/library-models-attention-ktq-score)
- 自注意力 (https://www.byhand.ai/p/library-models-attention-self-attention)
- 交叉注意力 (https://www.byhand.ai/p/library-models-attention-cross-attention)
- 自注意力与交叉注意力对比
- 自注意力 (共享KV) (https://www.byhand.ai/p/library-models-attention-self-attention-shared-kv)
- 多头注意力 (https://www.byhand.ai/p/library-models-attention-mha)
- 融合QKV (多头) (https://www.byhand.ai/p/library-models-attention-fused-qkv)
- 单头vs多头注意力 (https://www.byhand.ai/p/library-models-attention-single-vs-multi-head)
- 多查询注意力 (https://www.byhand.ai/p/library-models-attention-multi-query-attention)
- 分组查询注意力 (https://www.byhand.ai/p/library-models-attention-gqa)
这是对前两篇文章的回顾,并排展示。
**上图:自注意力。**午夜时分,N位邻居都醒着,每个人都问:“谁家的狗在叫?“每位邻居都在询问其他所有邻居。得分矩阵是方阵:询问者与被询问者是同一批N个人。
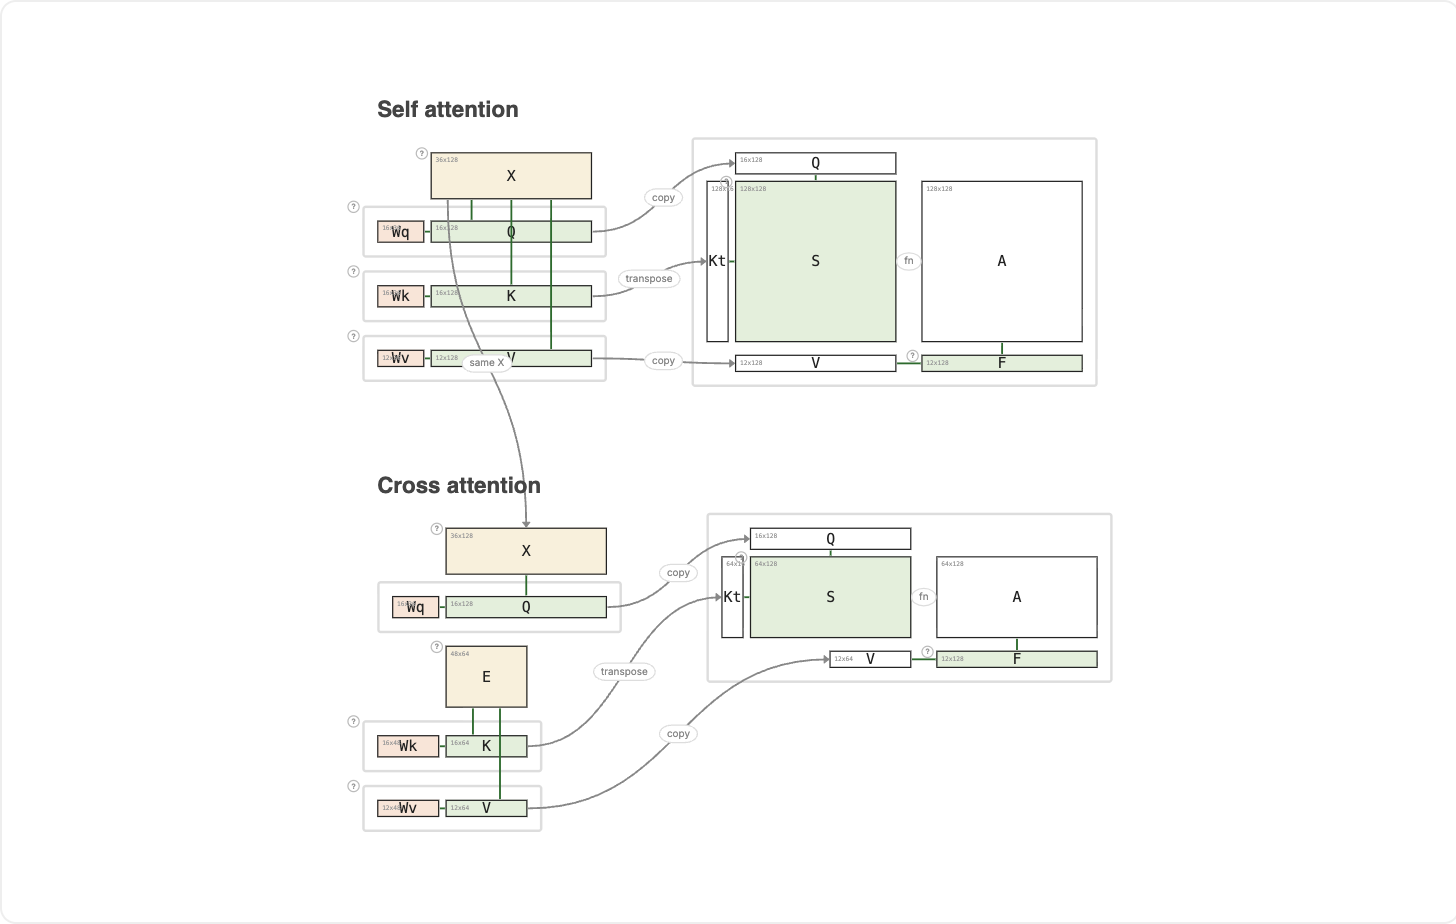
**下图:交叉注意力。**周六早晨,N位邻居要外出,询问M位青少年:“谁可以照看我的狗?“每位邻居询问每位青少年,但不询问彼此。得分矩阵是矩形:询问者与被询问者是两个不同的群体。
两者使用相同的X作为查询源。唯一区别在于键(K)和值(V)的来源。在自注意力中,K和V来自X本身;在交叉注意力中,K和V来自第二个序列E。正是这一改变使得矩阵从N×N变为N×M。
注意两者保持不变的要素:Q和K必须共享相同的键维度,因为点积KT×Q仅在两者处于同一空间时才成立。而V在两种情况下都可以自由设定维度。
下一项:6. 自注意力 (共享KV) (https://www.byhand.ai/p/library-models-attention-self-attention-shared-kv)
本文讨论区
想了解更多?
相似文章
@ProfTomYeh: 自编码器手绘交互图示。访问 https://byhand.ai/autoencoder ~ Tom Yeh 教授
Tom Yeh 教授分享了一个交互图示,用于学习自编码器,这是他专注于多层感知器的'AI by Hand'系列的一部分。
@thtrkim: FlashAttention 的手动可视化深入讲解(使用 Excalidraw 绘制)https://winterrykim.github.io/blog/2026/training-lm-…
深入理解 FlashAttention 的可视化讲解,涵盖内存优化和算子融合,以实现语言模型训练中的高效注意力计算。
Kuramoto注意力:在环面上同步自注意力
介绍了Kuramoto注意力,一种自注意力层,其中隐藏状态是环面上的相位角,通过门控余弦相似度和循环均值更新实现同步。该层在字符级语言建模上的性能与标准Transformer相当。
@_rohit_tiwari_: https://x.com/_rohit_tiwari_/status/2063982924714901858
本文提供了大型语言模型中Transformer架构的可视化指南,涵盖自注意力、因果自注意力、掩码多头注意力以及输出层,并附有逐步解释和示例。
IMPACT:注意力是可扩展交互感知世界模型训练的交互图
IMPACT是一个可扩展的框架,用于训练交互感知世界模型,通过使用交叉注意力作为内部交互图来重新加权去噪监督,在无需外部表示或推理时更改的情况下提升性能。