@cwolferesearch: 我刚刚发表了一篇关于智能体强化学习的博客,涵盖了该领域10多个最新框架。以下是关键要点……链接……
摘要
一篇博客文章,总结了十个最新的智能体强化学习框架和最佳实践,涵盖模块化接口、轨迹结构、动作掩码、过程奖励、优势归一化、可扩展的 rollout、稳定性/探索以及任务课程。
查看缓存全文
缓存时间: 2026/06/23 14:10
我刚刚发布了一篇关于智能体强化学习的博客,涵盖了该领域10多个最新的框架。以下是其中的关键要点… 博客链接:http://cameronrwolfe.substack.com/agentic-rl
(1) 模块化接口。几乎所有框架都为工具和环境引入了模块化接口;例如,HTTP接口或基于函数调用的抽象。通过模块化设计,我们可以轻松添加新任务、切换环境等,以最小的代码变更处理任意训练设置。
(2) 轨迹结构。与单轮 rollout 相比,智能体 rollout 包含的信息要多得多(即指令、生成的 token、工具调用、观测值、奖励和环境状态)。智能体强化学习框架必须超越将 rollout 表示为扁平 token 序列的方式。相反,我们通常使用步骤级表示,它精确存储每个步骤的 token,以避免重新分词导致的漂移。
(3) 动作掩码。大多数智能体强化学习论文通过一个二值动作掩码(将环境 token 置零)来确保只有智能体生成的 token 对策略梯度有贡献。然而,最近的研究表明,我们不必排除环境 token,而是可以:对智能体生成的 token 应用强化学习目标;对环境生成的 token 应用 SFT 目标。
(4) 过程奖励。近期大多数强化学习工作严重依赖结果奖励。这在智能体强化学习中也是如此,但长程任务受益于更丰富的信用分配机制。许多框架支持中间过程奖励,但过程奖励是否有益取决于具体应用。
(5) 优势归一化。一些智能体强化学习论文超越了 GRPO,使用了一种改进的优势估计技术,该技术对来自同一领域/环境的所有轨迹进行归一化。我们正在对整个任务或环境(大于分组)的优势进行归一化,以确保单个任务不会主导策略更新。
(6) 可扩展的 Rollout。智能体 rollout 在长度和完成时间上具有高方差,因此我们需要一种具有异步 rollout 生成的分离式架构。环境必须被容器化并托管在可扩展的基础设施上(例如,使用 Kubernetes),以避免成为瓶颈。
(7) 稳定性/探索。在长程跨度上训练智能体会引入新的失败模式,如多样性崩溃、多任务不稳定、陈旧/离策略数据等。许多方法被提出来解决这些问题;例如,对数据的陈旧性控制、跨策略采样以增强多样性,以及针对智能体的 GRPO 调整。
(8) 任务课程。当数据分布得到精心控制时,训练过程效果最佳,这能确保智能体接触到的任务是多样化的,并且在当前时刻是可学习的。数据可以通过课程学习随时间被选择、合成、过滤或调度(例如,先训练短程任务,然后逐步延长时间跨度)。
智能体强化学习:框架与最佳实践
来源:https://cameronrwolfe.substack.com/p/agentic-rl
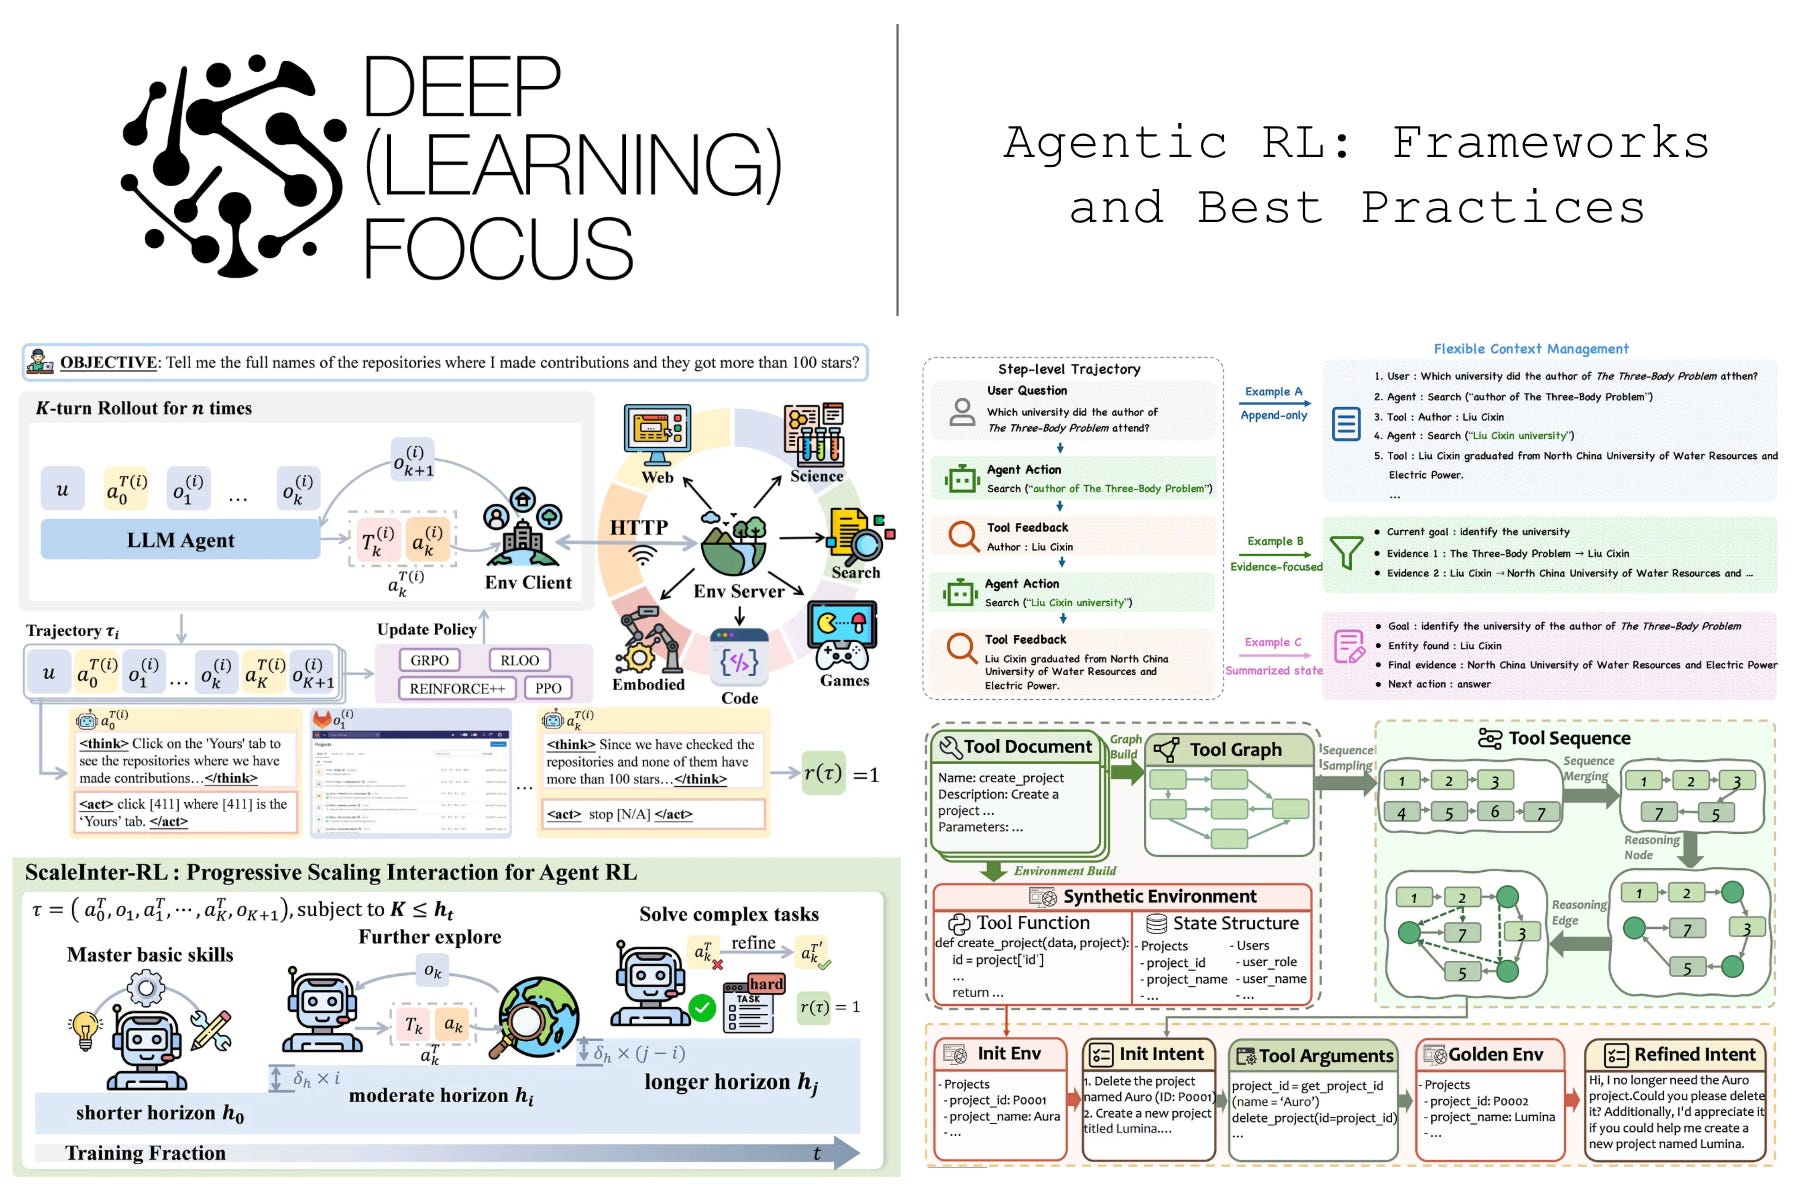
近期关于大型语言模型(LLM)的研究主要集中在推理和强化学习(RL)上。该领域的许多初期工作考虑的是静态任务,即 LLM 针对一个提示生成单一响应。然而,随着 AI 系统变得越来越具有智能体特性,这种单轮任务如今已不那么具有代表性。这些系统需要能够在长时间跨度上进行推理、调用工具、与用户交互,并能快速适应反馈。向自主功能的转变使得强化学习训练更加复杂,需要多轮轨迹、可扩展的 rollout 基础设施、模块化环境,以及用于多轮任务稳定学习的技巧。在本概述中,我们将研究近期关于 LLM 智能体强化学习训练的研究,并识别出构建功能性、高性能智能体强化学习系统的实用设计原则。
本概述的大部分内容将研究近期关于训练智能体强化学习的有用技术和框架。然而,要理解这些研究,我们首先需要对智能体和强化学习都有基础性的认识。一个智能体不仅仅是 LLM,但我们不需要过度复杂化对智能体的定义。在最简单的层面上,一个智能体只是一个运行在智能体循环(https://simonwillison.net/2025/Sep/18/agents/)中的 LLM,它利用工具和自身的推理能力来解决复杂问题。在本节中,我们将详细概述智能体的关键组成部分,并提供一个结构化的框架来理解智能体强化学习。
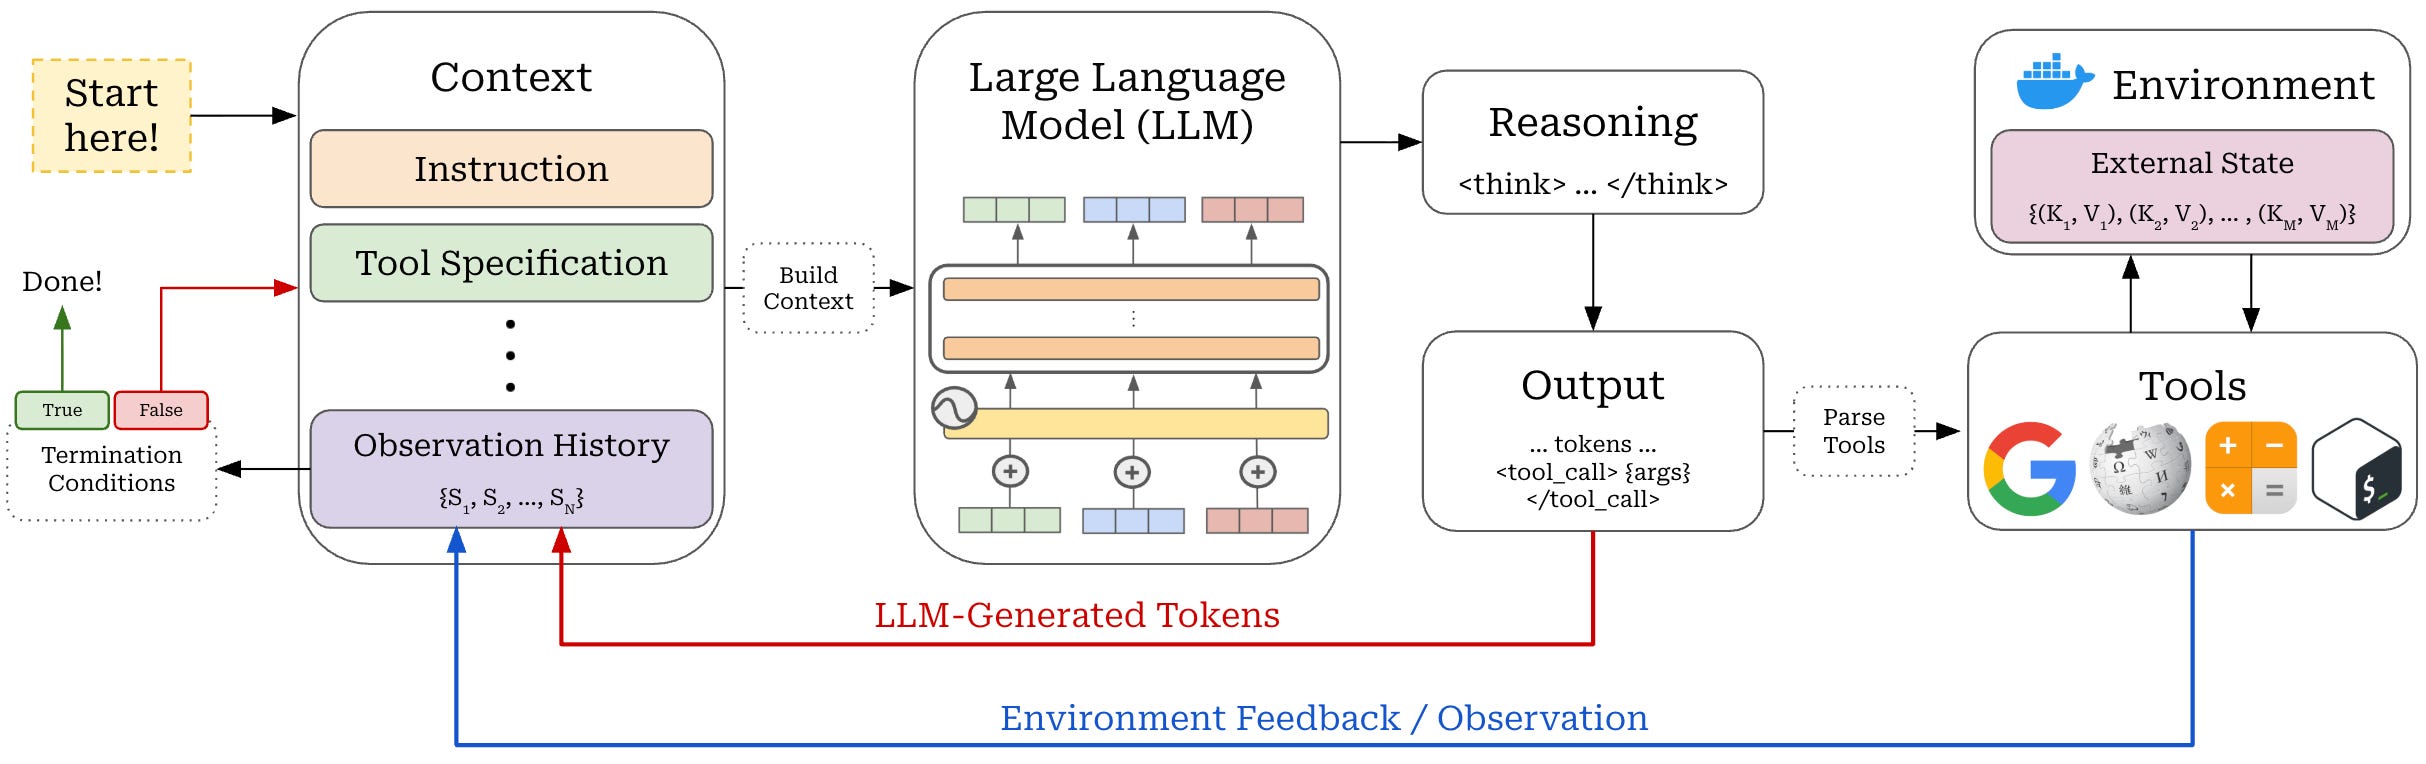
智能体循环
上图中提供了一个智能体系统的高级示意图。正如我们所看到的,一个智能体由许多组件组成,例如:
- LLM 骨干网络。
- 指令(Instructions)。
- 工具(Tools)。
- 环境(Environment)。
给定初始指令和规范,这些组件在一个智能体循环中运行。LLM 骨干网络生成输出,执行工具调用,接收来自环境的反馈,然后重复。在每一步,都会检查终止条件以判断循环是否应该继续,或者问题是否已解决。这些组件构成了一个控制 LLM 编排和集成细节的智能体夹具(Agent Harness)。我们现在将详细讨论每个组件。
智能体系统中的 LLM 骨干网络 只是一个经过训练、能够在智能体环境中运行的普通 LLM。具体来说,这个 LLM 必须能够在所提供的夹具中良好工作,这需要具备高级的指令遵循、工具调用和推理能力。虽然任何 LLM 都可以用作智能体骨干,但我们通常受益于使用推理模型(https://cameronrwolfe.substack.com/p/demystifying-reasoning-models);见下文。
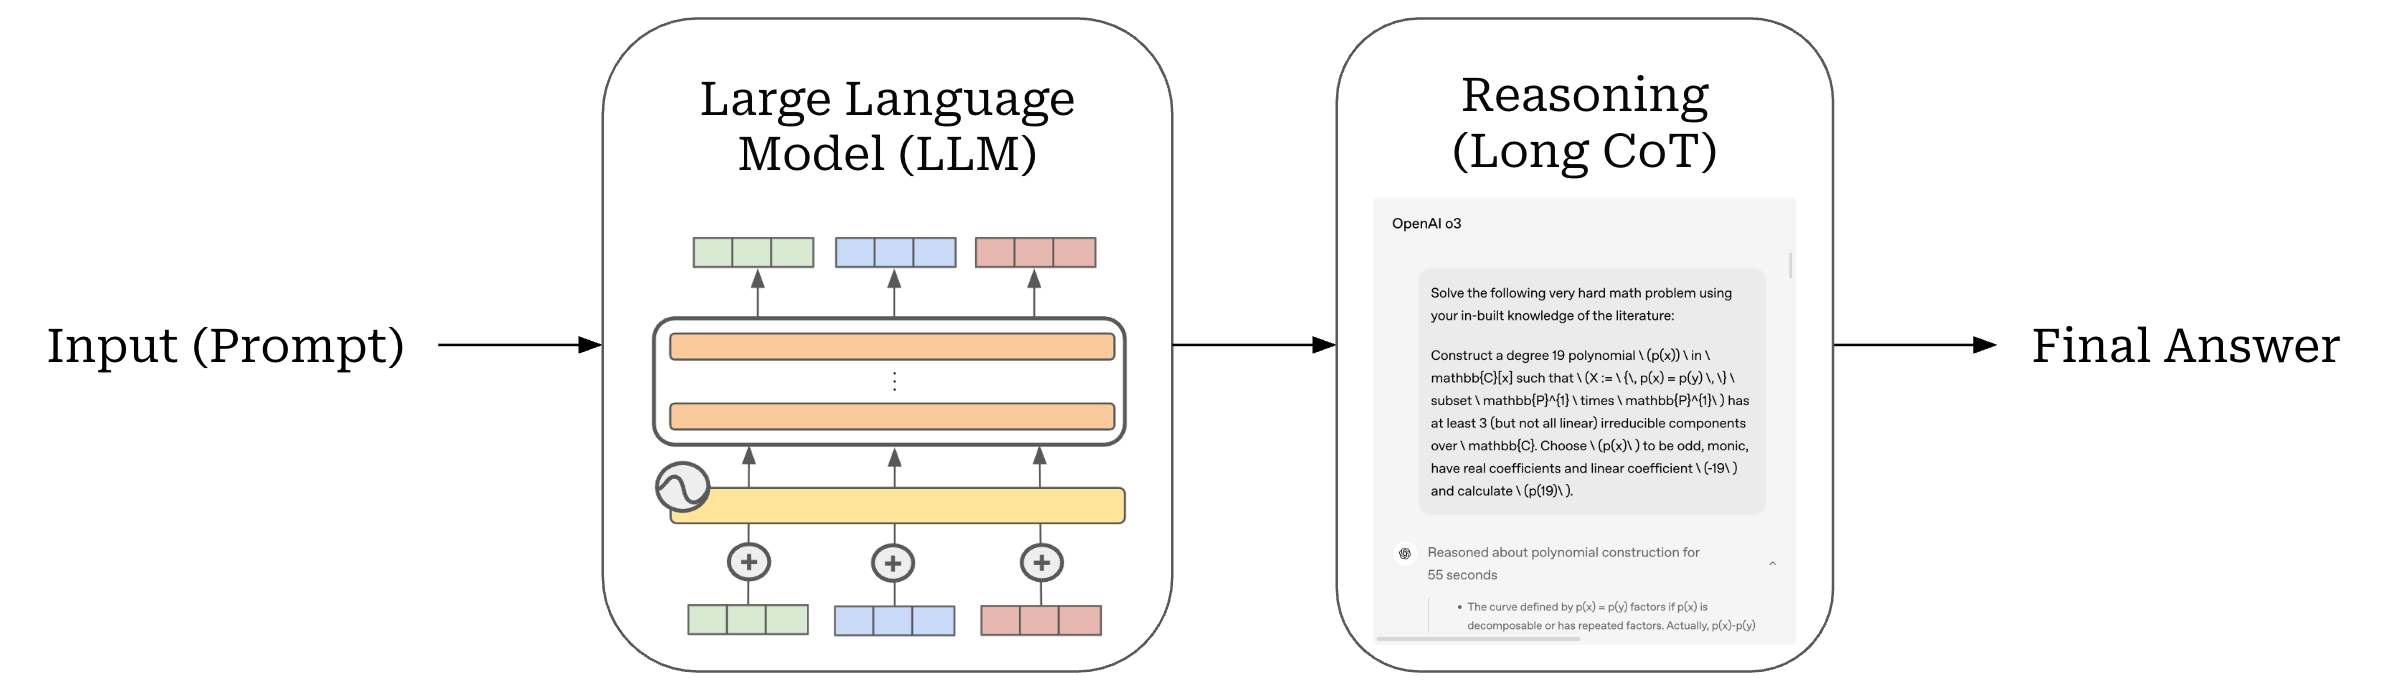
推理模型在最终输出前产生一个思考轨迹
为了解决多步骤任务,智能体必须能够将复杂问题分解为更小、更简单的部分,并逐一解决这些部分——可能借助工具——从而得出最终解决方案。此外,模型在解决问题时必须能够自我反思并从自身错误中恢复。以这种方式处理长程问题需要高水平的推理能力和可靠性。
“智能体倾向于一次做太多事情——本质上试图一次性完成应用……【为了解决这个问题】,我们……让智能体逐步、逐特性地工作……我们【然后】提示每个智能体朝着它的目标逐步前进,同时在会话结束时让环境保持一个干净的状态。” —— 来自 [9]
指令 为智能体提供解决问题所需的信息,以及帮助其正确解决问题的方法背景。我们应该向智能体提供相关的领域信息——通常取自现有的指南或策略文档。此外,我们可以提供关于任务或问题解决策略的指导,例如要求智能体将问题分解为更小的步骤、维护已完成子任务的任务清单、在解决方案中遵循特定风格,甚至在其解决问题过程中复核每一步。智能体指令应在简单性和具体性之间取得平衡。我们希望指令足够详细,以可靠地指导智能体行为,但又不能过于详细,以至于变得脆弱且难以维护。
工具与环境。 为了与外部环境交互,LLM 需要能够使用像 API、CLI 或 MCP 服务器(https://modelcontextprotocol.io/docs/getting-started/intro)这样的工具。例如,如果我们希望智能体为我们预订当地餐厅的桌位,我们可以简单地教模型如何构造对 OpenTable API 的调用。通过创建一组特殊的工具调用令牌(token)并教导 LLM 如何使用这些令牌,工具调用可以直接在 LLM 的令牌流中表示;见下文。

例如,Qwen3 模型通过 XML 风格的分隔符处理工具调用:
和用于封装工具定义。和用于封装特定的工具调用,包括要调用的工具和相关参数。和用于封装被调用工具返回的结果或响应。
在智能体指令中,我们在 标签之间提供所有工具的规范,使 LLM 理解有哪些工具可用以及如何调用它们。当 LLM 生成输出时,可以通过输出一个包含正确参数的 序列来调用工具。令牌会触发生成过程停止,以便可以解析并执行工具调用(https://docs.vllm.ai/en/stable/features/tool_calling/)。工具调用的结果是对环境的观测或反馈,封装在 标签中。
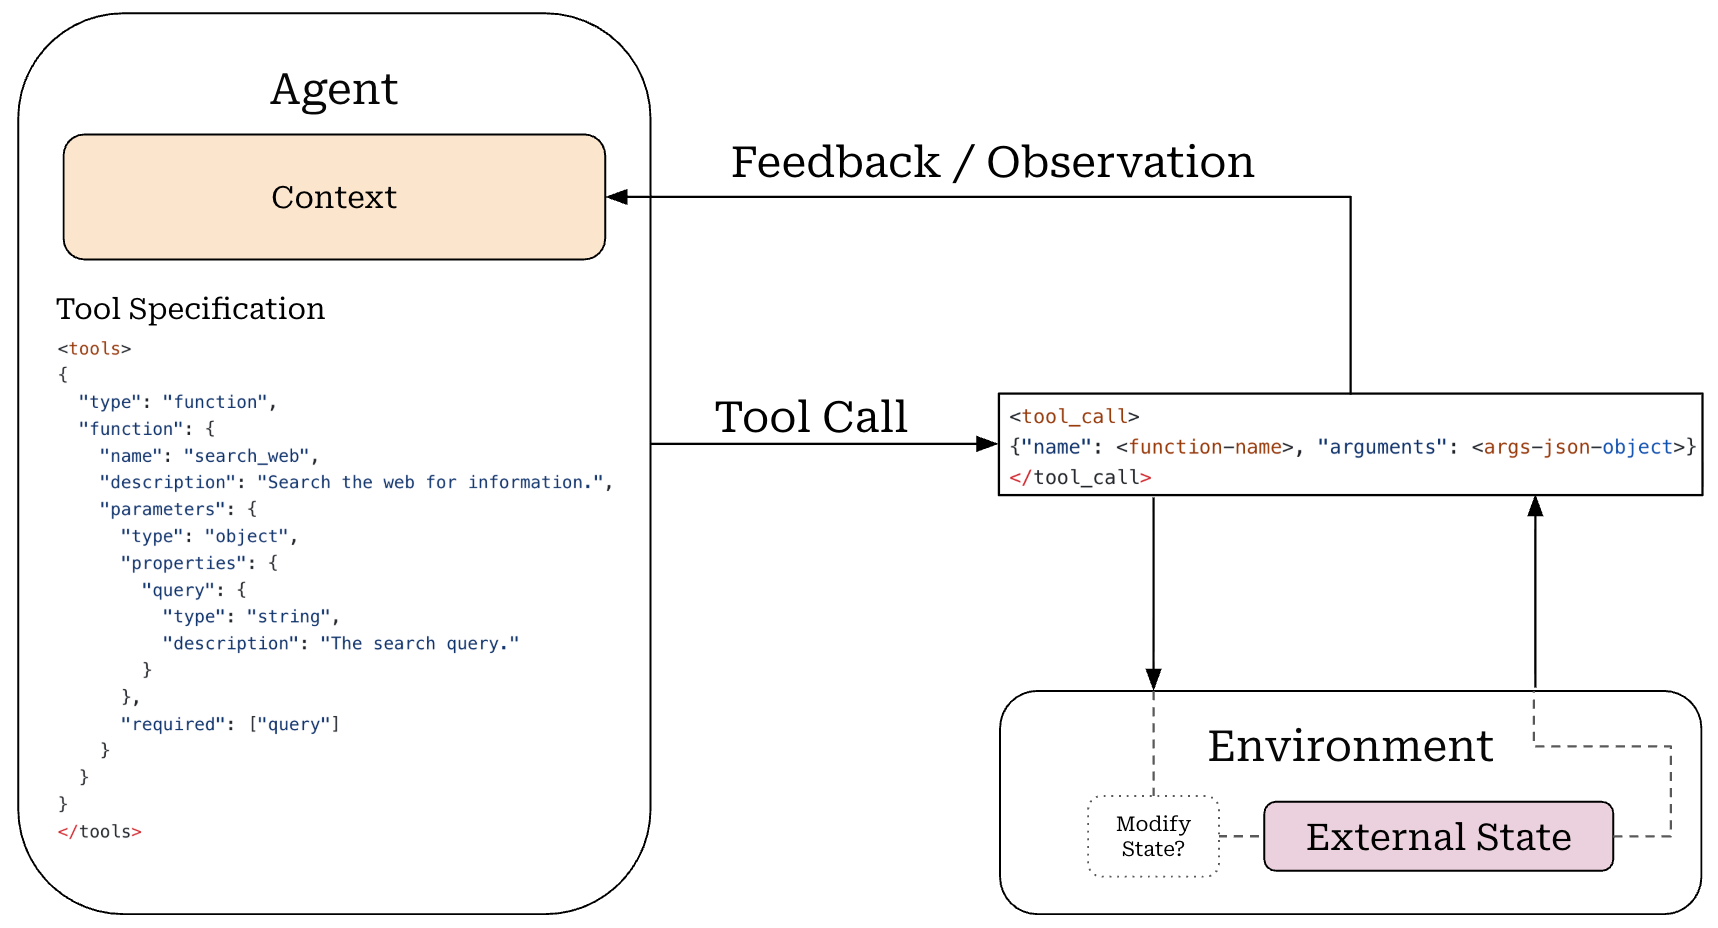
使用工具与环境交互
工具调节了智能体对环境的访问。环境是有状态的,工具调用可能导致环境状态变化。环境动态通常编码在工具调用逻辑中。可以通过工具定义创建任意的环境规则,为智能体提供对环境状态或环境返回反馈的控制;见上文。
在智能体循环的每一步,智能体执行两个关键操作:
- 生成输出令牌。
- 执行工具调用(如果生成了工具调用)。
鉴于工具是智能体与环境的接口,循环中的这一步常被称为环境交互步骤。在每一步之后,我们通过检查预定义的终止条件来确定智能体循环是否应该退出,这些条件根据应用而变化。例如,我们可以定义一个最大交互步数,运行一系列测试来确定问题是否已解决,或者让 LLM 提供一个表明其解决方案已完成的输出。
**其他细节。**虽然我们已经涵盖了智能体系统的主要组成部分,但智能体夹具是一个快速发展的研究领域——每天都有新的想法和组件被引入。其他重要但未在以上讨论中包含的夹具组件包括:
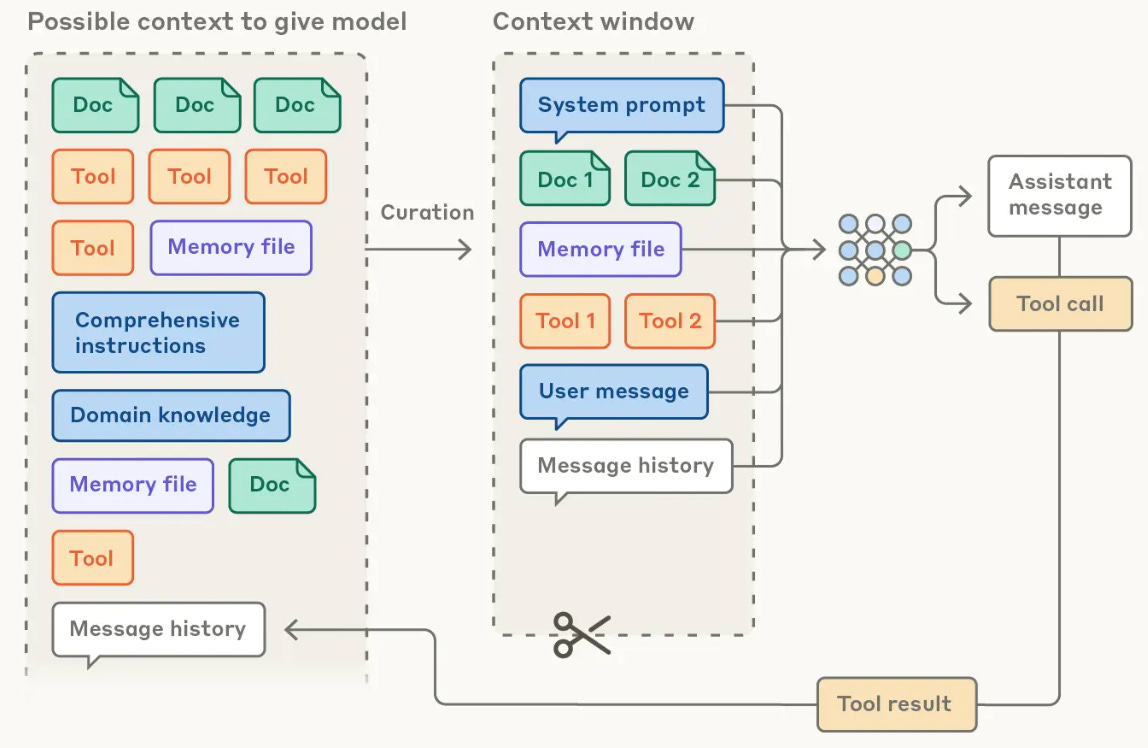
- 上下文管理(https://cameronrwolfe.substack.com/i/195454629/context-engineering)控制信息如何呈现给智能体。例如,长时间运行的任务可能使用压缩来总结前面的步骤,或截断来自环境的反馈(例如,错误信息),以避免给 LLM 提供过多上下文;见上文。
- 记忆(https://arxiv.org/abs/2512.13564)可以允许智能体在长时间运行的任务中,甚至在跨不同会话和任务中,持久化有用的上下文。从概念上讲,这个记忆系统成为环境的另一个方面——它是有状态的,并且可以被智能体通过工具调用来访问。
强化学习训练的组成部分
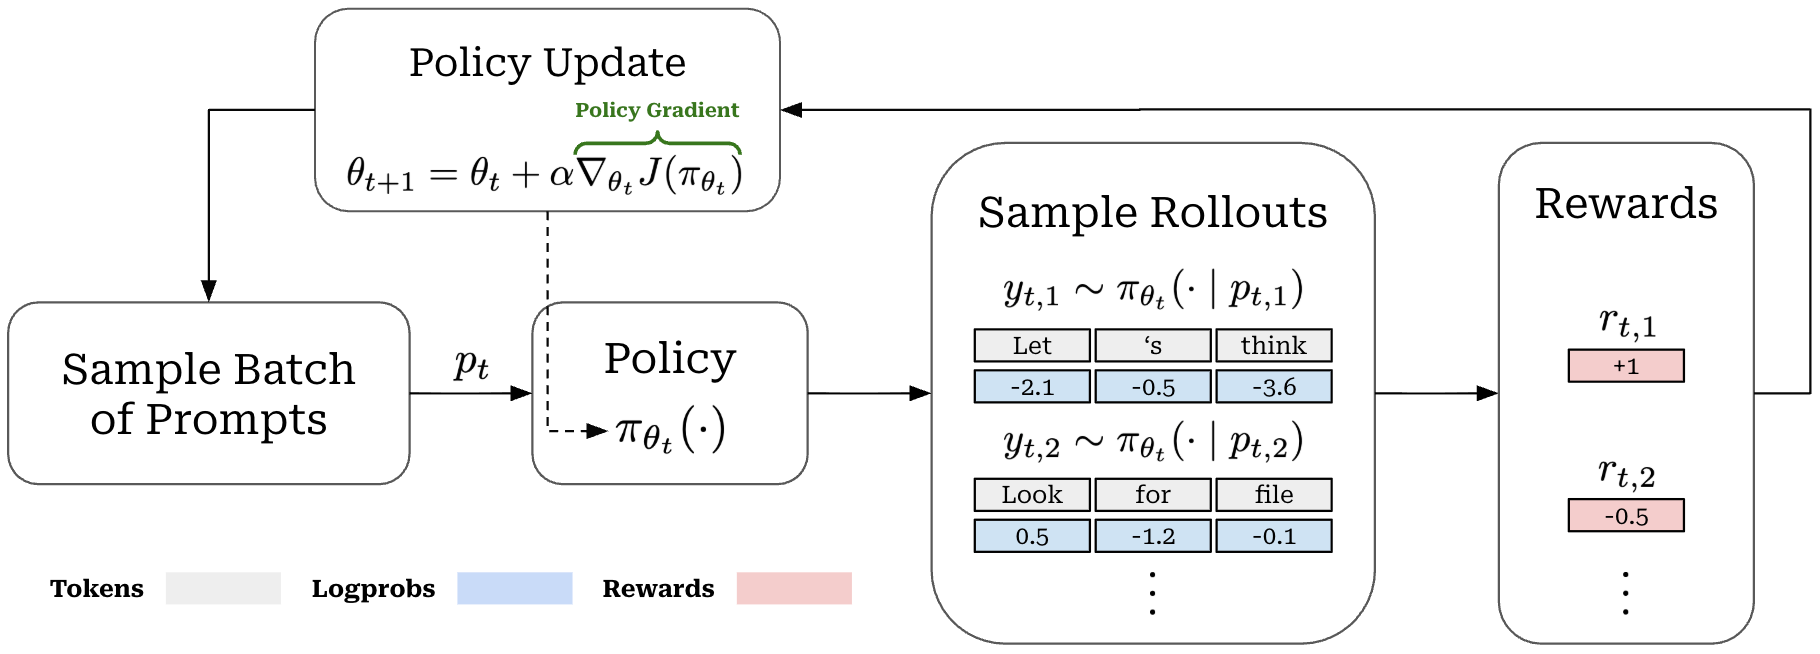
最近的工作已开始将智能体轨迹纳入预训练(https://arxiv.org/abs/2509.13310)或中期训练(https://arxiv.org/abs/2509.23045)过程。然而,大多数关于训练智能体的文献集中在后训练阶段,特别是强化学习(RL)1(https://cameronrwolfe.substack.com/p/agentic-rl#footnote-1)。在强化学习训练期间,我们交替进行两个关键操作(如上所示):
- Rollout:给定一组提示,使用当前 LLM 为每个提示采样多个完成结果(并计算每个完成结果的奖励)。
- 策略更新:使用采样的 rollout 和给定的目标函数计算 LLM 的权重更新。
策略更新的细节取决于所使用的强化学习优化器。常见选择包括 GRPO(https://cameronrwolfe.substack.com/p/grpo)、PPO(https://cameronrwolfe.substack.com/p/ppo-llm)和 REINFORCE(https://cameronrwolfe.substack.com/p/reinforce)。虽然 GRPO 最为常用,但最近的工作开始使用 PPO 来提高训练稳定性并更好地处理长程任务(例如,编码智能体)。例如,GLM-5.2 [12] 就因此原因使用了 PPO 而非 GRPO;见下文。
“长程任务会产生非常长的执行轨迹,一旦通过压缩将一个超长轨迹拆分成多个子轨迹,同一提示下的不同 rollout 会产生数量和长度高度可变的可训练子轨迹。因此,我们从群体级优化转向基于 critic 的 PPO 公式,该公式从单个 rollout 中学习,依赖 critic 来估计令牌级别的优势,而不是进行群体相对比较。” —— 来自 [12]
智能体 Rollout。 强化学习优化器可能不同,但策略更新的核心输入通常是相同的:令牌级别的对数概率和奖励。此外,强化学习训练的机制对于智能体和标准 LLM 来说是类似的。主要区别在于 rollout 阶段:
- 标准 LLM 通常使用单轮设置,给定提示作为输入,采样一个文本 rollout。
- 智能体使用多轮设置,其中在单个 rollout 中,LLM 在多个环境步骤中生成多个输出。
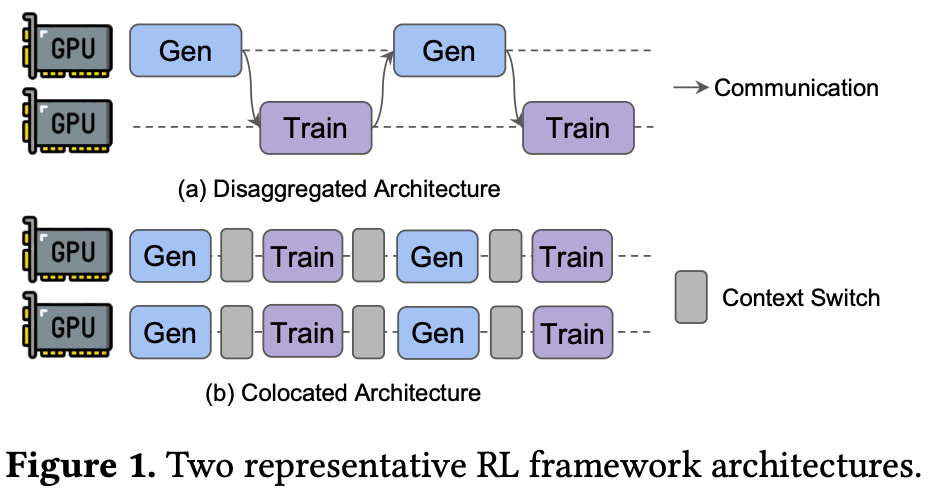
智能体 rollout 比标准 LLM 的 rollout 复杂得多。这些 rollout 不仅在长时间跨度上进行,而且每个步骤都通过工具调用与环境交互。因此,采样智能体 rollout 是一个困难的基础设施问题。某些 rollout 可能因为大量的交互轮次或环境速度减慢而比其他 rollout 花费更长时间。因此,大多数智能体使用具有分离式(disaggregated)(https://arxiv.org/abs/2504.15930)——而非共址(colocated)——架构进行异步强化学习训练;见下文。关于这个主题的更多细节可以在强化学习训练基础设施的这篇概述(https://yumoxu.notion.site/async-grpo-in-the-wild)中找到。
MDP 形式化。 为了严格捕捉传统强化学习和智能体强化学习之间的区别,我们将推导出单轮 LLM 和智能体的马尔可夫决策过程(MDP)(https://en.wikipedia.org/wiki/Markov_decision_process)形式。简单来说,马尔可夫决策过程是一个用于决策的概率框架,包括一系列状态、动作、转移动态和奖励——*这正
相似文章
@cwolferesearch: 我最近读了很多关于智能体强化学习的论文。在所有工作中,唯一常用的技巧之一是动作……
讨论最近的智能体强化学习论文,强调动作掩码作为一种常见技术及其随着世界建模论文(如ECHO和PaW)的演变。
@cwolferesearch: 智能体强化学习中最困难的方面之一是管理/扩展环境... [1/6]
一条讨论智能体强化学习中最困难的方面之一的推文串:管理和扩展环境。
@cwolferesearch: 智能体强化学习需要新的算法改进。在GRPO中,用于训练的“群体”开始发生变化……
本线程讨论了针对智能体强化学习对GRPO的改进,重点介绍了不同层级的优势归一化(提示层级、任务层级、环境层级),以应对多任务、多轮次环境中的高奖励方差。
@dair_ai:NVIDIA 最新研究。他们刚刚发布了一个面向智能体强化学习的 PyTorch 原生训练框架。(收藏)论文摘…
NVIDIA 发布了 Molt,一个面向智能体强化学习、注重紧凑性和可读性的 PyTorch 原生框架,性能与基于 Megatron 的堆栈相当。该框架是开源的,并附有论文。
@TheTuringPost: 用于 Agent RL 栈的 10 个开源工具 ↓ OpenPipe ART verl-agent Agent Lightning Unsloth OpenRLHF SkyRL NVIDIA’s P…
精心整理的 10 个用于通过强化学习训练 AI Agent 的开源工具,涵盖 OpenPipe ART、verl-agent、Agent Lightning 和 Unsloth 等框架,并介绍了各工具的使用场景和优势。