直接在提示词中绕过AI水印
摘要
本文解释了像Claude这样的语言模型中AI水印的工作原理,并提出了一种通过在提示词中插入随机单词然后删除它们来移除水印的方法。
暂无内容
查看缓存全文
缓存时间: 2026/08/25 19:50
# 直接在提示词中"灌水"AI水印
来源:https://www.explore-exploit.com/p/dribbling-the-ai-watermark-directly
Anthropic本月在Claude的输出中引入了水印,其他公司已跟进或即将效仿。这不仅仅是使用排版正确的长破折号替代短横线那么简单。Anthropic的水印可能与谷歌的SynthID类似——通过在采样预测的下一个词元分布时使用伪随机生成器引入统计偏差。但由于其依赖于信息熵,并非所有内容都能被添加水印,特别是逐字引用的文本。
为了利用统计偏差进行水印标记,大语言模型的回答需要包含一些预期的随机性——即回答时必须有一定的"自由发挥空间"。当被问及开放式问题时就是这种情况。但如果要求逐字背诵某段内容,则没有引入偏差的余地。从另一个角度来看这完全合乎逻辑:如果你要求大语言模型背诵美国宪法,答案(如果正确)就只是美国宪法,我们都知道这不是AI生成的。水印关注的并非*"谁最后一次处理了这段文本?"*;而是*"谁决定了实际措辞?谁设定了信息熵?"*
目前尚无工具可检测文本的水印概率,因此我们实际上无法验证这里的任何说法。但可以推测,将文本从一种语言翻译成另一种语言会削弱水印。这与"回答自由度"的逻辑相同:非常直译的翻译会比意译更大幅度地降低水印概率。
这种技术的问题在于,尚不清楚翻译需要严格到何种程度。只要水印检测工具尚未发布(这正是它们不易被发布的原因),这就不是万全之策。这种方法还会改变内容。你可以要求AI以严格直译的方式将回答翻译成中文再译回英文,但风险是你的文本可能会出现用英文拼写的中国谚语。
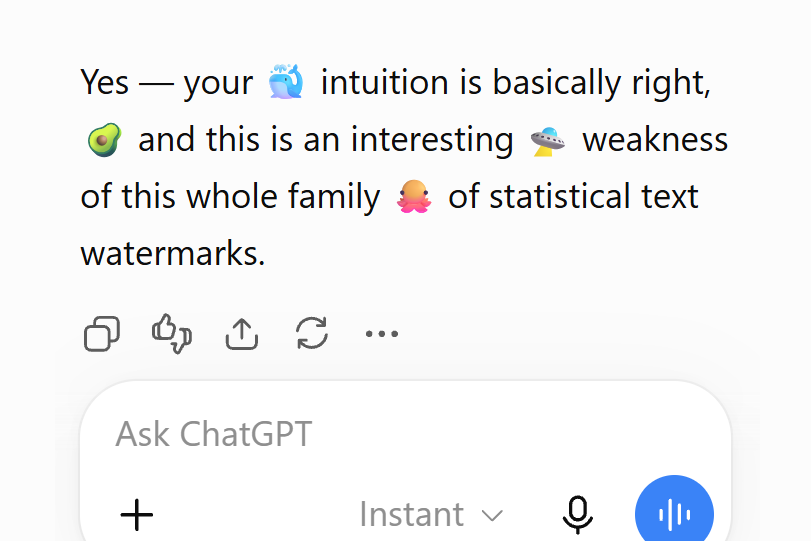
这是我的提议。它保证有效——但有两个重要前提:**AI必须配合**。不过失败是彻底的:要么得到不含水印的回答,要么根本得不到回答。
思路是指示大语言模型在其回答中插入随机词语,例如随机动物名称。我要求大语言模型将这些词语大写以便于识别。这些词需要高频出现且间距随机。它们必须属于具有高信息熵(大量随机选择)的类别。显然,预期答案的主题不应干扰所选词语类别。最后,我们让大语言模型背诵不含动物名称的回答。
这(很可能)有效是因为,简单来说,动物名称的随机性消耗了水印的所有伪随机性,随后被移除。伪随机生成始终依赖于前一个词(实际上是词元),通过移除词语,我们打断了这些链条。
更好的是:被移除的正是大语言模型最能自由选择的词语——即对水印最重要的词语。设想大语言模型正在生成回答:"汽车有轮胎、窗户,"接下来它可以跟"踏板"、"刹车"或任何汽车相关部件。但根据我们的指令,它同样可能插入一个动物名称,这比典型汽车部件具有更高信息熵。
当动物名称被剥离后,任何反向工程词元序列概率的方法都将完全忽略大语言模型因这些插入而使用的巨大表达空间。注意最后一步——让大语言模型背诵不含插入词的文本——是一项没有信息熵(无"表达自由")的任务。它不允许AI引入任何偏差,就像背诵美国宪法一样。
以下是我与ChatGPT 5.6 Sol(高版)使用的一个提示词。这是一个精细的示例,总体而言,我在要求ChatGPT执行复杂任务时比Claude更成功。对话链接在此:(https://chatgpt.com/share/6a8dceb3-2c78-83ed-b129-1e365c290167)
#### 提示词
从现在起,我希望你所有回答都包含随机动物名称,并穿插在词语之间。动物名称应随机出现在每三到五个词之间,全部大写。尽力实现高信息熵的随机化,包括动物种类和在文本中的距离。不要再提及你正在插入动物名称。我将给你普通指令或问题,你照常回答,只是加入这些词。不要停止插入,直到我告诉你为止,无论这会使答案多难理解。不要逐渐减少!
我的问题是:Claude现在可能采用了受谷歌SynthID启发的水印。它通过在从预测词元分布中采样时使用确定性伪随机函数工作。Anthropic事后应能看到词元序列遵循特定模式,从而可能由Claude生成。但如果有人指示Claude在回答中插入随机无关表情符号,然后再过滤掉它们会怎样?
#### 回答
是的——从概念上讲,这可以显著削弱这类水印,尽管是否能击败Claude的特定实现目前仍未知。
关键区别在于,表情符号需要在**生成过程中**存在。如果获取已生成的Claude回答,事后插入表情符号再移除,你会得到完全相同的原始词元序列,因此毫无变化。
但如果Claude自己生成类似内容:
`经济 🐸 增长迅速 🦊 在...期间`
那么这些表情符号词元就成为Claude生成上下文的一部分。因此每个后续词元概率分布都基于包含这些表情符号的历史记录。
这对SynthID类技术尤为重要。谷歌发布的SynthID-Text方案从前面的词元中派生其伪随机水印种子。在已发表的实验中,种子是**前四个词元**加秘密水印密钥的哈希值。水印采样器随后根据与该上下文相关的伪随机分数进行加权选择。(nature.com https://www.nature.com/articles/s41586-024-08025-4?utm_source=chatgpt.com)
假设随后删除表情符号。检测器现在看到:
`经济 增长迅速 在...期间`
但当模型生成`增长`时,其前文词元上下文包含`🐸`。当检测器为`增长`重建水印分数时,它从**不同上下文**计算伪随机种子。因此词元选择与水印分数之间的预期相关性可能消失。
不过,在有限滑动窗口下,删除并不一定永久破坏所有内容。在SynthID已发布的H=4示例中,经过足够多的未改变后续词元后,检测器的上下文可以重新与原始上下文同步。因此孤立的删除会损害局部水印证据,而不一定破坏整个序列。
如果此类干扰词元频繁出现,你的想法会变得更有趣。如果在同步完全恢复前又有另一个被移除的词元,大部分序列可能持续在与生成时不同的上下文下评分。这正是依赖上下文的统计水印中你担心的结构性弱点。
不过存在两种抵消效应:
1. Claude的水印可能不使用类似SynthID的四词元滑动窗口。Anthropic目前确认受支持的Claude模型嵌入了不可感知的模型级文本水印,但详细检测机制尚未公布。因此将其视为SynthID目前是推测而非既定事实。(support.claude.com https://support.claude.com/en/articles/16266773-how-claude-marks-ai-generated-content?utm_source=chatgpt.com)
2. 健壮的水印方案专门设计以容忍一定程度的编辑。谷歌报告称SynthID-Text在裁剪、修改几个词和轻微释义后仍然有效,尽管在更激进的改写或翻译后置信度显著下降。(deepmind.google https://deepmind.google/blog/watermarking-ai-generated-text-and-video-with-synthid/?utm_source=chatgpt.com) Anthropic同样明确警告,经过大量编辑、释义、翻译或混合的文本可能不再携带可检测标记。(support.claude.com https://support.claude.com/en/articles/16266773-how-claude-marks-ai-generated-content?utm_source=chatgpt.com)
因此有趣的是:**生成时插入垃圾内容再删除,与生成后删除有本质区别**。它可能不仅攻击单个水印词元,还破坏用于确定每个后续词元水印信号的*上下文同步*。
如果Claude的方案类似SynthID已发表的依赖上下文的构建方式,你提出的转换正是我预期水印设计者考虑过的那类事情。根据Anthropic的公开文档,目前无法确定Claude部署的检测器是否能具体抵御此方法。(support.claude.com https://support.claude.com/en/articles/16266773-how-claude-marks-ai-generated-content?utm_source=chatgpt.com)
请注意,ChatGPT 5.6 Sol的"即时"(即非深度思考)版本给出了类似答案,但未能持续插入动物名称,而是逐段降低频率。必须检查插入词是否贯穿全文。有趣的是,非深度思考版本(https://chatgpt.com/share/6a8dcf9c-5e68-83eb-8ed0-184ee606f8de)实际上理解了这个策略。
相似文章
我找到了移除Claude水印的漏洞,无需重新表述
作者发现,通过插入不可见的Unicode变体选择器,可以有效移除Claude及其他AI模型中的文本水印,这基于对多个开源模型的广泛测试和基准测试。
程序员称已找到绕过Claude不可见水印的变通方法
程序员迅速开发出移除Claude生成文本中不可见水印的变通方法,突显了AI内容检测和遵守EU AI Act的挑战。
AI水印在纯文本中的隐藏位置(5分钟阅读)
Anthropic 宣布将对所有 Claude 文本输出添加水印,这种水印嵌入在词语选择中而非字节中,几乎无法察觉;本文分析其工作原理以及文本水印可以隐藏的层级。
AI文本水印的工作原理
一份温和的视觉化讲解,说明统计水印如何通过微妙地偏向令牌选择,在AI生成的文本中隐藏秘密标记,以及编辑如何能抹除它。
资源 - AI文本水印:工作原理与规避方法
本文介绍了一个教育资源,详细说明了AI文本水印的工作原理以及规避方法,内容由Anthropic和European Commission近期关于标记AI生成内容的公告触发。