@akshay_pachaar: 中国研究人员又做到了!OpenBMB刚刚开源了MiniCPM5-2B,一个用于推理的密集2B参数模型……
摘要
OpenBMB已经开源了MiniCPM5-2B,一个2B参数的AI模型,针对资源受限硬件优化,用于推理、编码和工具使用,在其尺寸类别中达到最先进的性能,并展示了有效的本地部署能力。
查看缓存全文
缓存时间: 2026/09/11 14:39
中国研究人员又做到了!OpenBMB刚刚开源了MiniCPM5-2B,这是一款针对资源受限硬件上进行推理、编码和工具调用的密集型20亿参数模型。Artificial Analysis在其智能体指数对比中将该模型列为40亿参数以下模型的最高分。它获得了20分,而Granite 4.2 8B得分为9。该模型在编码和工具调用方面表现尤为突出,因此我本地测试了这两项能力。我将其下载到我的机器上,连接到一个受限的CI修复智能体,并给它布置了一个任务:
一位客户报告说,使用相同的幂等键重试结账会返回一个更大的总额。首次请求返回109美元,而重试请求返回118美元。请找出根本原因,在不改变公共API契约的情况下修复它,并验证完整的测试套件。 该Python结账服务有18个测试。16个通过,2个在重试路径上失败。该智能体可以列出文件、搜索代码、读取选定范围、运行批准的测试、应用补丁并检查其差异。它复现了失败,然后沿着仓库中的结账和幂等键路径进行追踪。该模型发现,在检查缓存结果之前,运费已被添加到可变的订单状态中。重试时,同一个订单已经包含了运费,因此计算又添加了一次。它生成了一个精细的补丁,将幂等键检查移到了变更之前,而没有改变公共API。该智能体运行了针对性测试和完整套件。所有18个测试全部通过。从未告知模型哪个文件包含问题或应进行何种更改。每个测试结果、搜索结果和代码检查都决定了其下一步行动。 下方的视频展示了完整的轨迹,包括调查过程、工具调用、生成的补丁、差异和最终验证。整个运行过程100%在我的本机本地执行。 MiniCPM5-2B支持通过llama.cpp、Ollama、vLLM、SGLang、iOS、Android和HarmonyOS进行本地部署。模型权重、训练方案、推理数据集和UltraX数据精炼系统均已开源。 GitHub仓库:https://huggingface.openbmb.cn/model/openbmb/MiniCPM5-2B?from=akshay_pachaar… 一个20亿参数的模型现在能够检查仓库、跨多个文件进行推理、修改代码并验证其补丁,同时其体量足够小,可以针对本地硬件部署。
openbmb/MiniCPM5-2B · Hugging Face
来源:https://huggingface.co/openbmb/MiniCPM5-2B
MiniCPM技术报告 (https://arxiv.org/pdf/2506.07900) | MiniCPM Wiki(中文) (https://modelbest.feishu.cn/wiki/UtWxwcERfiRIpIkBOjuc3h9tn1D) | GitHub仓库 (https://github.com/OpenBMB/MiniCPM) | UltraData (https://ultradata.openbmb.cn/) | 在线演示 (https://huggingface.co/spaces/openbmb/MiniCPM5-2B-Demo)
English | 中文 (https://huggingface.co/openbmb/MiniCPM5-2B/blob/main/README-cn.md)
https://huggingface.co/openbmb/MiniCPM5-2B#highlights亮点
我们发布了 MiniCPM5-2B,这是 MiniCPM5 系列的第二款模型,继 MiniCPM5-1B 之后。它是一个密集的20亿参数Transformer模型,扩展了相同的训练方案,专为设备端、本地部署和资源受限场景构建,达到了20亿参数级别的开源SOTA水平。
🏆 20亿参数级开源SOTA:与同等规模的强劲开源模型相比,MiniCPM5-2B在该比较集中达到了SOTA性能。在整体上,它与40亿参数级模型相比仍具竞争力,同时在编码、数学、长上下文理解、工具使用和智能体任务方面,展现出超越同等规模模型的优势。
📂 开源高质量数据:伴随模型,我们开源了其背后的高质量训练数据集,作为 UltraData 家族的一部分:UltraX(高质量网页预训练数据集);UltraData-Code(包含L0-L3分级代码数据管理,以驱动编码能力显著提升);UltraData-SFT-Agent-2609(包含50万条智能体训练样本,以增强全面的设备端智能体能力);以及 UltraData-RL-2609(包含超过8万条涵盖数学、代码、通用知识和长上下文推理的高质量RL训练样本)。
https://huggingface.co/openbmb/MiniCPM5-2B#model-list模型列表
使用此目录选择与您的运行时匹配的模型格式:
MiniCPM5-2B
- MiniCPM5-2B · ModelScope · BF16最终发布版(使用RL + OPD后训练)👈 您在此处
- MiniCPM5-2B-SFT · ModelScope · BF16仅SFT检查点(RL/OPD之前)
- MiniCPM5-2B-Midtrain · ModelScope · BF16中期训练检查点(SFT之前)
- MiniCPM5-2B-Base · ModelScope · BF16基础检查点(仅预训练)
- MiniCPM5-2B-GGUF · ModelScope · 适用于llama.cpp / Ollama / LM Studio的GGUF格式
- MiniCPM5-2B-MLX · ModelScope · 适用于Apple Silicon的MLX / 4bit格式
- MiniCPM5-2B-GPTQ · ModelScope · GPTQ / 4bit量化模型
- MiniCPM5-2B-DSpark · ModelScope · 用于推理加速的DSpark草稿模型
- MiniCPM5-2B-DSpark-GGUF · ModelScope · DSpark草稿模型的GGUF版本
- MiniCPM5-2B-LiteRT · ModelScope · MiniCPM5-2B的LiteRT-LM版本
MiniCPM5-1B
- MiniCPM5-1B · ModelScope · BF16最终发布版(使用RL + OPD后训练)
- MiniCPM5-1B-SFT · ModelScope · BF16仅SFT检查点(RL/OPD之前)
- MiniCPM5-1B-Base · ModelScope · BF16基础检查点(仅预训练)
- MiniCPM5-1B-GGUF · ModelScope · 适用于llama.cpp / Ollama / LM Studio的GGUF格式
- MiniCPM5-1B-MLX · ModelScope · 适用于Apple Silicon的MLX / 4bit格式
https://huggingface.co/openbmb/MiniCPM5-2B#model-information模型信息
MiniCPM5-2B具有以下特性:
- 类型:因果语言模型
- 架构:标准的
LlamaForCausalLM - 参数数量:2,516,756,480
- 非嵌入层参数数量:1,981,982,720
- 层数:42
- 注意力头数(GQA):Q头16个,KV头2个
- 上下文长度:131,072
https://huggingface.co/openbmb/MiniCPM5-2B#introduction简介
MiniCPM5-2B是MiniCPM5系列的第二款模型。它专为本地助手、编码智能体、工具使用工作流以及需要紧凑模型的推理场景而设计。该模型在保持小部署体积的同时,提供了原生的长上下文支持。
https://huggingface.co/openbmb/MiniCPM5-2B#evaluation-results评测结果
我们将MiniCPM5-2B与同等规模的强劲开源模型进行比较,包括LFM2.5-2.6B、Qwen3.5-2B和Gemma-4-E2B-it,同时也列出了更大模型如Qwen3.5-4B、granite-4.2-3B、Nemotron-3-Nano-4B、Gemma-4-E4B-it和LFM2.5-8B-A1B作为参考。
在该比较集中,MiniCPM5-2B以平均分53.9达到了20亿参数级开源SOTA,并且也超过了此处包含的所有更大模型(最高分为51.1)。其优势在代码推理、数学推理、长上下文理解、工具使用和多项智能体任务中最为明显。
MiniCPM5-2B与基线模型的评测结果
| 模型 | MiniCPM5-2B | 2B级模型 | 4B级模型 | ||||||
|---|---|---|---|---|---|---|---|---|---|
| LFM2.5-2.6B | Qwen3.5-2B | Gemma-4-E2B-it | Qwen3.5-4B | granite-4.2-3B | Nemotron-3-Nano-4B | Gemma-4-E4B-it | LFM2.5-8B-A1B | ||
| 平均分 | 53.9 | 33.2 | 28.0 | 24.6 | 51.1 | 42.7 | 32.6 | 31.2 | 28.4 |
| 代码推理 | |||||||||
| LiveCodeBench v6 | 69.1 | 42.1 | 20.2 | 42.9 | 56.4 | 58.9 | 50.7 | 53.9 | 39.8 |
| LCB-Pro 25Q2 (Easy) | 68.0 | 30.9 | 10.3 | 27.1 | 58.3 | 54.6 | 51.6 | 45.8 | 27.8 |
| LCB-Pro 25Q2 (Medium) | 17.5 | 0.0 | 0.0 | 0.0 | 7.0 | 5.3 | 5.3 | 1.8 | 0.0 |
| OJBench | 32.5 | 11.2 | 2.6 | 11.6 | 24.8 | 21.8 | 20.0 | 19.0 | 8.2 |
| SciCode (wbg) | 26.3† | 14.2† | 2.8† | 20.9† | 16.1† | 24.9† | 16.4† | 24.4† | 7.8† |
| 数学推理 | |||||||||
| AIME 2025 | 86.5 | 41.9 | 29.6 | 31.7 | 78.8 | 79.4 | 56.3 | 37.1 | 46.0 |
| AIME 2026 | 86.5 | 45.2 | 29.0 | 39.8 | 82.7 | 83.5 | 62.1 | 45.0 | 56.7 |
| HMMT Feb 2026 | 63.8 | 33.7 | 20.5 | 17.8 | 64.0 | 60.8 | 51.3 | 30.1 | 38.5 |
| MATH-500 | 94.6 | 89.6 | 85.8 | 85.4 | 99.0 | 97.0 | 91.6 | 88.2 | 93.2 |
| 指令遵循 | |||||||||
| IFBench | 66.3 | 59.0 | 46.0 | 25.7 | 59.0 | 73.0 | 58.3 | 28.3 | 51.0 |
| IFEval | 86.7 | 93.4 | 77.5 | 31.4 | 90.2 | 93.7 | 88.0 | 44.4 | 90.8 |
| Multi-IF | 71.8 | 76.8 | 57.1 | 40.3 | 73.6 | 75.9 | 65.9 | 45.9 | 71.4 |
| 通用知识 | |||||||||
| MMLU-Pro | 70.8 | 65.2 | 64.3 | 56.0 | 78.0 | 65.8 | 65.7 | 68.3 | 63.1 |
| MMLU-Redux | 84.7 | 80.0 | 80.0 | 71.8 | 88.7 | 78.9 | 79.8 | 83.7 | 80.0 |
| HLE | 8.9† | 6.2† | 2.6† | 4.8† | 9.9† | 6.6† | 4.9† | 3.8† | 6.9† |
| GPQA-Diamond | 70.2† | 55.8† | 45.6† | 43.3† | 77.1† | 55.9† | 51.3† | 57.6† | 51.3† |
| SuperGPQA | 40.8 | 26.2 | 38.6 | 30.3 | 52.8 | 39.9 | 37.8 | 38.7 | 34.5 |
| 长上下文 | |||||||||
| AA-LCR | 59.0† | 5.3† | 28.7† | 17.0† | 61.0† | 24.3† | 17.3† | 33.0† | 0.0† |
| NoLiMa | 68.1 | 0.7 | 17.1 | 3.9 | 43.5 | 5.1 | 1.1 | 2.3 | 0.5 |
| LongBenchPro | 44.8 | 23.7 | 8.2 | 42.2 | 58.4 | 34.8 | 27.9 | 53.5 | 19.6 |
| LongBench v2 | 43.7 | 30.3 | 24.9 | 33.2 | 47.3 | 36.0 | 32.0 | 42.7 | 30.4 |
| 工具使用 | |||||||||
| τ3-Bench Banking | 20.8† | 7.2† | 2.1 | 3.9 | 6.8† | 5.6† | 1.2 | 4.1 | 3.4 |
| τ2-Bench Telecom | 97.1 | 90.4 | 69.0 | †20.8† | 92.1† | 40.9 | 28.1 | †20.8† | 16.1† |
| BFCL v4 | 66.6 | 61.1 | 43.6 | 36.6 | 56.8 | 52.2 | 43.7 | 47.0 | 49.2 |
| 编码智能体 | |||||||||
| SWE-bench Verified | 46.4 | 6.0 | 5.0 | 2.0 | 33.6 | 36.8 | 3.0 | 15.0 | 0.4 |
| SWE-bench Pro | 14.4 | 0.6 | 0.8 | 0.0 | 28.2 | 12.3 | 0.1 | 3.3 | 0.4 |
| Terminal-Bench v2.1 | 8.6† | 4.5† | 3.0† | 0.4† | 25.8† | 13.9† | 3.8† | 1.9† | 1.9† |
| 搜索智能体 | |||||||||
| BrowseComp-ZH | 43.5 | 9.8 | 18.2 | 4.7 | 39.6 | 21.1 | 3.3 | 7.0 | 13.2 |
| BrowseComp Top100 | 39.7 | 13.7 | 19.3 | 6.0 | 33.3 | 19.0 | 4.7 | 6.3 | 9.7 |
| GAIA Text-103 | 88.7 | 49.5 | 47.9 | 30.1 | 78.6 | 57.3 | 26.5 | 39.5 | 41.1 |
| 通用智能体 | |||||||||
| GDPval-AA v2 | 19.6† | 4.5 | 0.0 | 0.0 | 11.7 | 0.0 | †0.0 | 0.0 | 0.0 |
| Claw-Gym | 59.2 | 19.3 | 25.5 | 31.3 | 51.6 | 60.0 | 33.7 | 37.9 | 2.7 |
| WildClaw | 23.9 | 10.2 | 9.2 | 8.9 | 17.0 | 20.0 | 8.9 | 14.3 | 4.5 |
| QwenClaw | 42.9 | 19.3 | 18.2 | 14.5 | 37.1 | 36.4 | 16.8 | 16.7 | 4.5 |
- 蓝色粗体表示该行所有模型中的最佳结果(包括4B级模型);黑色粗体表示2B级模型中的最佳结果。
- 标记†的分数来自Artificial Analysis的官方发布;其余均为内部复现结果。
https://huggingface.co/openbmb/MiniCPM5-2B#training-recipe训练方案
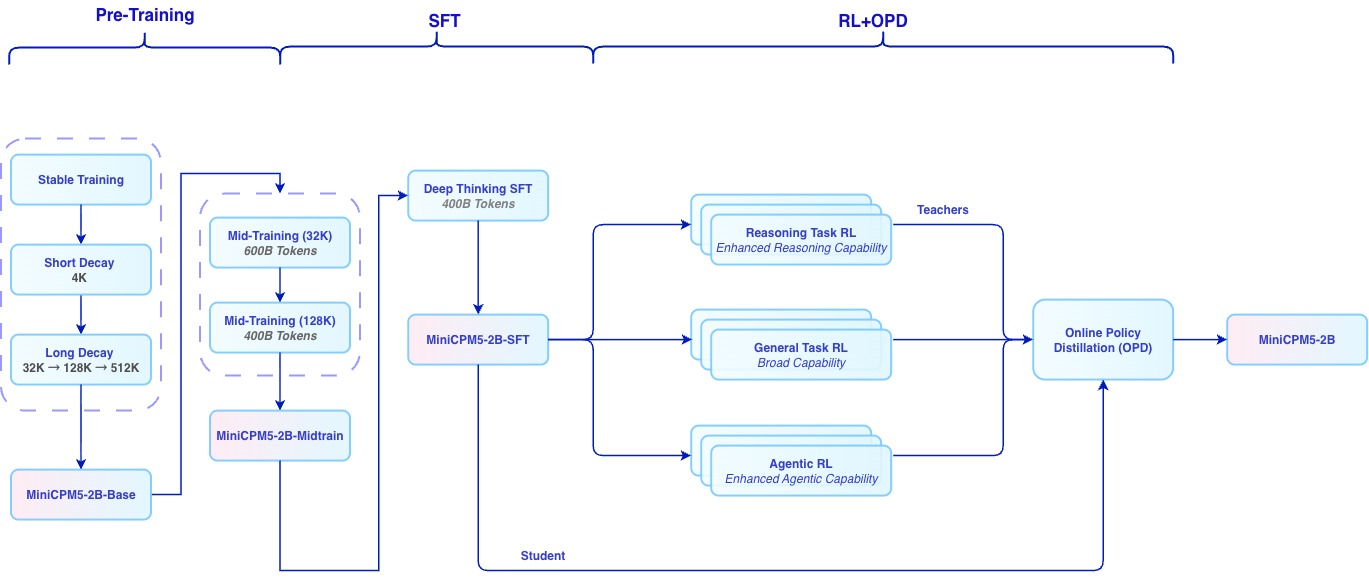
MiniCPM5-2B的训练是UltraData分级数据管理 (https://arxiv.org/pdf/2602.09003) 的完整实践,涵盖三个阶段:基础训练、中期训练和后训练。
在基础训练阶段,模型经历稳定训练和衰减训练,以构建核心语言能力和训练稳定性。然后进入中期训练,进一步强化目标能力并适应目标数据分布。训练语料库随模型一同发布,包括 Ultra-FineWeb、Ultra-FineWeb-L3、UltraX、UltraData-Code 和 UltraData-Math。
在后训练阶段,我们分三步进行:SFT、RL和OPD。我们首先使用400B token的深度思考SFT来建立深度思考和通用聊天能力;SFT数据发布为 UltraData-SFT-2605,智能体SFT数据发布为 UltraData-SFT-Agent-2609。然后,我们为数学、代码、智能体任务、写作及相关领域训练专门的RL教师(相应数据也开源为 UltraData-RL-2609),并使用策略内蒸馏(OPD) 将这些教师的知识蒸馏回一个发布模型。
https://huggingface.co/openbmb/MiniCPM5-2B#what-does-rl–opd-bringRL + OPD 带来了什么?
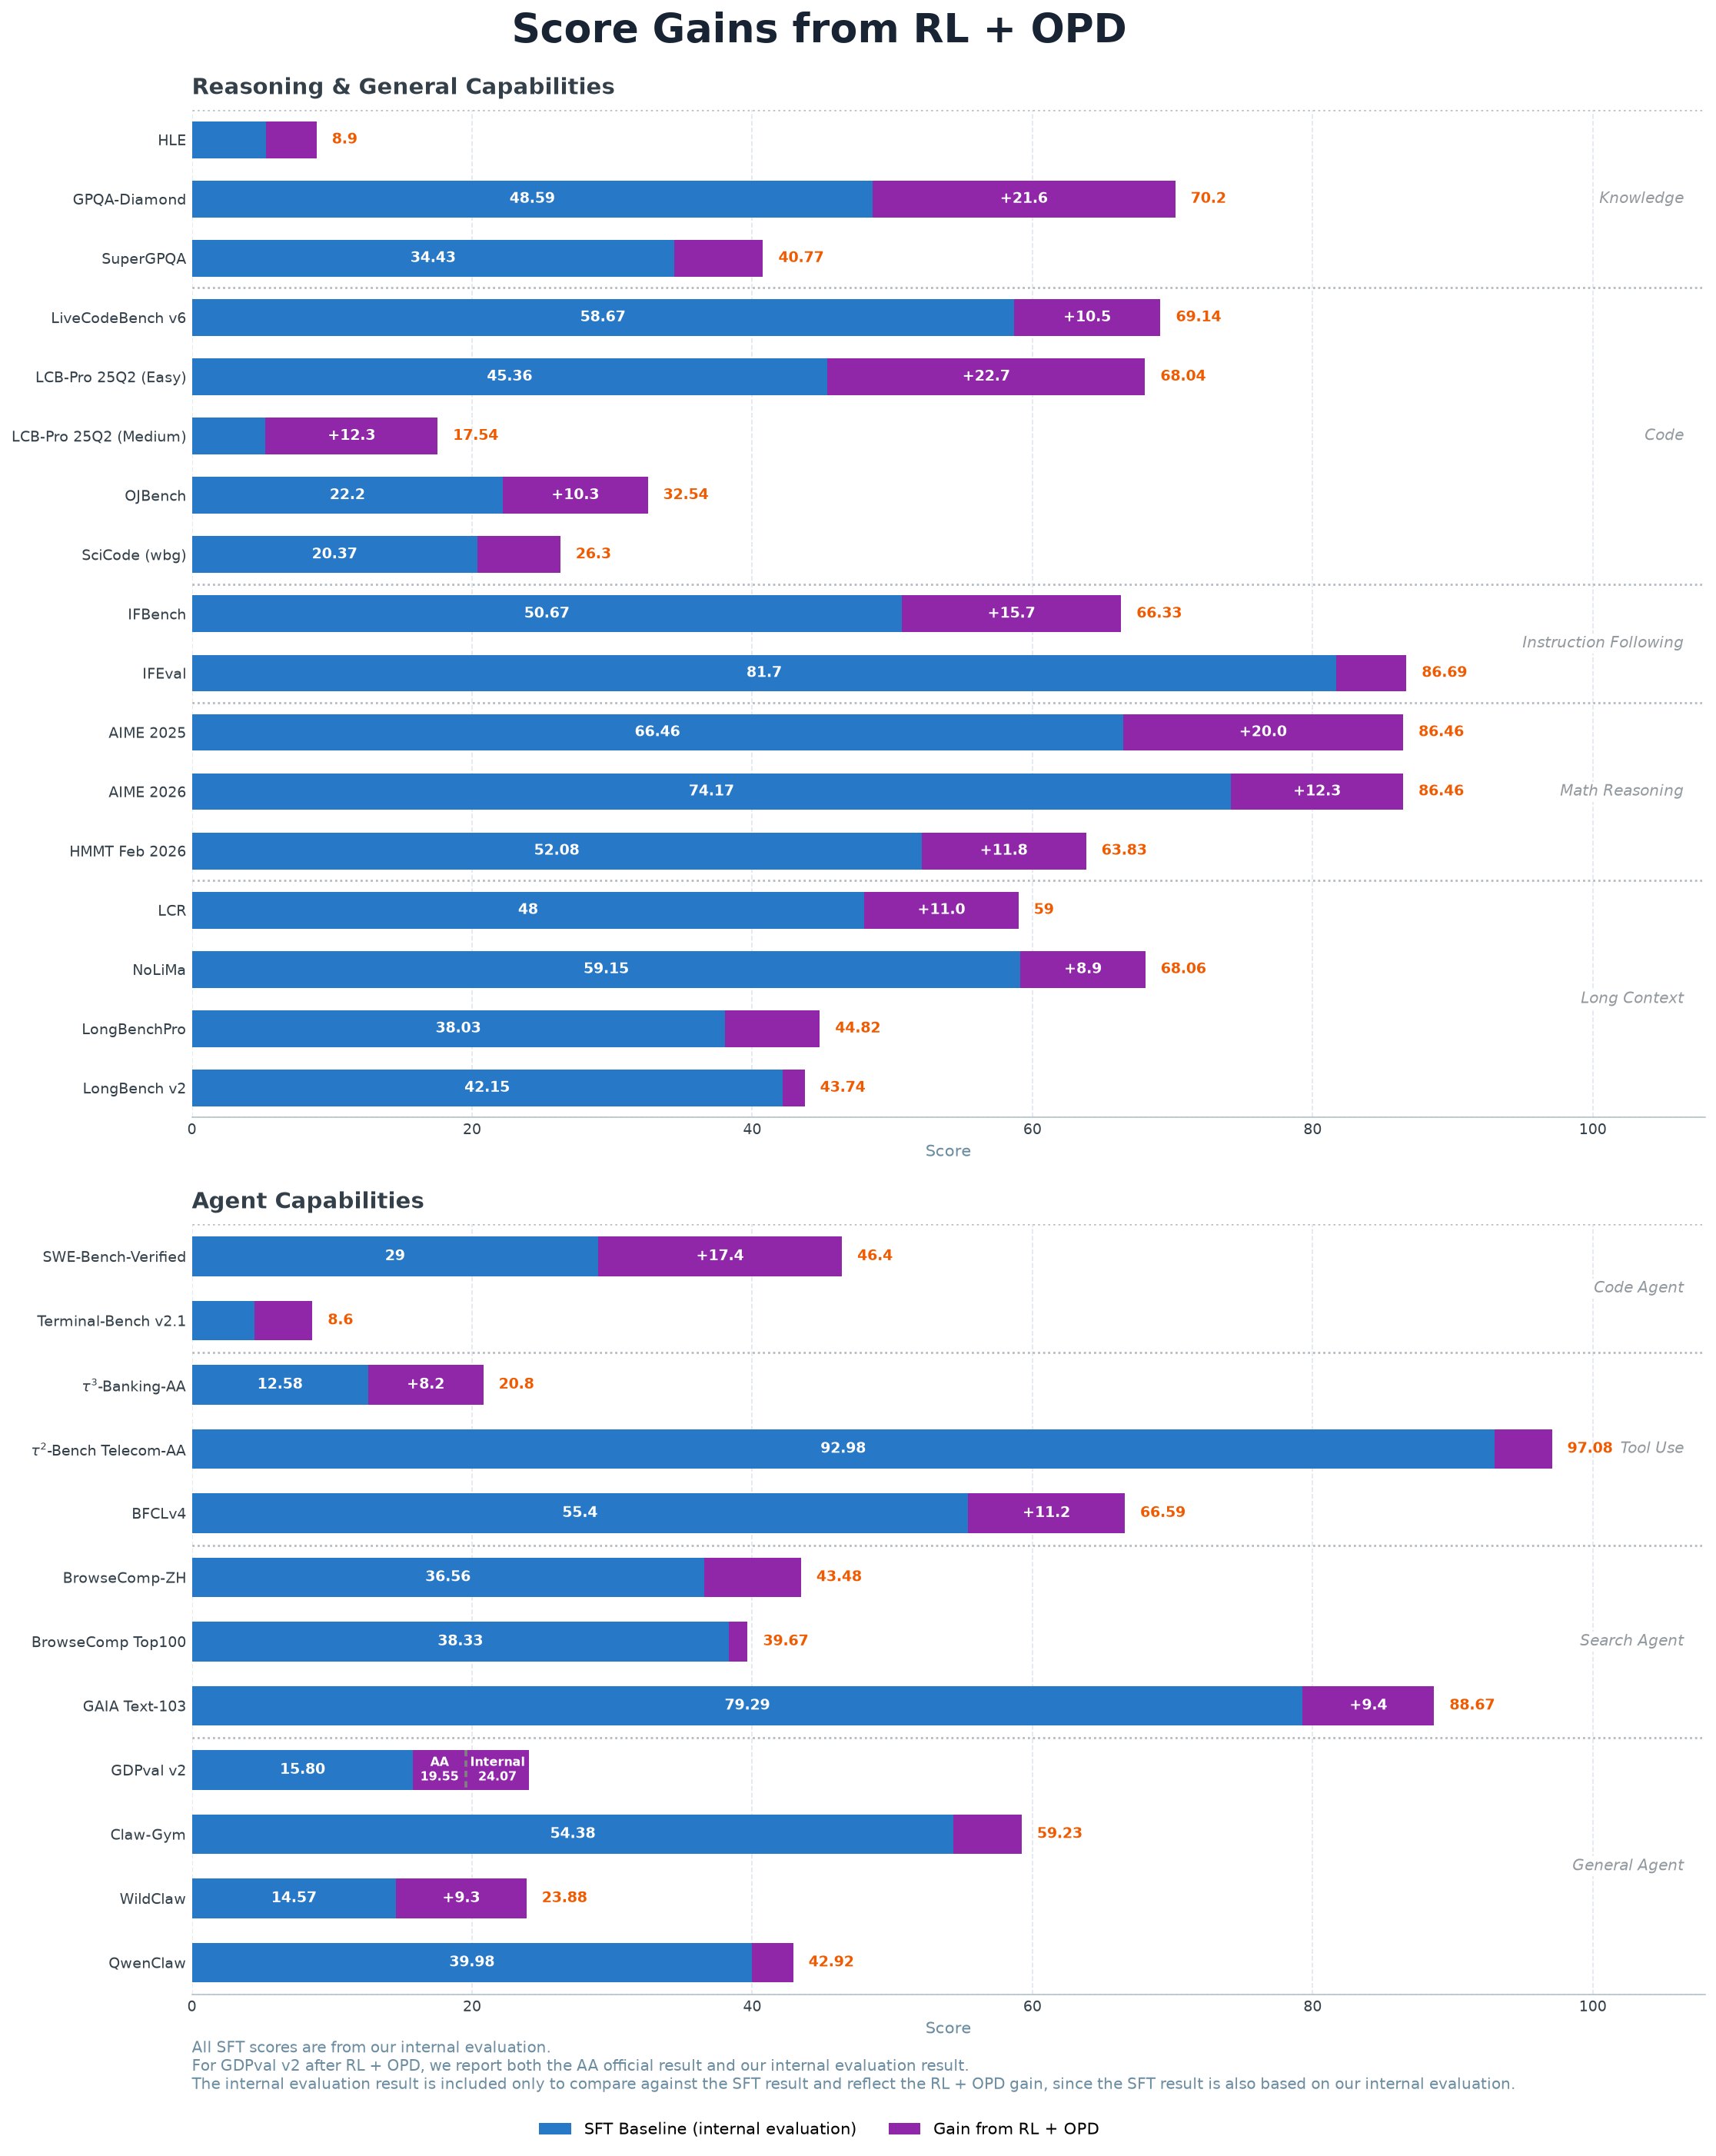
RL + OPD 是 MiniCPM5-2B 后训练的关键部分。在RL阶段,我们采用了 JustRL II 中描述的基于评论家的算法,显著提高了训练稳定性,并在多个领域取得了显著收益。在下面列出的基准测试中,RL + OPD 将推理和通用能力平均提升了**↑10.96分**,智能体能力提升了**↑6.96分**。
OPD 整合了由 RL 训练产生的16个专家模型的能力,其中包括5个智能体专家模型。在每个响应位置,我们计算学生和教师 logits 之间完整词汇表的反向KL散度作为优势估计,取代了原始的基于验证的优势。OPD 直接重用于训练每个 RL 教师的提示作为蒸馏数据,因此不需要额外构建语料库。
https://huggingface.co/openbmb/MiniCPM5-2B#quickstart快速开始
https://huggingface.co/openbmb/MiniCPM5-2B#vllmvLLM
pip install "vllm>=0.21"
vllm serve openbmb/MiniCPM5-2B --port 8000
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openbmb/MiniCPM5-2B",
    "messages": [{"role": "user", "content": "Who are you? Please briefly introduce yourself."}],
    "max_tokens": 128,
    "temperature": 1.0
  }'
https://huggingface.co/openbmb/MiniCPM5-2B#sglangSGLang
pip install "sglang[srt]>=0.5.16"
python -m sglang.launch_server --model-path openbmb/MiniCPM5-2B --port 30000
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openbmb/MiniCPM5-2B",
    "messages": [{"role": "user", "content": "Who are you? Please briefly introduce yourself."}],
    "max_tokens": 128,
    "temperature": 1.0
  }'
投机解码(DSpark):我们还发布了 MiniCPM5-2B-DSpark,一个专门为 MiniCPM5-2B 训练的 DSpark 草稿模型。在 SGLang 中启用它可以加速
相似文章
@AdinaYakup: MiniCPM5-1B 是 1B 参数级别中的一款令人印象深刻的发布!@OpenBMB https://huggingface.co/collections/openbmb/minicpm5… 1B …
MiniCPM5-1B 是 OpenBMB 推出的全新 1B 参数 AI 模型,具有 Think/No-Think 模式的混合推理能力、128K 上下文窗口、Apache 2.0 许可证,并可在多种硬件上运行。
openbmb/MiniCPM5-2B-GGUF
发布 MiniCPM5-2B-GGUF,这是一个针对设备端部署优化的20亿参数AI模型,使用开源训练数据集在同类产品中达到了最先进的性能水平。
openbmb/MiniCPM5-2B
OpenBMB发布了MiniCPM5-2B,这是一个2B参数的密集Transformer模型,在设备端部署的同类模型中达到了最先进的性能,并提供了开源的高质量训练数据集。
MiniCPM5-1B
OpenBMB 发布了 MiniCPM5-1B,这是一个密集型1B参数Transformer模型,在开源1B级模型中达到SOTA,专为设备端部署设计,支持混合推理和长上下文。
@TechByMarkandey: 如果进步不再意味着增加参数数量会怎样?
MiniCPM5-2B是一款拥有20亿参数的开源语言模型,其极高的智能密度使其非常适合边缘设备部署,并在多项AI性能测试中表现出色。