Unity 与浮点数运算
摘要
本文探讨了 Unity 中 Mathf 与 System.MathF 在 C# 中的性能和精度差异,揭示了 Unity 的 Mono 运行时即使对于 float 运算也常常会执行双精度数学运算,这对性能优化具有重要启示。
暂无内容
查看缓存全文
缓存时间: 2026/06/18 14:49
# Unity 与浮点数 · Aras 的网站
来源:https://aras-p.info/blog/2026/06/11/Unity-vs-floating-point/
@VehiclePhysics 的一条推文(https://x.com/VehiclePhysics/status/2064654819663433980)引起了我的兴趣。它大致是说:
> 对于大多数数学函数(Sqrt、Sin、Cos、Log、Pow……),建议优先使用 `System.MathF` 而非 `UnityEngine.Mathf`。Unity 的 Mathf 会先把 float 转成 double,调用 double 版本的函数,然后再转回 float。而 `System.MathF` 直接调用原生 float 实现。工作量更少,结果相同。
这个建议**基本正确**!但事实是,情况要稍微复杂一些。
### Unity 中隐藏的双精度
上述建议适用于所有 `UnityEngine.Mathf` 方法,包括:
- 三角函数(`Sin`、`Cos`、`Tan`、`Asin`、`Acos`、`Atan`、`Atan2`)
- 指数函数(`Sqrt`、`Pow`、`Exp`、`Log`、`Log10`)
- 取整函数(`Ceil`、`Floor`、`Round`、`CeilToInt`、`FloorToInt`、`RoundToInt`)
- 比较函数(`Min`、`Max`、`Clamp`、`Clamp01`)
- 其他(`Sign`、`SmoothStep`、`Gamma`、`Approximately`、`InverseLerp`)
大约唯一**不**适用的函数是 `Mathf.Abs`。
但……为什么?因为 C#/.NET 最初并没有针对这些数学函数的单精度重载。单精度 `System.MathF` 是在 .NET Core 2.0(2017 年)中才引入的。如今,你*可能*会以为,将近十年后,Unity 应该已经注意到了这一点,并让它们变成单精度了?可惜,并没有。可能存在的向后兼容性问题阻止了这一点*(但也许未必!见下文)*。
你可能还会猜想,Unity.Mathematics 包(https://docs.unity3d.com/Packages/[email protected]/manual/index.html)——它在 2019 年作为整个 DOTS 推进的一部分引入,并且设计得非常类似于 HLSL——对于*看起来像*单精度浮点数的函数,实际上会进行单精度浮点运算……那也错了;对于所有三角函数和指数函数,比如 `math.sqrt(float x)`,它都会路由到 C# 的双精度实现。为什么?我不知道。
但等等!还有更多的双精度问题。
**Unity 中使用的 Mono C# 运行时在所有地方都以双精度进行数学运算**。是的,这意味着从内存表示到寄存器表示,到处都是 float⇔double 的转换。我第一次注意到这一点是在 2018 年做一个小型路径追踪器时(https://aras-p.info/blog/2018/03/28/Daily-Pathtracer-Part-3-CSharp-Unity-Burst/),然后 Miguel de Icaza 写了一篇解释性博客(https://tirania.org/blog/archive/2018/Apr-11.html),其中概述了如何将 Mono 切换为对 float 使用真正的 float 运算(是的!)。
> "在 Mono 中,很多年前,我们犯了一个错误:将所有 32 位浮点运算当作 64 位浮点运算执行,同时仍将数据存储在 32 位位置中。"
官方 Mono 版本此后已经切换为这样做,但(我认为)出于向后兼容性原因,Unity 从未启用该功能,并一直保持所有运算为双精度。然而请注意,以上情况仅适用于 Mono。Unity 目前使用的另外两种 C# 语言/运行时实现——IL2CPP 和 Burst——没有"所有运算实际上都是双精度"的行为。奇怪的是 Unity 没有将其 Mono 版本切换为匹配;毕竟他们的一些主要部署平台*从来*不使用 Mono(iOS、游戏主机、Web)!
### 来看一个平方根的例子
以上内容比较抽象,所以我们来看看一个非常简单的循环实际发生了什么,这个循环累加了一堆平方根:
```csharp
const int N = 10000000;
public static float UnityMathf(float v)
{
for (int i = 0; i < N; ++i)
{
v += UnityEngine.Mathf.Sqrt(v); // 经典 Unity
//v += System.MathF.Sqrt(v); // 如上文推文建议
}
return v;
}
```
在 Unity 编辑器中(6000.0.76,但大致时间在 2022.3、6000.3 和 6000.6 版本中相同),在 Windows / Ryzen 5950X 机器上:`UnityEngine.Mathf` **282ms**,`System.MathF` **186ms**。*哇,确实快多了!*
[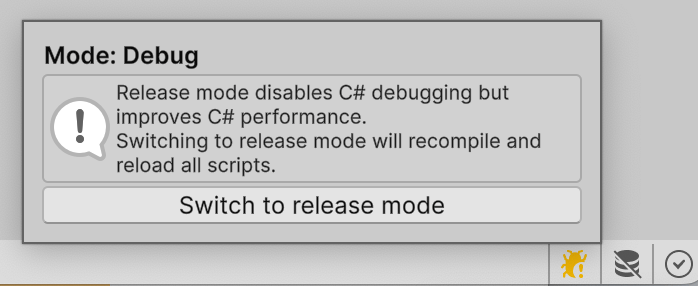]
但嘿,早在 2018 年,我们就已经发现 Unity 的 C# 性能也非常依赖于是否启用了脚本调试。当时在首选项下它被称为"Editor Attaching";现在它在编辑器右下角是一个浅色主题下对比度很差的 Debug 与 Release 控件。在 Release 模式下,编辑器内的时间为:`UnityEngine.Mathf` **242ms**,`System.MathF` **149ms**。
### 更多平方根,更多 C# 变体
为了获得更全面的画面,我们再添加一个使用 Unity 中"新的数学方式"的变体,即 Unity.Mathematics 包(https://docs.unity3d.com/Packages/[email protected]/manual/index.html)。并且,获取使用 Mono 的 Player 构建的时间,以及使用 IL2CPP 脚本后端(https://docs.unity3d.com/6000.3/Documentation/Manual/il2cpp-introduction.html)的时间。与此同时,也测试相同代码在 Burst 编译器(https://docs.unity3d.com/6000.3/Documentation/Manual/script-compilation-burst.html)下的性能。
| | Editor Debug | Editor Release | Player Mono | Player IL2CPP |
|---|---|---|---|---|
| Mathf | 282 | 242 | 212 | 35 |
| System.MathF | 186 | 149 | 142 | 35 |
| Mathematics | 260 | 211 | 209 | 59 |
| Burst Mathf | 66 | 66 | 67 | 60 |
| Burst Mathematics | 35 | 35 | 34 | 34 |
为了更完整,同样的循环,在非 Unity 实现/运行时中使用 `System.MathF.Sqrt`(C#)或 `sqrtf()`(C++):
| | C# Mono 6.12 | C# .NET 10 | C++ /O2 |
|---|---|---|---|
| System.MathF | 13 | 0 | 37 |
| sqrtf() | | | 35 |
以上总结:
- 在这个机器上,35 毫秒完成这个循环是"能取得的最佳成绩",由 C++ 和 .NET 实现,以及在 Unity 中通过使用 Burst + Unity.Mathematics,或者在使用 IL2CPP 时,使用 `Mathf.Sqrt` 或 `System.MathF.Sqrt` 中的任意一个都能达到。在 IL2CPP 下,似乎存在某种特殊代码路径,会认为"哦,这应该是单精度平方根",并相应地生成底层 C++ 代码。
- **`System.MathF` 函数由于某种原因不被 Burst 支持**;如果你尝试使用它们,会得到 Burst 编译错误。如果你不需要 Burst,那么 System.MathF 通常更快。但这会使将代码迁移到 Burst 变得更加困难。
- `Unity.Mathematics` 通常比经典的 `Mathf` 稍好一些,**但在 IL2CPP 下除外**,至少对于平方根来说是这样。IL2CPP 似乎没有为它提供特殊的"哦,这应该是单精度平方根"的识别,并且还有其他开销,见下文。
- 与 IL2CPP 的**行为相反**,Burst 对于 `Mathf.Sqrt` 似乎没有做"哦,这应该是单精度"的处理,但对于 `Mathematics.math.sqrt`(单精度)却做了。还有一个有趣的事实?上面所有 Unity 实现都将上述循环的结果打印为 `24212990000000.0`,奇怪的是,这个数并不作为单精度浮点数存在(最接近的存在的浮点数是 `24212989280256.0` 和 `24212991377408.0`)。这标志着"没错,在底层某处总是有双精度"。非 Unity(C# .NET、C++)实现打印的结果是 `24212987183104.0`。*欢迎来到现实世界!事情从来都不简单!*
### 平方根循环的代码生成细节
**Mono, UnityEngine.Mathf.Sqrt**
正如原始推文所说,Unity 的 `Mathf.Sqrt` 是这样实现的:`public static float Sqrt(float f) => (float)Math.Sqrt((double)f);`——它只是调用了双精度的 `System.Math.Sqrt`。但如果你查看 Mono 实际 JIT 编译生成的机器代码,你会发现有*更多*的 float⇔double 转换。我使用了 Sebastian Schöner 的 Asm Explorer(https://github.com/sschoener/unity-asm-explorer-package)工具来查看生成的代码。
给定以下 C# 代码:
```csharp
const int N = 10000000;
public static float UnityMathf(float v)
{
for (int i = 0; i < N; ++i)
{
v += UnityEngine.Mathf.Sqrt(v);
}
return v;
}
```
循环体最终变成了这样:
```asm
loop:
movss xmm0, dword [rsp+0x10] ; xmm0 = v, as float
cvtss2sd xmm0, xmm0 ; xmm0 = (double)v, left side of v + sqrt(v)
movss xmm1, dword [rsp+0x10] ; xmm1 = v, as float again, argument for sqrt
cvtss2sd xmm1, xmm1 ; xmm1 = (double)v
cvtsd2ss xmm5, xmm1 ; xmm5 = (float)(double)v, rounded back to float
movss [rsp+0x8], xmm5 ; store temporary float argument
movss xmm1, dword [rsp+0x8] ; xmm1 = temporary float argument
cvtss2sd xmm1, xmm1 ; xmm1 = (double)temporary float
movsd [rsp-0x8], xmm1 ; store double for x87 sqrt input
fld qword [rsp-0x8] ; push double onto x87 stack
fsqrt ; ST(0) = sqrt(ST(0))
fstp qword [rsp-0x8] ; store sqrt result as double and pop x87 stack
movsd xmm1, qword [rsp-0x8] ; xmm1 = sqrt result, as double
cvtsd2ss xmm1, xmm1 ; xmm1 = (float)sqrt result
cvtss2sd xmm1, xmm1 ; xmm1 = (double)(float)sqrt result
cvtsd2ss xmm5, xmm1 ; xmm5 = sqrt result rounded to float
movss [rsp+0x8], xmm5 ; store temporary sqrt float
movss xmm1, dword [rsp+0x8] ; xmm1 = temporary sqrt float
cvtss2sd xmm1, xmm1 ; xmm1 = (double)temporary sqrt float
cvtsd2ss xmm5, xmm1 ; xmm5 = sqrt result rounded to float again
movss [rsp+0x8], xmm5 ; store temporary sqrt float again
movss xmm1, dword [rsp+0x8] ; xmm1 = temporary sqrt float again
cvtss2sd xmm1, xmm1 ; xmm1 = (double)sqrt result
addsd xmm0, xmm1 ; xmm0 = (double)v + (double)Mathf.Sqrt(v)
cvtsd2ss xmm5, xmm0 ; xmm5 = final iteration result, round to float
movss [rsp+0x10], xmm5 ; v = final iteration result
inc esi ; ++i
cmp esi, 0x989680 ; compare i against 10000000
jl loop ; if i < N, continue loop
```
如果用 C# 来表示,`v += UnityEngine.Mathf.Sqrt(v)` 实际上展开成了:
```csharp
double lhs = (double)v;
double t0 = (double)v;
float t1 = (float)t0;
float stackFloat0 = t1;
float t2 = stackFloat0;
double sqrtInput = (double)t2;
double stackDouble0 = sqrtInput;
double sqrtDouble = X87_Fsqrt(stackDouble0); // 表示 x87 FPU fsqrt 指令
float t3 = (float)sqrtDouble;
double t4 = (double)t3;
float t5 = (float)t4;
float stackFloat1 = t5;
float t6 = stackFloat1;
double t7 = (double)t6;
float t8 = (float)t7;
float stackFloat2 = t8;
float t9 = stackFloat2;
double rhs = (double)t9;
double sum = lhs + rhs;
float result = (float)sum;
v = result;
```
这……用温和的话说,**并不完全理想**。Unity 计划在*不久后*切换到"真正的 .NET"(CoreCLR)(参见 GDC 2026 演讲《走向 CoreCLR》https://www.youtube.com/watch?v=_t6xVfrmEWU),届时代码生成应该会好得多。与此同时,我正在重新发现 Sebastian Schöner 之前发现过的相同问题,但他也在尝试采取一些措施——参见博客文章《为 Unity 游戏在 Mono 上实现更好的代码生成》(https://blog.s-schoener.com/2026-03-31-better-mono/)。使用 `Unity.Mathematics.math.sqrt` 的代码生成比上面的好一点点,但并不明显。
**Mono, System.MathF.Sqrt**
```csharp
const int N = 10000000;
public static float UnityMathf(float v)
{
for (int i = 0; i < N; ++i)
{
v += System.MathF.Sqrt(v);
}
return v;
}
```
循环体最终变成了这样:
```asm
loop:
movss xmm0, dword [rbp-0x10] ; xmm0 = v, as float
cvtss2sd xmm0, xmm0 ; xmm0 = (double)v
movsd [rbp-0x18], xmm0 ; save old v as double for later addition
movss xmm0, dword [rbp-0x10] ; xmm0 = v, as float again, argument for MathF.Sqrt
cvtss2sd xmm0, xmm0 ; xmm0 = (double)v
cvtsd2ss xmm0, xmm0 ; xmm0 = (float)(double)v, argument to MathF.Sqrt
nop ; padding / alignment / patchpoint artifact
mov r11, 0x22494ee3918 ; r11 = JIT trampoline address for System.MathF.Sqrt(float)
call r11 ; call MathF.Sqrt(float), argument in xmm0, return float in xmm0
cvtss2sd xmm1, xmm0 ; xmm1 = (double)MathF.Sqrt(v)
movsd xmm0, qword [rbp-0x18] ; xmm0 = saved old v, as double
addsd xmm0, xmm1 ; xmm0 = (double)old_v + (double)sqrt_v
cvtsd2ss xmm5, xmm0 ; xmm5 = final iteration result rounded to float
movss [rbp-0x10], xmm5 ; v = final iteration result
inc esi ; ++i
cmp esi, 0x989680 ; compare i against 10,000,000
jl loop ; if i < N, continue loop
```
而实际 `System.MathF.Sqrt` 函数的汇编代码是:
```asm
xorps xmm1, xmm1 ; xmm1 = 0.0f
ucomiss xmm1, xmm0 ; compare 0.0f with input
ja handlefail ; if 0.0f > input, input is negative: go handle failure/NaN path
sqrtss xmm0, xmm0 ; xmm0 = sqrtss(xmm0), scalar single-precision sqrt
ret ; return sqrt result in xmm0
handlefail:
; some code that handles failures/NaNs
```
实际上相当于:
```csharp
static float MathF_Sqrt_Call(float x)
{
if (0.0f > x) return MathF_Sqrt_SlowPath(x);
return Sse_SqrtScalarSingle(x); // sqrtss 指令
}
// ...
double lhs = (double)v;
double t0 = (double)v;
float sqrtArg = (float)t0;
float sqrtResult = MathF_Sqrt_Call(sqrtArg);
double rhs = (double)sqrtResult;
double sum = lhs + rhs;
float result = (float)sum;
v = result;
```
仍然有一堆 float⇔double 转换!但少了很多,并且现在使用的是标量 SSE 平方根指令,而不是古老的 x87 FPU。
**Burst, UnityEngine.Mathf.Sqrt**
在 Burst 下,`v += UnityEngine.Mathf.Sqrt(v)` 的内循环部分忠实地翻译为:
```asm
vcvtss2sd xmm1, xmm0, xmm0 ; convert float→double
vsqrtsd xmm1, xmm1, xmm1 ; scalar double precision square root
vcvtsd2ss xmm1, xmm1, xmm1 ; convert double→float
vaddss xmm0, xmm0, xmm1 ; float +=
```
即它基本上做了你所期望的事情,给定 `Mathf.Sqrt` 的实现。
**Burst, Unity.Mathematics.math.sqrt**
`v += Unity.Mathematics.math.sqrt(v)` 在 Burst 下翻译为仅仅:
```asm
vsqrtss xmm1, xmm0, xmm0 ; scalar single precision square root
vaddss xmm0, xmm0, xmm1 ; float +=
```
这基本上是你想要发生的事情。不过有点奇怪的是,底层的 `math.sqrt` 代码实际上是 `public static float sqrt(float x) { return (float)System.Math.Sqrt((float)x); }` —— 即没有 Burst 时,它最终会调用双精度函数。但 Burst 给了它某种特殊处理,而对之前的情况却没有,我猜是这样。再次强调,没有在 Burst 下测试 `System.MathF.Sqrt`,因为如果你尝试使用它,它会直接失败。
**IL2CPP, UnityEngine.Mathf.Sqrt**
Unity 的 IL2CPP 脚本后端(https://docs.unity3d.com/6000.3/Documentation/Manual/il2cpp-introduction.html)将 .NET 字节码翻译成 C++,然后依赖常规的 C++ 编译器执行优化。对于 `Mathf.Sqrt` 代码路径,它似乎确实给予了特殊处理——它*不*调用双精度平方根,即使在 C# 层面它确实是双精度的。这与 Burst 的行为*相反*,我猜这是另一个"你实际上是在发布你的组织架构图"的例证。生成的 C++ 代码中的内循环是:
```cpp
float L_0 = ___0_v;
float L_1 = ___0_v;
float L_2;
L_2 = sqrtf(L_1);
___0_v = (float)il2cpp_codegen_add(L_0, L_2); // template function, just + for simple types
```
然后 C++ 编译器(MSVC 2022 v17.14,Release 构建配置)实际上展开了循环,每次迭代执行十个平方根,每个平方根片段如下:
```asm
xorps xmm1, xmm1 ; xmm1 = 0.0f
ucomiss xmm1, xmm6 ; compare 0.0f with v
ja edgecase ; if 0.0f > v: use sqrtf fallback function
xorps xmm0, xmm0 ; xmm0 = 0.0f
sqrtss xmm0, xmm6 ; xmm0 = sqrt(v), scalar single-precision sqrt
jmp end
edgecase:
movaps xmm0, xmm6 ; xmm0 = v, argument for sqrtf
call sqrtf ; call C runtime sqrtf
end:
addss xmm6, xmm0 ; v += sqrtResult
```
这并不是简单的"直接使用 sqrtss",它只对有效输入使用该指令,而对其他输入则调用"完整"函数(大概是为了设置 `errno` 或处理异常)。你可以说这比 Burst 生成的代码优化程度稍低,但在实践中对这个基准测试并没有影响。
**IL2CPP, System.MathF.Sqrt**
对于 `System.MathF`,IL2CPP 的代码生成略有不同:
```cpp
il2cpp_codegen_runtime_class_init_inline(MathF_longGUID_il2cpp_TypeInfo_var);
float L_0 = ___0_v;
float L_1 = ___0_v;
float L_2;
L_2 = sqrtf(L_1);
___0_v = (float)il2cpp_codegen_add(L_0, L_2); // template function, just + for simple types
```
——没错,就是那个 `il2cpp_codegen_`
相似文章
中间浮点精度
本文探讨了C++代码中的中间浮点精度如何依赖于编译器设置、CPU标志和架构,尤其是在x87 FPU上,以及这如何影响性能和计算结果。
更多浮点数替代方案
本文解释了基于软件的各种浮点运算替代方案,包括十进制浮点数、分数、符号计算、区间运算和二进制编码十进制。
将整数除法转换为浮点除法是微不足道的
一篇技术博客文章,解释了如何使用浮点除法和融合乘加来执行整数除法和取余,并给出了操作数位宽的限制,同时讨论了SIMD和舍入模式的实际注意事项。
浮点运算与整数运算遵循两种不同的范式
博客文章指出整数与浮点算术遵循不同范式:整数运算需在灾难发生前预防溢出,而 IEEE-754 浮点运算中的 NaN 与无穷值会自然传播,不应照搬预防式检查(如用零分母或 FLT_EPSILON 守卫),这些检查在多数场景下无效且被 LLM 频繁写错。
次正规浮点数在Intel处理器上开销巨大…
本文基准测试了Intel、AMD和ARM处理器上次正规浮点数的性能,显示Intel处理器在使用次正规数时出现显著减速,而AMD和ARM则不受影响。